要点
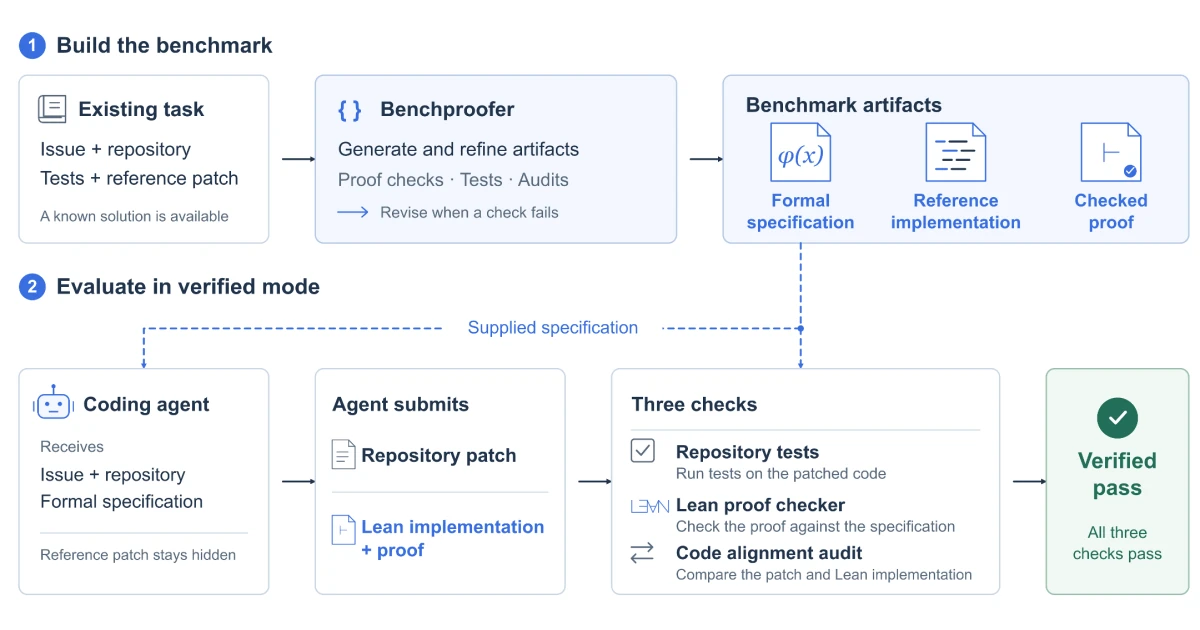
- 2026 年 11 月 16 日,Amazon Science 的 BenchProofer 团队发表《BenchProofer: Formally verified coding benchmarks, on demand》。这款开源工具针对已有参考修复的编程任务,尝试生成三样东西:形式化规格,也就是对正确答案必须满足什么条件的精确、可机器检查的陈述;一份适合做形式化验证的参考实现;以及由验证器检查过的证明,说明该实现满足规格。
- 与工具一并发布的是 SWE-Proof。它把上述规格、实现和证明,加到 SWE-Bench Verified 的全部 500 道题上。SWE-Bench Verified 是一套常用的真实 GitHub 修错任务,用来给编程智能体打分。
- 在测试中,审计把 Claude Opus 4.8 已通过测试的补丁里近三分之一标了出来,理由是其行为与参考修复不一致。在随后的人工复核样本中,被标记补丁里约一半,也就是 41 个里的 21 个,存在真正的缺陷。
- 当智能体被提供 BenchProofer 的规格时,通过严格核验的比率上升:Claude Opus 4.8 从 84.6% 升到 93.6%,GPT-5.5 从 79.6% 升到 94.4%。文章认为这件事重要,因为基准分数既用来选工具,也越来越多地在公司用强化学习继续训练智能体时,充当奖励信号。
- 这套方法仍需已知的参考解来生成规格,并靠人工复核样本来解释自动标记。Amazon 的评估由开发该工具的团队自己运行。
2026 年 11 月 16 日,Amazon Science 发布开源工具 BenchProofer,试图补上行业给编程智能体打分时一个不大被提起的弱点。今天,只要智能体的补丁通过一组测试,一道题通常就算做对。BenchProofer 团队写得直接:智能体可以过掉所有测试,却在测试没覆盖到的输入上仍然出错。它也可以学会钻测试的空子,而不是真正解决问题。
如果这些数字只留在排行榜上,这还可以看成计量上的抱怨。作者认为情况已经不是这样。公司用这些分数做产品决策,并且越来越多地在用强化学习继续训练智能体时,把它们当作奖励信号。如果分数是错的,训练就可能奖励错误行为。
[1]BenchProofer 从一道已有已知参考修复的任务出发,尝试生成三样东西。第一是形式化规格:用机器能够检查的方式,精确说明正确解必须做什么。文章里的简单例子是,一个找列表最大数的函数,返回值必须属于该列表,且不能有任何元素比它更大。第二是参考实现,写在验证器能够处理的语言里,例如 Lean。第三是证明,说明在既定假定下,这份实现满足规格,再由验证器检查。测试和审计则用来核对,经过验证的实现仍与仓库里的原代码对应。
Amazon 同时发布 SWE-Proof,把这些产物加到 SWE-Bench Verified 的全部 500 道题上。这是一套来自 GitHub 仓库的真实修错任务。公开的目的,是让其他实验室也能跑更严格的检查,而不只是阅读 Amazon 自己的分数。
测试只覆盖出题人想到的输入。形式化规格试图说出所有相关输入都必须满足的条件,再用验证器检查参考实现是否满足这些条件。这并不能消灭规格写错的可能,但它改变了检查的对象:从这组测试过了没有,变成在规格所覆盖的范围内,性质是否成立。
[1]真正应改变排行榜读法的,不是一项新的最高分,而是已经通过测试的补丁里,错误有多常见。在 Amazon 的研究中,审计标出了 Claude Opus 4.8 已通过测试的补丁中的近三分之一,因为它们的行为与参考修复不一致。自动标记并不等于已确认的缺陷。在随后由人工复核的样本里,被标记补丁约有一半,也就是 41 个里的 21 个,存在真正的缺陷。其余标记在该样本中未被确认为缺陷。这是这套审计的限度,不是忽视已确认缺陷的理由。
团队还报告,当智能体在测试之外还拿到规格时,在更严格的标准上表现更好。Claude Opus 4.8 的核验通过率从 84.6% 升到 93.6%。GPT-5.5 从 79.6% 升到 94.4%。这个结果有用,但应读得窄一些。它说明,更清楚、可机器检查的任务说明对这些智能体有帮助。它并不能说明,在没有这份规格时,普通的 SWE-Bench Verified 分数测量的是同一件事。
[1]一种公道的反对意见是,形式化方法以前就承诺过要取代测试,面对杂乱的真实仓库时,往往成本过高。BenchProofer 并不声称只凭一份缺陷报告就能工作。它需要参考解来生成规格,因此它是在加固现有基准,而不是在新任务上普遍替代测试。评估由 Amazon 自己运行。人工复核覆盖了 41 个被标记补丁,不是全部被标记集合。有些标记可能是规格不一致,而不是用户能察觉的缺陷。这些限度在文章里并没有被藏起来,而公开的 SWE-Proof,正是让别人可以反驳这一结果的正确方式。
[1]这些限度,并不能保住把「通过测试的补丁」当作干净进度单位的习惯。如果一个较强模型已通过测试的补丁里,有近三分之一被标记,而复核样本里又有一半是真正的缺陷,那么 SWE-Bench Verified 上一个百分点的变动,信号要比排行榜的排版看起来更弱。如果同样的分数还被当作训练奖励,这个弱点会更严重。一个学会通过测试的智能体,可能因为补丁在未测试输入上仍然出错,却照样得到奖励。
未来六个月要看的,是 SWE-Proof 会不会成为 SWE-Bench Verified 旁边的第二个数字,以及其他实验室能否在同一 500 道题上,复现「近三分之一」的标记率,或相近的人工确认缺陷率。如果复现没有出现,Amazon 交付的就是一件有用的工具,外加一个由供应商自己跑出来的警告。如果复现出现了,给编程智能体打分的默认方式,就需要加一条限定:仅靠测试,还不能判定修复已经完成。
如果公司把通过测试当作强化学习里的奖励,智能体就有动机去找测试的缝,而不是把缺陷修完。SWE-Proof 并不能单独堵住这条路,因为它仍然依赖已有参考解来生成规格。它能做的,是让已经在用的基准更难被混过去。
排行榜的读者不必等到 SWE-Proof 成为行业默认,才能改读法。只要承认「通过测试」和「修复完成」不是同一件事,一个百分点的升降就该写得更慢,尤其是当同一数字还可能进入训练流程的时候。 这并不要求读者接受形式化方法会取代测试。它只要求读者不再把通过测试的补丁,直接读成已经完成的修复。
[1]