
要点
- Apple ML Research(2026年11月)提出在真机虚拟 iOS 上做在线稠密 RL:规划 agent 与 UI grounding 解耦,LLM-as-a-Judge 给逐步稠密奖励 + 终局奖励,PPO 做逐步优势;并提出 GiGPPO(感知哈希邻居条件价值估计)。
- 热启动自 Qwen3-VL-8B-Instruct 的 SFT;grounding 用内部 3B(位置滑动交给 Gemini-3.5-Flash);训练基建可并行数百台虚拟 iOS(最高约 512 条轨迹)。
- UINavBench:SFT 16.7% → PPO Step 336 为 32.4%,追平 Gemini-3.1-Pro、超过 Gemini-3.5-Flash(28.4%)与 Qwen3.8-27B(19.6%);AndroidWorld OOD:4.7% → 32.8%(近 7×)。
- 稠密奖励加速收敛:标准 PPO Step 168 已约等于终局-only PPO Step 336;iOSWorld 提升有限(合成 App + 个性化 OOD);前沿模型在 Android 仍明显更高。
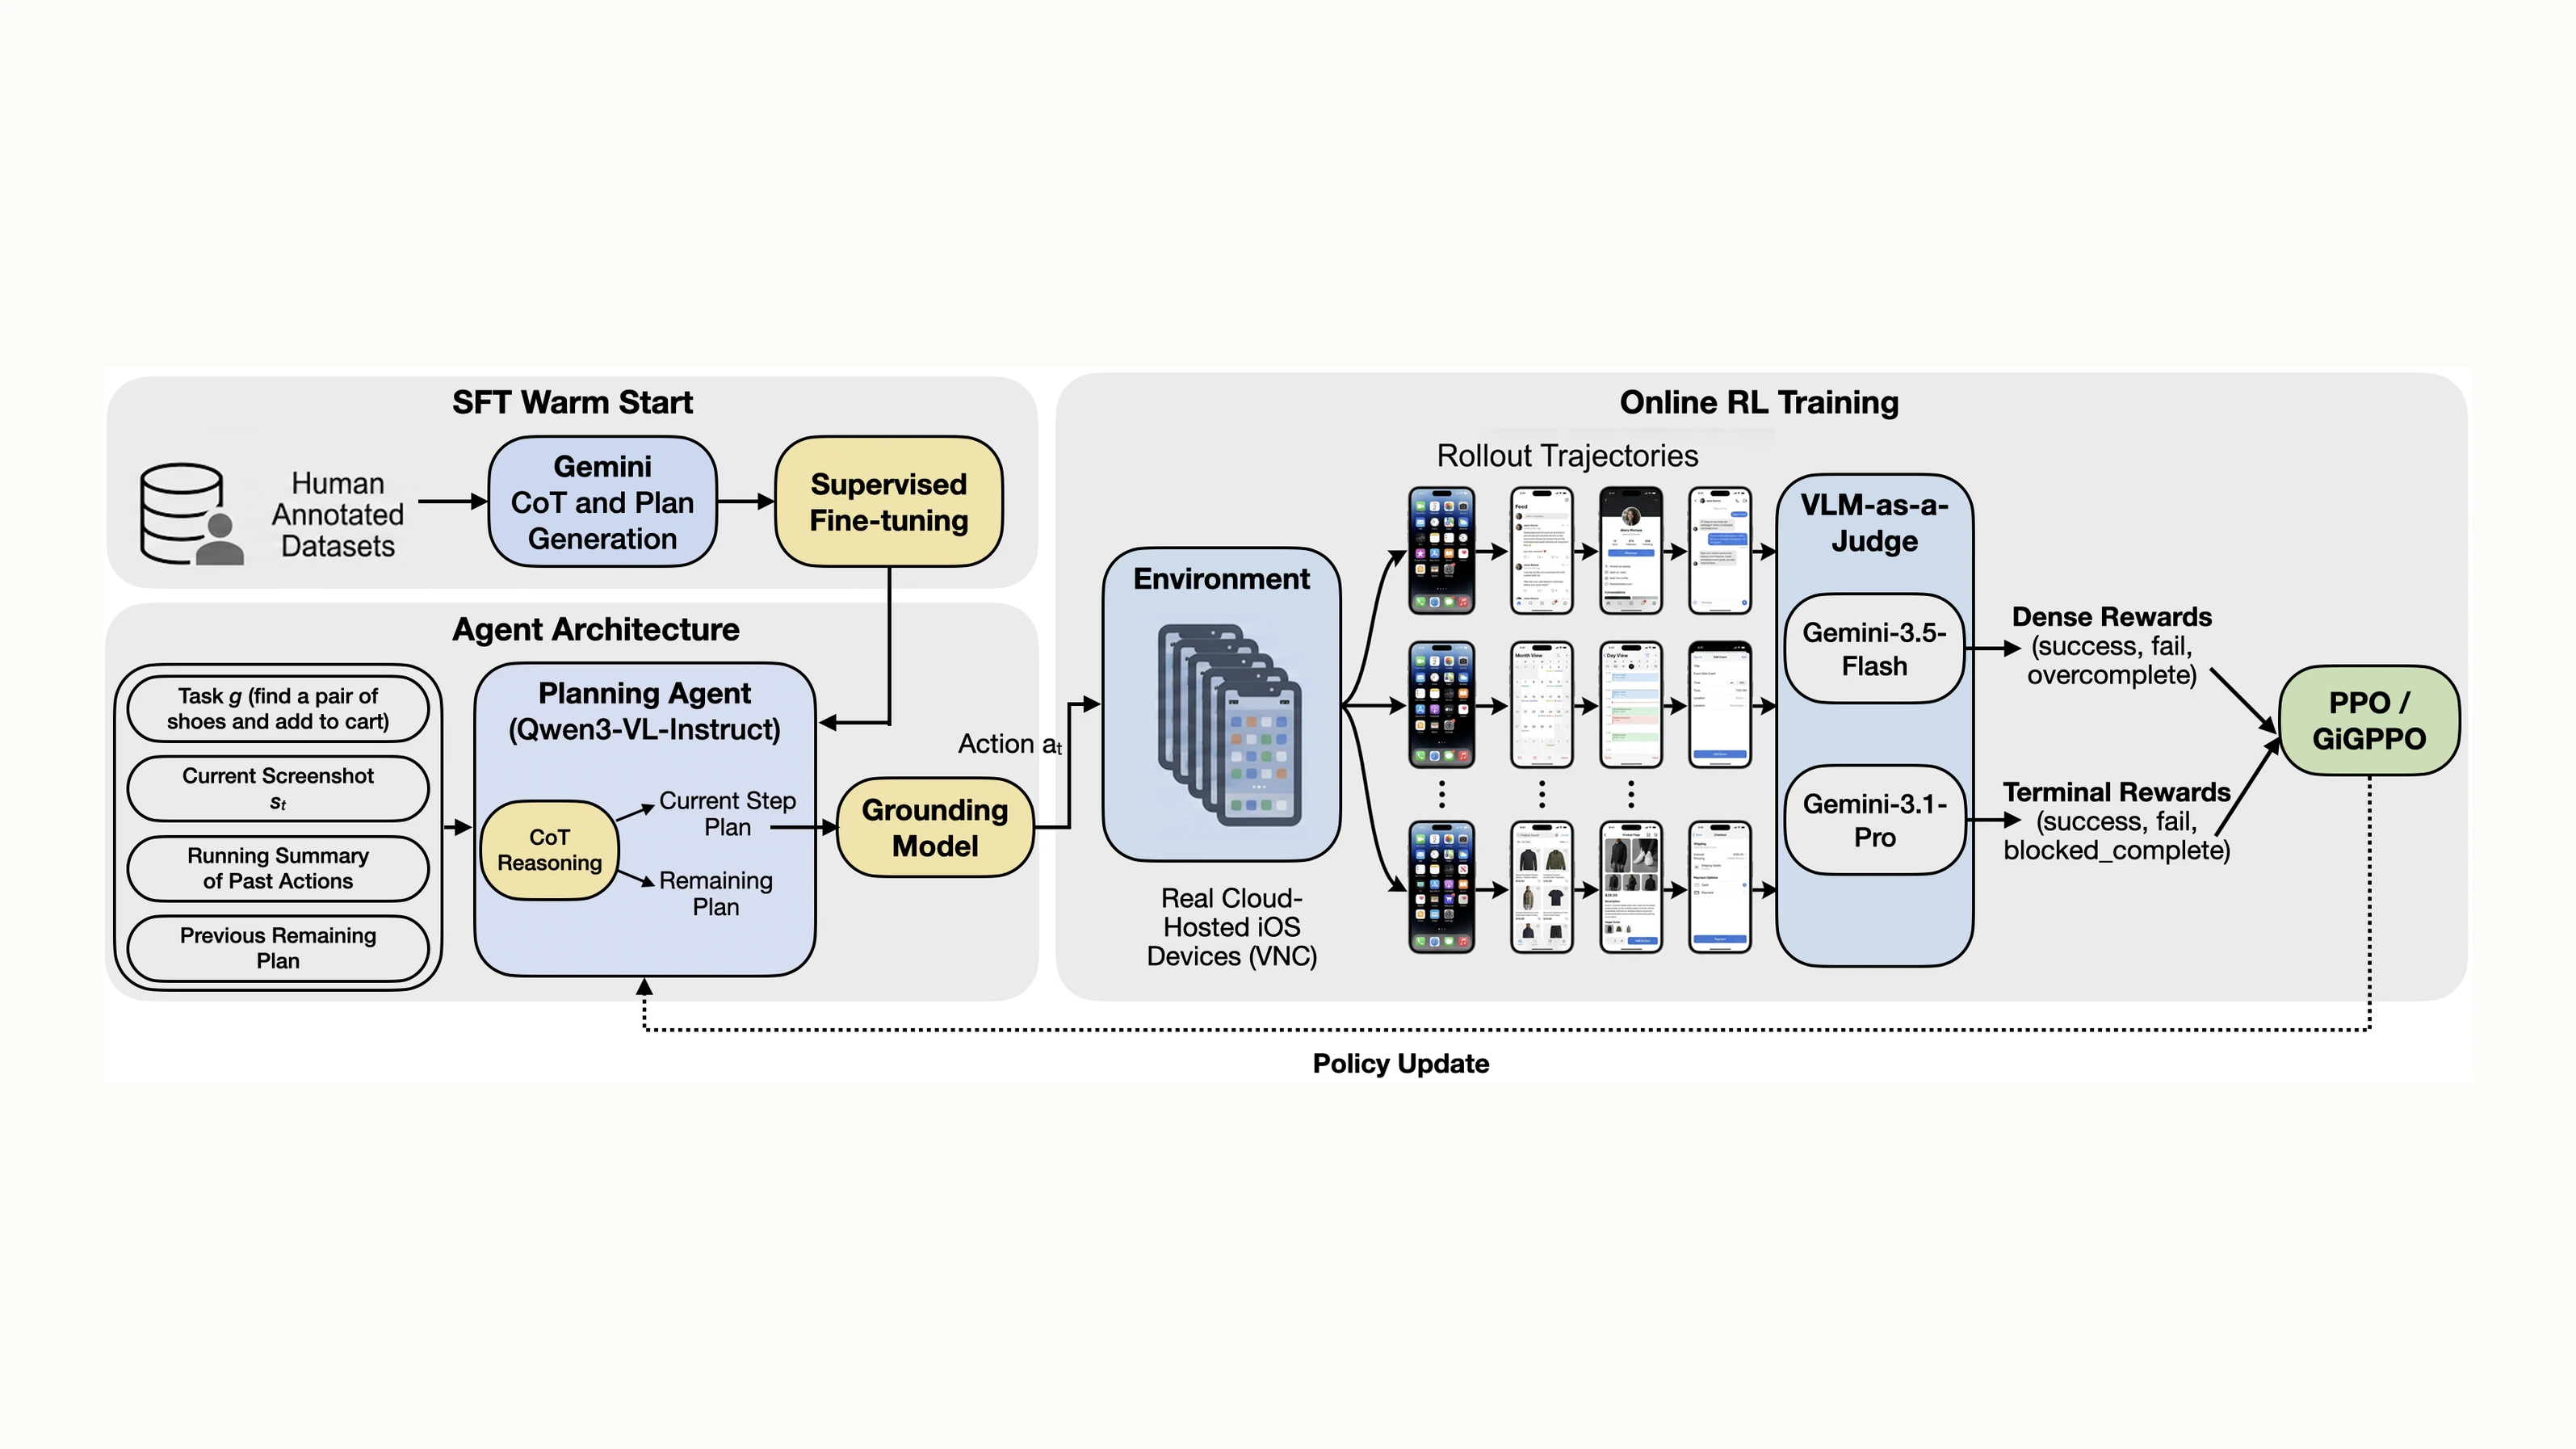
2026年11月,Apple Machine Learning Research 发表论文《Online Dense Reinforcement Learning with Planning-Grounding Agent for UI Navigation on Live iOS Apps》(arXiv:2610.39264;作者 Peitong Duan*、Khashayar Gatmiry*、Jeff Nichols、Emmanuel Abbe、Samy Bengio)。中心判断并不暧昧:frontier VLM 能做 UI 导航,但按任务计费对日常使用太贵;小模型靠 SFT 或离线 RL 又容易背静态轨迹、遇错难回。作者的回应是把系统拆成 Planning agent + UI Grounding,只对规划侧做昂贵在线 RL,并在上百台并发的真机虚拟 iOS上,用 LLM-as-a-Judge 同时打出逐步稠密奖励与终局奖励。在 UINavBench(真机 iOS App)上,8B PPO 检查点追平 Gemini-3.1-Pro;在从未用 Android 做 RL 训练的 AndroidWorld 上,相对 SFT 成功率为近七倍。
[1][2]发生了什么
架构刻意不把「想做什么」和「点哪里」绑在同一个要 RL 的模型上。Planning agent 看截图与历史,输出带 chain-of-thought 的当前步与剩余计划;Grounding 模型把该步映射为 Tap / Swipe / Text_Entry 等原语与坐标。作者的理由是:grounding 更接近可被 SFT 解决的确定性映射,而规划需要开环推理与纠错——因此 RL 预算留给规划,grounding 冻在 SFT(内部 3B,位置滑动路由到 Gemini-3.5-Flash)。动作空间还包含 Ask_User,用 Gemini 模拟未充分指定任务时的用户答复。
奖励不是终局一锤定音。稠密裁判(Gemini-3.5-Flash)逐步判定 success / fail / overcomplete,惩罚幻觉推进与空转循环;终局裁判(Gemini-3.1-Pro)用末三帧截图与动作史判定 success / fail / blocked_complete。优化用 PPO + 逐步 GAE:稠密通道 γ_dense=1/2,终局奖励不打折扣,以避免「靠拉长轨迹刷逐步分」的 reward hacking。GiGPPO 进一步用同任务并发轨迹中感知哈希最近邻的回报,经 MLP 条件化 critic,缓解「屏幕几乎不精确复现、精确状态分组退化成单例」的问题。基建侧用云端虚拟 iOS + 快照回滚,宣称可同时跑数百条轨迹(文中写到 512)。
[1][2]证据有多硬
主表(Table 1)把主张钉在可核对数字上。UINavBench(116 题 / 36 个真机 iOS App):SFT 基线 16.7%;PPO Step 336 为 32.4%,与 Gemini-3.1-Pro 同值,高于 Gemini-3.5-Flash 28.4%、Qwen3.8-27B 19.6%。AndroidWorld(OOD,RL 阶段未训 Android):SFT 4.7% → PPO Step 336 32.8%——文中强调近七倍,说明学到的不只是 iOS 轨迹背诵。iOSWorld 更克制:GiGPPO Step 336 到 9.8%(SFT 4.5%),多数检查点仍远低于前沿(Gemini-3.1-Pro 39.5%)。
消融同样具体:终局-only PPO 在 Step 336 才到 UINavBench 21.6% / AndroidWorld 19.8%;带稠密奖励的 PPO 在 Step 168 已达 25.5% / 20.7%,作者概括为稠密信号约把同等表现提前一个 epoch。GiGPPO 在更贴近训练分布的 UINavBench 上,早期步数(75、168)常追上更晚的标准 PPO,支持「邻居条件价值估计加快收敛」的机制叙事。前沿模型在 AndroidWorld 仍明显高于 RL 检查点(Gemini-3.1-Pro 60.8%)——负结果与正结果写在同一张表里。
[2]钢人与缺口
钢人:把规划与 grounding 拆开、只对开环推理做在线 RL,在算力与稳定性上是诚实的工程选择;稠密逐步裁判解决了「终局稀疏、中间有效步拿不到分」的经典痛点;非对称折扣直接对准「刷步数」的失败模式;真机并发基建让在线交互不再是玩具规模。与同期 ClawGUI-RL 的对照也写进了相关工作:对方端到端、Android 模拟器、约 64 并发;本文强调解耦、经 critic 路由的邻居信号、以及数百台真机 iOS。
缺口同样刺眼。iOSWorld 是合成 App + 大量个性化 / 多 App 工作流,相对训练分布 OOD,作者自己记录后期检查点会把合成 App 名撞到真 App 或当成网页去 Safari 搜。AndroidWorld 上前沿优势,文中承认可能部分来自公开 Android UI 数据在预训练中更充裕,而公开 iOS 数据稀缺——于是「追平 Gemini-3.1-Pro」主要成立在真机 iOS 板,而非跨生态全面反超。裁判与 Ask_User 均依赖 Gemini 家族,存在奖励模型与评测模型同源的风险;SFT 热启动的 CoT / 剩余计划标签也由 Gemini 生成。这些不是小节省略,而是主张外推时必须带着走的边界。
[2]谁付钱、谁该改问题清单
对产品与平台:若日常代理的账单被 frontier 每步推理吃掉,路径未必是「再换一个更大的规划器」,而是能否在真环境上拿到稠密过程监督,并把 RL 花在会纠错的那一层。对训练团队:终局-only 与稠密 PPO 的 epoch 对照,给出可执行的实验纪律——没有逐步进度信号,多训一倍步数也买不回同样收敛。对评测社区:UINavBench / iOSWorld / AndroidWorld 三板并读,才能避免把「真机 iOS 追平」误读成「合成个性化或 Android OOD 也已追平」。对采购与内部试点:应追问训练是否在线、奖励是否逐步、grounding 是否与规划同训、以及裁判模型是否与对外展示的评测同源。
[1][2]六个月看什么
可证伪的下一跳很具体:在不依赖 Gemini 家族作稠密裁判、或换独立过程奖励模型时,8B 级解耦 agent 是否仍能在 UINavBench 维持与 Gemini-3.1-Pro 同档;在合成个性化板(iOSWorld)与 Android OOD 上,稠密在线 RL 能否继续收窄与前沿的差距,而不是只在训练分布最近的真机 iOS 上发光。基建与并发规模会被复现者反复核对——「数百台真机虚拟设备」若不可得,故事会缩回模拟器。主张不是「小模型已经赢了 frontier」,而是:对日常 UI 导航,在线稠密奖励 + 规划/接地分工,可能比单纯加大规划器更接近账单可承受的能力曲线。
[1][2]