
要点
- Hugging Face 博客(2026-11-02,sirluk)对「Sliding-window beats linear attention」论文做等内存蒸馏对照:四名学生均从 Qwen3-4B-Instruct 起步,每层预算等价 576 个缓存 token。
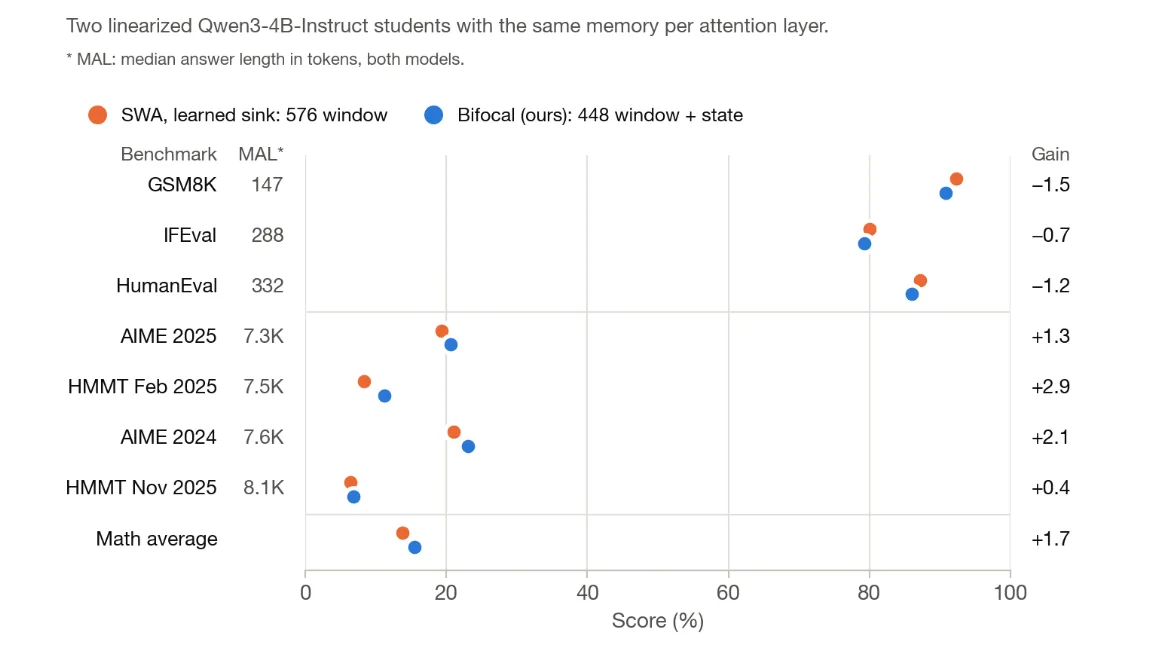
- 短答基准上 SWA(learned sink)领先 Bifocal 约 0.7–1.5 分;作者同意 SWA+sink 是强而便宜的基线。
- AIME/HMMT 等长答数学:平均答案约 7600 token;96 道长答题上 Bifocal 解出约 1.8 倍;>4000 token 正确答卷 66 vs SWA 26。
- 把几乎全部预算给线性状态、窗口只留 64:数学掉到 4.2%(Bifocal 15.5%)——近期精确回忆仍不可少。vLLM 解码 Bifocal≈SWA ~195 tok/s 至 128K。
推理模型把答案写得很长时,KV cache 按 token 线性膨胀:博文估算 Qwen3-4B 每个 token 约 144 KiB,一万 token 答案就要约 1.4 GiB。固定内存只有两条路——忘掉旧 token(滑动窗口),或把过去压成定长状态(线性注意力 / Mamba / GDN / mLSTM)。
一篇近期论文主张:带 attention sink 的滑动窗口 alone 就够,甚至在多项基准上打赢多数线性化模型。Hugging Face 上 Lukas(sirluk)的跟进实验给出更窄、可证伪的结论:等内存条件下,SWA 在短答上确实够强;但一旦模型要自己写出数千 token 的推理链,窗口加线性混合器的 Bifocal 才拉开差距。
[1]发生了什么
作者把 Qwen3-4B-Instruct 的 36 层注意力全部替换,蒸馏同一套约 41 亿 token 配方,并按 BF16 KV 等价把线性状态折算进缓存预算。四名学生:576-token SWA(learned sink);572-token SWA + 4 个 sink token;Bifocal(448-token 窗口 + 每 KV 头一个 mLSTM 状态,合 128 token);以及「窗口 64 + 每 query 头一状态」的 Bifocal 变体。
Bifocal 用逐头、数据相关的门把 mLSTM 与 SWA 输出混合——近处精确、远处低分辨率,像双光眼镜。对照故意加强 SWA:不是训练免费剪裁,而是与线性化同预算后训练,给堆叠窗口传递信息的机会。
[1]证据有多硬
短答(GSM8K / IFEval / HumanEval 一类):SWA 全面领先 0.7–1.5 分——提示与回答多半仍落在窗口内,压缩状态很少被用到;SWA 也更接近教师结构,蒸馏起步更顺。
硬数学:AIME 2024/2025 与 HMMT 2025(各 30 题,每题 16 样本,pass@1)。平均答案约 7600 token,任一步窗口只覆盖约 8%。总分 Bifocal 15.5% vs SWA 13.8%,配对 bootstrap 95% 区间贴着 0.0–3.4 点;按答案长度分组后:短答双方约 59%,96 道长答题 Bifocal 约 1.8 倍;单条 rollout 上 >4000 token 正确答 66 vs 26。窗口 64 的 Bifocal 数学仅 4.2%。速度上,替换 Qwen3.5-4B 全部注意力/GDN 后,Bifocal 与 SWA 解码都稳在约 195 tok/s(至 128K),prefill 慢约 17–37%。
[1]钢人与缺口
钢人:SWA+sink 便宜、可复现,每个线性化论文都应报告;多数生成/长上下文对照里的线性模型只在 0.2–6 亿 token 小预算上 retrofit;许多「长上下文」其实是长输入短输出;HellaSwag 类 log-likelihood 从不读模型自己写的东西——64-token 窗口能收回 99% 并不证明远距记忆。
缺口:数学总差距统计边缘,依赖长度分层才清晰;教师与数据(Nemotron 混合)固定,外推到更大模型或原生线性预训练未证;sink-token SWA 在超缓存 prompt 上评估代码有坑,作者只报了数学;GPQA 因长度截断被明确搁置。堆叠窗口「理论感受野」≠ 有效感受野——文中引用约 1.5 个窗口的有效范围,仍是机制论证而非独立复现。
[1]谁付钱、下一步看什么
付钱的是推理服务与长链训练:若产品答案动辄数千 token,只看短答或选择题就选纯 SWA,可能在 KV 预算打满时输掉正确率。构建者应报告等内存对照,并把生成长度写进评估设计。
六个月内值得盯:更多团队是否在长生成集上重跑「SWA vs 线性」;Bifocal 式门控混合是否进入主流 serving 内核;以及预训练原生混合架构(而非只做线性化蒸馏)会否改写同一结论。
[1]收束
「滑动窗口打败线性注意力」在短答与似然基准上站得住,也值得当基线。但若你的瓶颈是模型写长推理时的 KV,等内存证据指向另一句更窄的话:窗口负责近处精确,线性状态负责跨过窗口的摘要——两者同预算并用,才在长答数学上拉开差距。
[1]