
要点
- FLUX 3 Image Klein(Black Forest Labs):Qwen3-VL-4B-Instruct 文本条件、DiT 潜变量、自编码器;Base(50 步,CFG 3.5)与蒸馏版(16 步,无 CFG)。
- 单卡 B200、2048x2048、NVFP4:去噪约占 Base T2I 的 96.8%(14.24 s/14.70 s)。
- Cache-DiT(阈值 0.24):2048x2048 上 Base T2I 约 1.94x,LPIPS 0.033;VC-Attention FP8 约 1.18x,LPIPS 0.086。
- 单卡组合栈:相对未编译 BF16,T2I 22.36->6.46 s(3.46x),I2I 54.64->12.28 s(4.45x)。
- 8xB200:Base 中位 T2I 14.90->3.00 s;去噪 6.01x,但蒸馏版端到端受非去噪占比限制。
NVIDIA 开发者博客把 FLUX 3 Image Klein 放进 TensorRT LLM VisualGen,在 Blackwell GPU 上逐步加速。软文案是「生成更快」。测出来的故事更硬。2048×2048 时,DiT 去噪几乎吃掉 Base 全部延迟,因此每一档认真加速,都是在感知差异(LPIPS)与墙钟时间之间谈预算。 内核融合有用。它消不掉保真账单。
[1]实际发布了什么
FLUX 3 Image Klein 由 Black Forest Labs 推出、在 GB200 NVL72 上训练:Qwen3-VL-4B-Instruct 做文本条件,扩散 Transformer refinement 潜变量,自编码器解码/编码。VisualGen 支持 BF16、FP8、NVFP4,并用 YAML 配置注意力、Cache-DiT、CFG/Ulysses 并行与 CUDA Graphs。
单卡 B200、NVFP4、VANILLA 注意力与 torch.compile 的管线计时显示:去噪占 Base T2I 96.8%、Base I2I 97.8%;蒸馏版仍有 84-89% 花在去噪。后文因此集中打 DiT 成本。
NVFP4 权重配 FlashInfer PrimsTS GEMM(含 SwiGLU、QKV+RoPE 融合)相对 BF16 最高约 1.62× T2I/1.58× I2I,相对自调 TensorRT LLM NVFP4 GEMM 的 T2I 再约 1.02-1.10×。
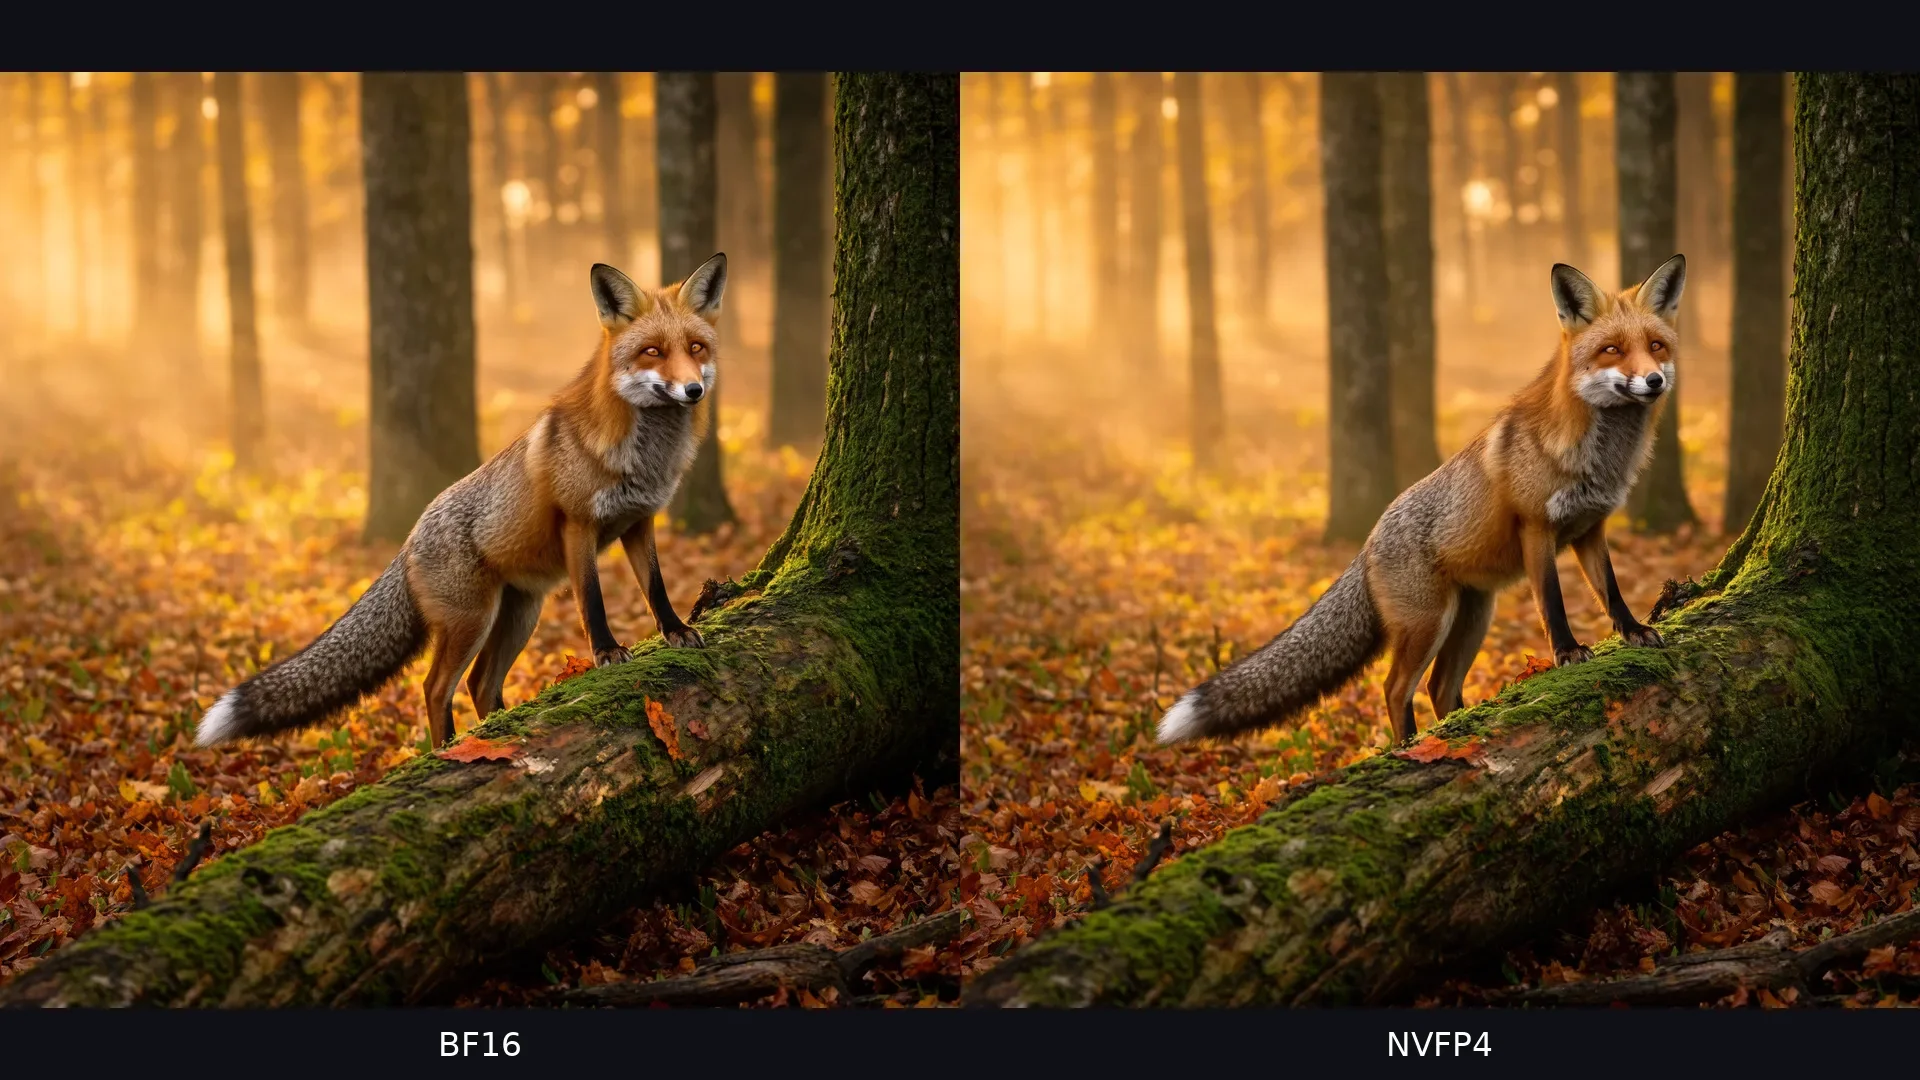
量化注意力:cuDNN FP8 约 1.08-1.09×,LPIPS 0.072/0.161(Base/蒸馏)。VC-Attention FP8(修复预算 ρ=0.005)约 1.18×/1.16×,LPIPS 0.086/0.151。文中建议 2048×2048 B200 用 VC-Attention。Sol-Attention(τ=1.0)在 16 步初始稠密时 1.24×,12 步时 1.30×;更高 τ 伤画质、加速有限。
Cache-DiT 在残差差低于阈值(文中 0.24)时复用中间输出。Base T2I 在 1024 与 2048 近乎减半(1.97×/1.94×,LPIPS 0.038/0.033);蒸馏版增益较小(1.26×/1.20×)。
多卡:Base 用 CFG 分支(cfg_size: 2)加 Ulysses 切序列(ulysses_size: 4);蒸馏版只用 Ulysses。八卡 B200、2048×2048 上,Base 中位 T2I 从 14.90 s 到 3.00 s,蒸馏版从 2.73 s 到 1.08 s。去噪加速 6.01×/4.44×,但八卡蒸馏约一半时间仍在去噪外。1024×1024 上 CUDA Graphs 再把八卡编译延迟砍约 2.2×。
单卡相对未编译 BF16 VANILLA,编译 + NVFP4/PrimsTS + Sol-Attention + Cache-DiT 达到 Base T2I 3.46×、I2I 4.45×;蒸馏最高约 2.34×。RTX PRO 6000 Blackwell Server Edition 相关栈约 1.73-3.25×。示例 T2I 阶梯累计 LPIPS 到 Cache-DiT 阶段约 0.095。
[1]台面上的证据
延迟与 LPIPS 均为 NVIDIA 自报(常见为 2 次预热后 10 次请求均值,seed 0),平台为 B200/DGX B200/RTX PRO 6000。文中给出 YAML 与容器标签便于复现栈本身。未声称第三方实验室复现;LPIPS 是感知代理,不是人类偏好研究。
[1]钢人与缺口
钢人。 生产图像工具活在延迟 SLA 下。每个优化旁同时公布 LPIPS,比只报速度更诚实。把去噪占比与端到端拆开,也解释了为何八卡蒸馏收益会变钝。
缺口:厂商在自有软硬件上的基准。博客图上过关的 LPIPS,品牌或印刷流程可能不收。Sol-Attention 的稠密步截止依赖调度。提示上采样未计入延迟。多图编辑与非 2048 尺寸要另开预算。
[1]谁该在意,下一步看什么
要上线 FLUX 3 的应用团队应先定 LPIPS(或人工)上限,再按序打开 NVFP4、注意力模式与 Cache-DiT。基建在为蒸馏版买八卡加速前,应先看非去噪占比。模型方应预期部署博文把质量差额当成一等指标。
未来六个月看:VisualGen 默认是否钉死 VC-Attention 或 Sol-Attention;BFL 是否发布对得上的质量卡;竞品运行时是否引用同一 LPIPS 协议。
[1]收束
耐看的句子不是「Blackwell 让 FLUX 3 变快」。而是高分辨率 DiT 服务已变成保真预算谈判:VisualGen 的主要杠杆都同时报出加速比与 LPIPS 账单。 六个月后,要么产品看板把这张账单当发版门槛,要么「快 3.5 倍」演示继续漂离用户真正肯收的图。
[1]