
Cartesia Research 的博客把这篇标成 2026 年 10 月 28 日,没有印钟点。主题板把条目记在当天 17:53:06(UTC),换算成北京时间是 10 月 29 日 01:53,早于这一版窗口,晚于回补截止。标题是从 token 到字节的第一篇,讲层级网络的缩放。页面写,层级网络去年已经以论文和博客介绍过,是一种端到端、按多层抽象建模的结构。这一篇给的是新的计算对照,不是第一次公布这个名字。
[1]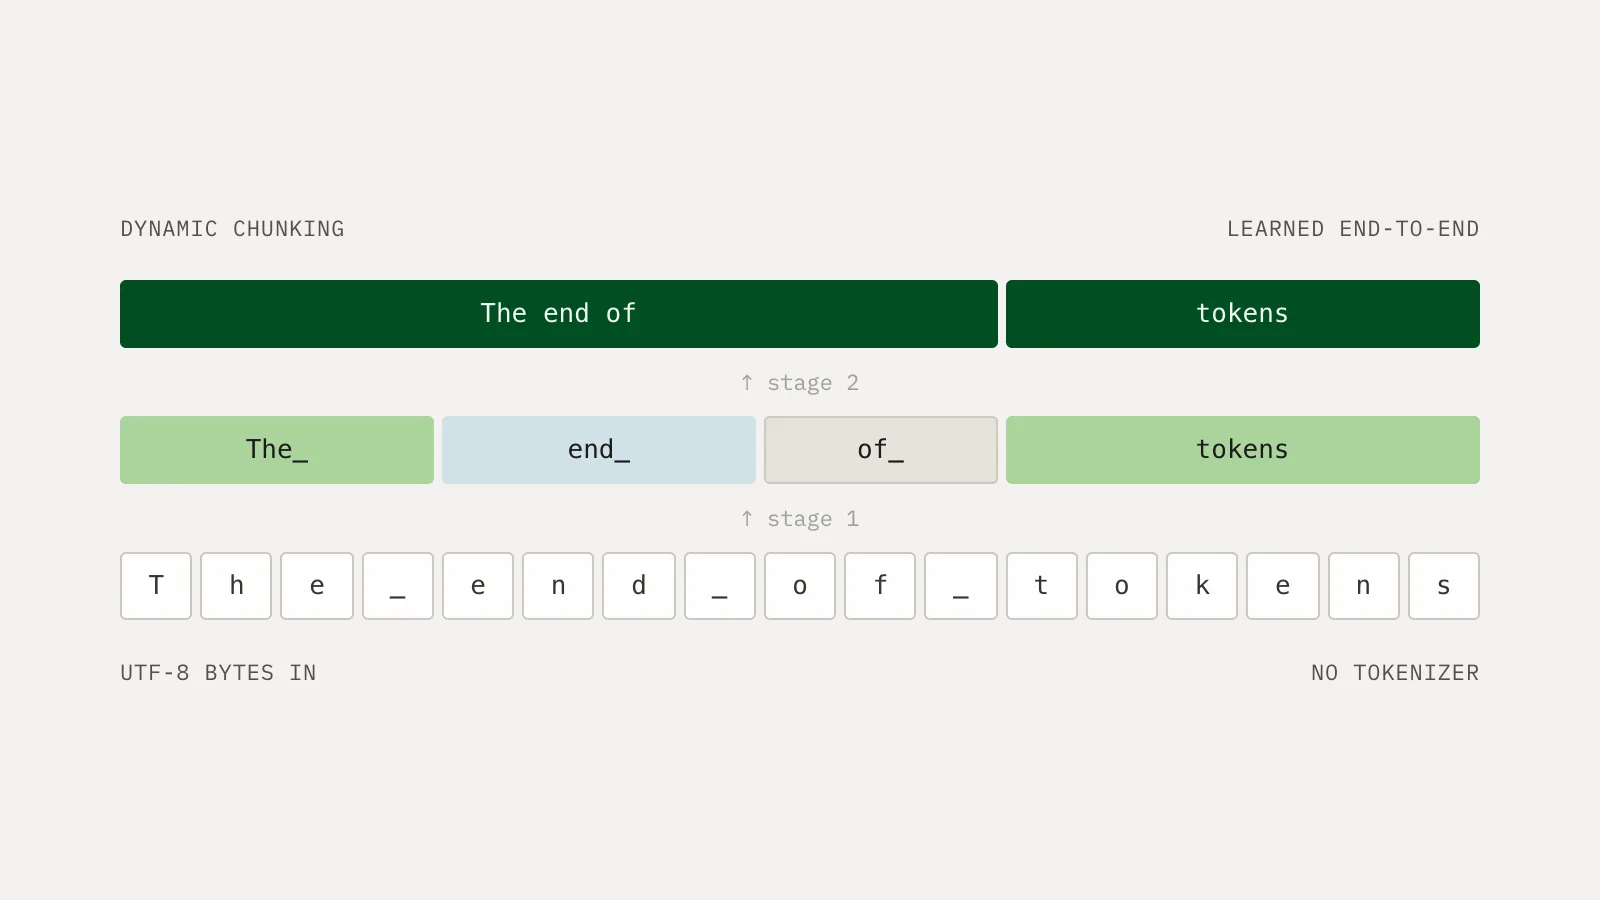
对照怎么搭,写在图 4 附近。BPE 阶梯上的一档被换成字节级的一级 H-Net。主干架构相同,两边都跑在大约 4.5 字节的单位上。H-Net 外面的网络替换原来的分词层,参数量和 FLOPs 与分词层对齐。页面另写,在他们的数据混合上,每个 BPE token 大约覆盖 4.57 字节。4.5 和 4.57 分属两句,一个写单位,一个写这套数据上的压缩。
[1]域内的数有两句,不宜并成一句。拟合计算到损失的幂律之后,页面写 H-Net 比 BPE Transformer 的计算效率高 1.28 倍。图注写,在留出的预训练数据上,H-Net 用少 22% 的计算达到 BPE Transformer 的损失,指标是 validation bpb。1.28 倍和少 22% 都印在这一节。页面还写,阶梯上的每一档,H-Net 的损失都低于配对的那一档 BPE Transformer。
[1]下游是另一套放大。页面点名 Paloma 和 OLMES,各自混合了几十个数据集和任务。他们把软准确度测成模型分给正确答案的 bits-per-byte,再为每套重新拟合缩放律。差距进一步拉到大约 2 倍。大约 2 倍写的是这两套下游,不是域内的 1.28 倍。
[1]开篇还有两个更大的说法,对照对象不同。一级 H-Net 在严格控制下,仅靠学出来的分词,计算效率提升最多 3 到 5 倍。更灵活的二级 H-Net 放大之后,胜过一个匹配的开源模型,计算和数据少 10 倍。那句没有写出开源模型的名字。3 到 5 倍、大约 2 倍、1.28 倍、少 22%、少 10 倍,页面没有收成一个数。Llama-3 的 12.8 万词表只出现在解释 BPE 词表可以有多大的例子里,不是这场对照的对象。
[1]博客没有写的,是钟点、10 倍那句里的模型名字,以及一份把 1.28 倍和 3 到 5 倍对上的算式。配图是文章封面的分层示意:字节在下,两级色块往上合成更长的片段。效率的倍数在正文和图 4,不在这张封面的色块上。
[1]外面的网络在参数量和 FLOPs 上与分词层对齐,这句写的是对照怎么配平,不是一份外部榜。阶梯上每一档的损失都更低,页面把它读成动态分词胜过静态分词。后文指向下一篇,要看更多模型,以及这种效率为什么出现在语言建模里。生物和视觉只在摘要里被写成进行中的工作,没有数字。
[1]