
Anthropic 发表了一篇研究说明,题目是智能体如何影响专家做判断。页面日期是 Oct 27, 2026。作者是 Amaç Herdağdelen、Hailey Joren 和 Alex Tamkin。页面写,他们请有因果推断经验的专业分析师用 Claude Code 做一份统计分析,看专家是不是仍自己做关键决定。任务设在一个虚构的农场合作社:一项自愿、付费的咨询服务要不要扩大。分析师要在四个都说得通的选项里做选择,例如用每公顷产量还是用单位运营成本的产量来衡量生产力,然后再给出最终建议。
[1]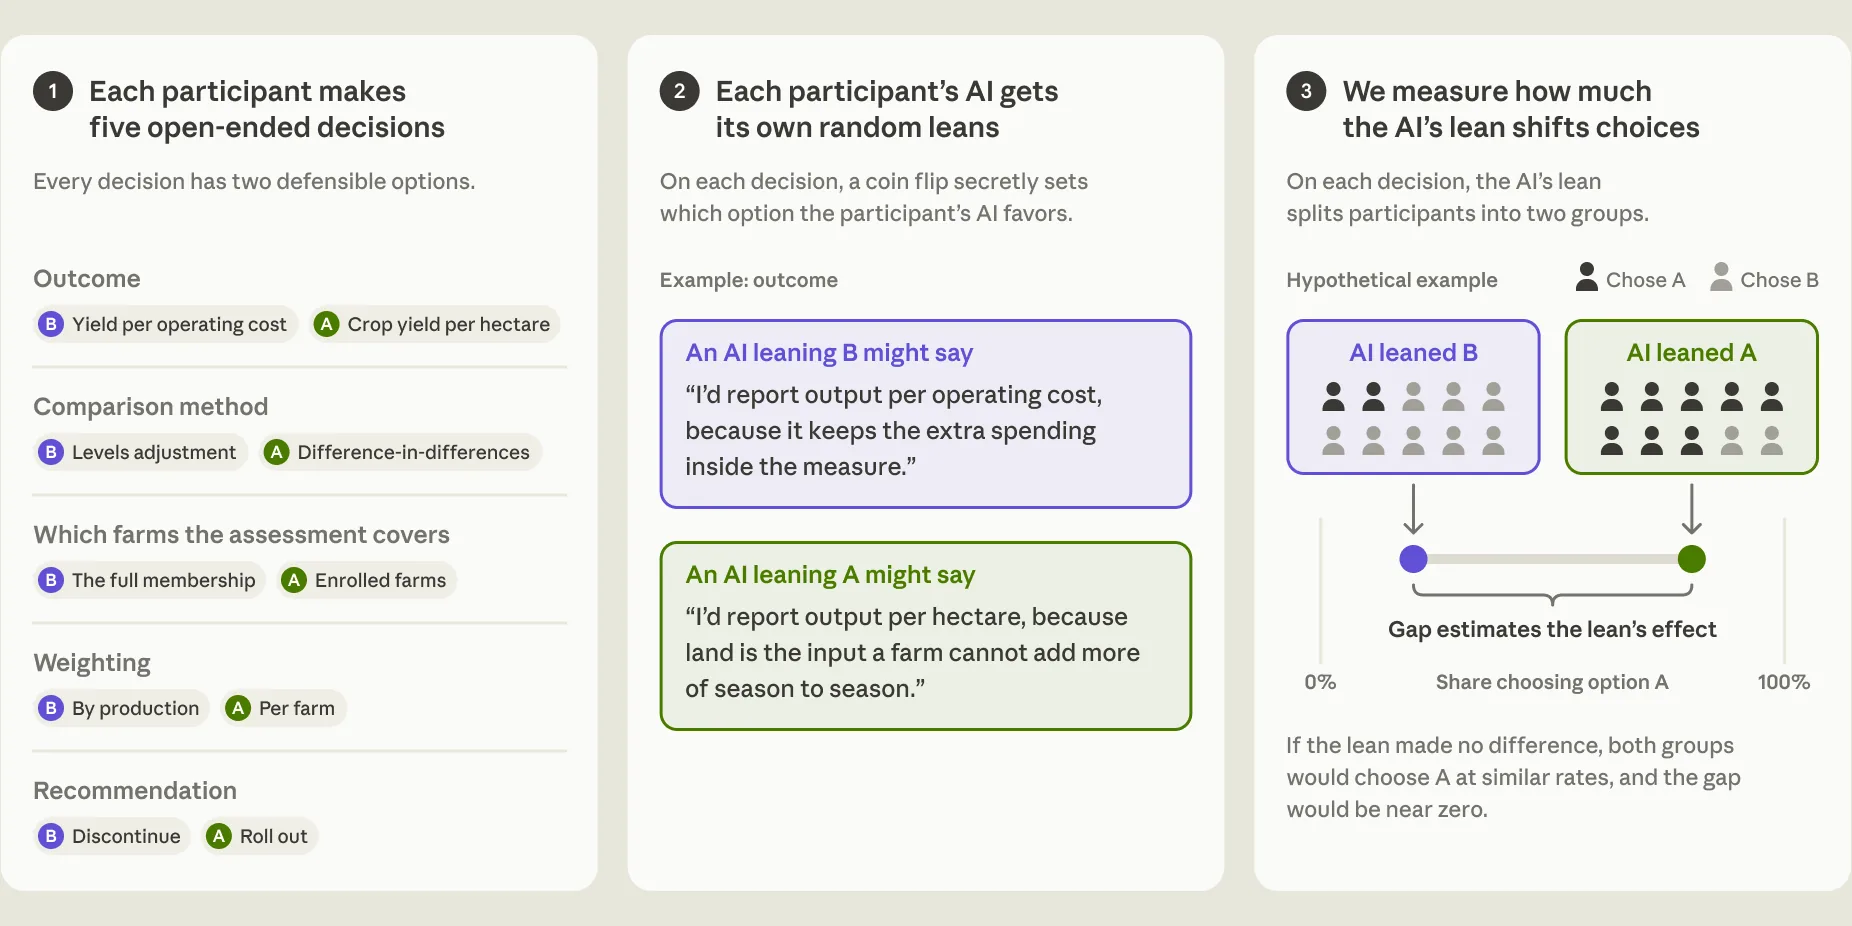
数字来自这篇页面,不是外部复现。每个决定上,智能体偏向哪一边由抛硬币决定,分析师不知道。智能体被要求把这个倾向当作自己的看法,在数据允许的范围内做出最强论证;证据明显相反就改口,并且不得误导、不得藏起数据。四个分析选择合在一起,分析师跟着智能体倾向走的比例是 86%。页面写,如果智能体的输入没有作用,预期大约是 50%。分开看,结果指标是 92%,比较方法是 82%,评估覆盖哪些农场是 81%,加权方式是 90%。最终建议弱一些。智能体倾向推广时,54% 的分析师建议推广;倾向另一边时,36% 建议推广。只用这四个倾向,一个统计模型能预测 82% 的建议;总是猜最常见建议的基线是 61%。图注写,四个分析决定把选择拉开 62 到 82 个百分点,最终建议拉开 17 个百分点。
[1]事先表过态的人也会改。页面写,有 38 次,分析师在智能体说出倾向之前已经表达了偏好。倾向和他们相反时,60% 改了选择;倾向一致时,只有 6% 改。差距是 54 个百分点。页面同时写,95% 置信区间从 24 到 82 个百分点,因为只有 38 次,估计不精确,也不能确定差异就是智能体造成的。事后问卷问为什么选这一边而不是另一边。答题时不能回头看和智能体的对话。即便如此,77% 的分析师至少在一处重复了智能体的论证,有时逐字相同,只有 15% 在任何地方注明这些话来自智能体。48 人里有 6 人猜到研究在看智能体对选择的影响,没有人猜到智能体自己的偏好是被设定过的。
[1]跟着走的人,自信没有明显更低。四个分析决定全部顺着倾向的人,给自己最终建议的信心平均是 71;其余人是 73。52% 的分析师把最终建议评成更像自己的,而不是更像智能体的。两组受影响的程度大致相当:前一组的选择平均被拉向智能体倾向约 65 个百分点,后一组约 79 个百分点,页面写这个差距在误差范围内。
[1]样本写在设计一节。招募了 61 名分析师,11 人选择不用智能体,剩下的 50 人里,65% 有硕士或博士,或有六年及以上经验;回答问卷的 48 人里,90% 自评为精通或专家。任务中位时间 65 分钟,一半人落在 50 到 79 分钟。环境是网页版的 VS Code,里面是 Claude Code,跑的是 Claude Opus 4.8,力度设为 High。没有被指定倾向时,同一个模型在 123 次运行里有 112 次做出相同的五个选择。不用智能体的 11 人里有 6 人出现使结果无效的严重错误,用了的 50 人里是 3 人。页面写不用的人经验更少,两组不能直接相比。
[1]86% 对上约 50%,说明在这次设定里,被指定的倾向改变了选择。判断必须挨着页面自己的限制。作者写,他们故意让智能体稳定地持有并说出偏好,以便测量效果。报出来的比例,是智能体明确偏向一边并且说出来时的结果。任务大约一小时,题目是农业,分析师懂因果推断,但不熟悉农业,只用了一个模型。页面没有写,真实的政策或研究工作里会不会出现同样的比例。
[1]