
要点
- Kaedim/projectsim(HF,文内标注 2026-10-30)从 Robot.com 部署演讲出发,梳理通才策略到可部署系统之间仍要付的手工:结果检查、记忆、技能约束与安全。
- VoLo:完整系统 18/42 vs 单策略 6/42;模拟失败里监视器宣称橙子已入碗而橙子仍在桌上。
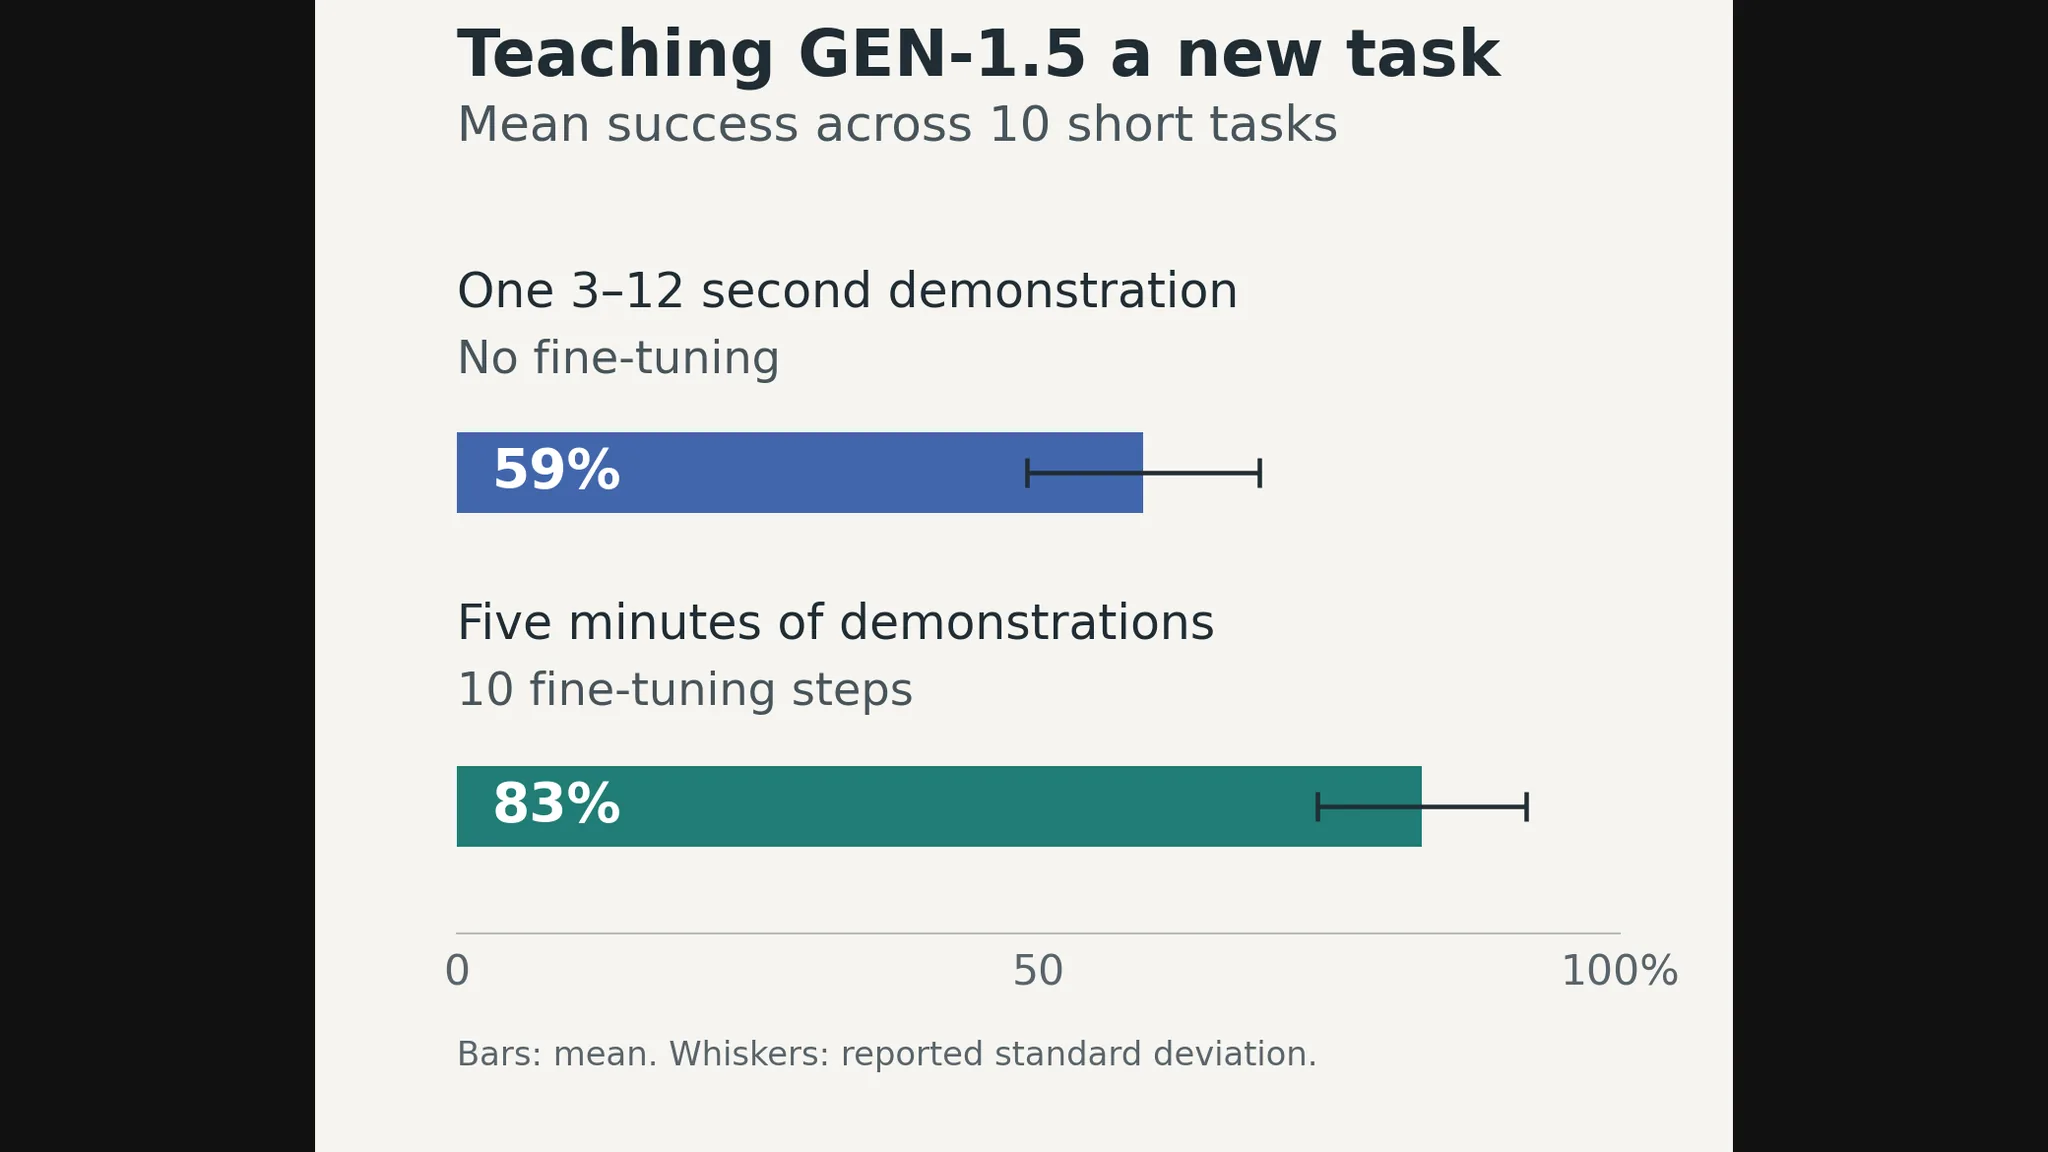
- 迁移信号:Figure Helix 2.5 在未见过的家庭,Index 预训练使全任务完成 9%→56%;GEN-1.5 一次 3–12 秒演示平均 59%,五分钟数据+十步微调 83%。
- 经验规模:NVIDIA 称 GR00T N1 用 DexMimicGen 11 小时生成 78 万条模拟轨迹(约 6500 小时轨迹时间);SIMPLER 显示模拟回放排名可优于演示动作预测误差——前提是校准后难度仍在。
在旧金山 Long Horizon,Robot.com 的演讲把「通才模型」和「可上线机器人」之间的缝写得很直白:微调、测试、集成与系统工程仍然大量手工。Kaedim 的 Luca Cilio 在 Hugging Face 社区文(页内日期 2026-10-30)把缝拆开:结果检查会错、技能要服务下一步、仿真必须保留真实难度。
中心判断:即插即用不会仅仅因为策略更通才而自动到来;缺的是可迁移经验与仍诚实的评价/适配闭环。
[1]发生了什么
文章串联近期系统与通才结果:VoLo 在策略外加规划/监视与抓放工具;POT-VLA 维护 3D 物体记录;BATON 记录技能转移约束;Tool-Aligned VLA 让执行器适配被调用方式。另一条线是迁移:Helix 2.5、π0.7 跨本体洗衣、GEN-1.5 物理提示、Skild S1 用第一人称视频。再往后,Recursive Harness Distillation 与 Gemini 4 Argon 演示把部分诊断/试错交给更强 agent。经验供给则落到仿真扩样与 SIMPLER 一类评价。
[1]证据有多硬
硬数字多来自被引工作而非作者新实验:VoLo 硬件 18/42 vs 6/42;Helix 2.5 全任务完成 9%→56%;GEN-1.5 十任务平均 59%(一次演示)与 83%(五分钟+十步);GR00T N1 报道 11 小时内 780,000 条模拟轨迹。SIMPLER 的主张是:在测试的 Google Robot 任务上,模拟回放对策略排名的跟踪优于在记录演示上的动作预测误差——但作者同时强调未校准控制器会制造假失败。
这是二级综合:价值在选题与对照,不在新基准表。
[1]钢人与缺口
钢人:把「策略强了」与「系统能收工」分开,是对现场团队诚实的问题清单;强调仿真必须保留难度,直接对准假进度。
缺口:社区文章非实验室一作;若干演示(Argon 等)被作者自己标为强提示+工具的策展结果;GEN-1.5/Helix 等数字依赖原论文设置,读者需回查方差与任务时长;「即插即用」仍无统一操作定义。
[1]谁付钱、谁该改问题清单
对部署团队:验收应包含结果监视器错误率、跨步约束、以及 sim-to-real 校准记录,而不是只看通才基准。对实验室:合成数据吞吐量若不能通过「难度保留」测试,规模是负债。对采购:要问交付物是 checkpoint 还是带评价闭环的系统。
[1]六个月看什么
可证伪下一跳:在监视器独立于策略训练的设置里,端到端成功率能否稳定越过「仍失败一半」的 VoLo 区;GEN-1.5 类分钟级适配在第三方厨房/仓库是否可重复;若仿真难度校准被拿掉,SIMPLER 式排名相关是否崩溃。主张不是通才无用,而是:通才只降低起跑成本,即插即用仍取决于经验闭环是否诚实。
[1]