
要点
- Hugging Face 博客(2026-11-04):“Dharma Field Extractor: Any Document In, Structured Fields in JSON Out”;基于 DharmaOCR-LITE v1.1(2B)加在 43384 例上训练的 LoRA。
- 两种请求模式:开放(无 schema)与 schema 定向(精确键/类型;缺字段返回 null,不编造)。
- 基准:546 份文档 × 三种情景 = 1638 例;分数 = 字段级 F1(按路径匹配,含表内位置)× 匹配值的 Levenshtein 相似度 × 合法 JSON 占比。
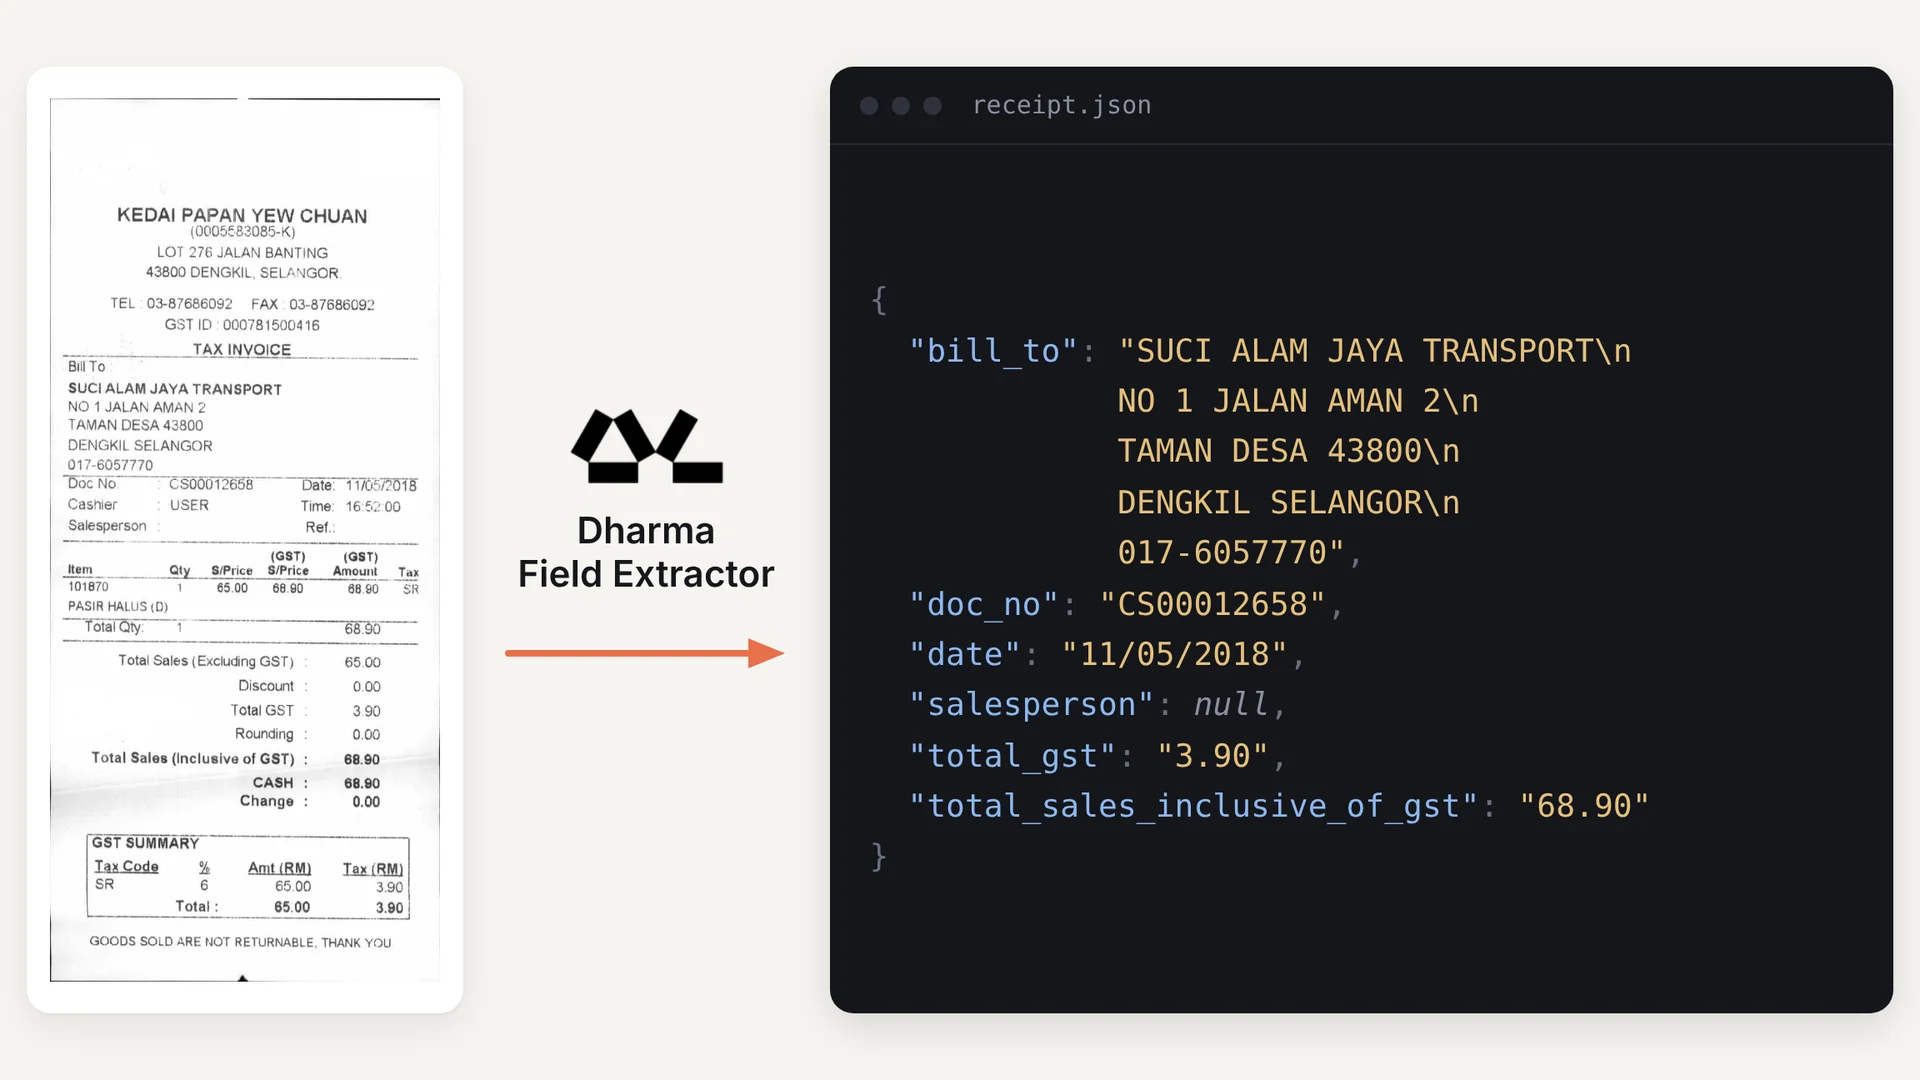
- 公开集 SROIE、FUNSD 未进训练;厂商展示 18 字段 SROIE 收据全对,以及 12 个布尔项的 FUNSD 清单与手写 Bates ID。
2026 年 11 月 4 日,Dharma-AI 在 Hugging Face 发布 Dharma Field Extractor:一个 20 亿参数模型,接收文档图像,外加开放请求或精确 schema,返回带类型的 JSON。OCR 已经能忠实还原版面文字。字段抽取是另一件事:命名键、类型化值、嵌套表,以及页面没有该字段时的 null。文中可辩护的主张不是小模型普遍更聪明,而是:在有界、按 schema 定向的字段抽取上,贴近任务训练的 2B 模型能在字段级 F1 上胜过前沿通才 API,并在单卡 L40S 上把成本压到约 1/6 到 1/147。 若独立实验室在匹配 schema 的留出公开集上翻转该排名,或在同等 F1 下抹平成本差距,主张即失败。
[1]实际交付了什么
底座是已通过 SFT 与 DPO 专精 OCR 的 DharmaOCR-LITE v1.1。LoRA 在 43384 例上训练,覆盖英语多领域公开网页文档、巴西葡萄牙语内部文档,以及更小份额的多语数据。文档类型包括收据、发票、表单、银行对账单、证件与合成样本。
开放模式不预设固定词表,从版面识别标签-值对与表格。Schema 模式要求精确键与类型(string、number、boolean);缺失字段返回 null。作者强调 schema 输出严格贴合请求形状、不追加额外键,因而可直接进入下游系统,无需二次映射。
[1]证据硬度
完整基准覆盖 546 份文档、三种情景(全字段、仅真实字段的部分 schema、故意混入幽灵字段的 schema),共 1638 例。分数把按路径(含表内位置)匹配的字段级 F1、匹配值的 Levenshtein 相似度,以及合法 JSON 占比相乘。
对照四种前沿配置(推理设为低;Claude Opus 5 为 adaptive),质量差距从 1.8 分(Opus 5 的 0.816 对 0.834)到 9.3 分(GPT-5.6 Luna 的 0.741)。成本用测得的每页平均 token 对照标价,对比单卡 L40S 按每小时 2.24 美元计的 GPU 时间。作者写明自托管成本取决于硬件、量与延迟目标;区间是说明性的,不是销售价目。
SROIE 与 FUNSD 留出训练。在一份 SROIE 收据上,模型正确返回全部 18 个请求字段,包括多行无标签账单地址,以及对空白 salesperson/ref 的 null。在 FUNSD 复印差异表上,它把唯一勾选项标为 true、其余十一项为 false,读出手写 Bates ID,并对空白字段返回 null。
[1]钢人与缺口
钢人。 厂商基准偏向厂商。前沿模型未在同一 4.3 万例上微调;若给 Opus 或 GPT 做同类 LoRA,或许能抹平相对 Opus 的 1.8 分差距。每小时 2.24 美元的 L40S 摊销未计入空闲容量、工程时间与采购。英语与葡萄牙语之外的多语覆盖显得偏薄。「缺则 null、不编造」是正确产品行为,但文中未公布跨领域的校准弃权率。
这些限制成立。它们取消不了结构点:当输出契约是固定 schema 时,专精加版面感知训练,可以胜过在上下文里被要求做同一件事的通才。更早的 DharmaOCR 论文(arXiv:2604.14314)曾对巴西葡萄牙语 OCR 作过平行论证;本次把同一模式延到字段抽取,并点名公开留出集。
仍待闭合:1638 例协议的第三方重跑;对照文档专精商业 API(而不只是前沿对话模型);多页合同上的延迟与错误模式;以及在对抗性空白字段下,schema 定向 null 行为是否仍然成立。
[1]谁该在意,下一步看什么
正按前沿费率把发票、证件与申请单打成数据库行的团队,应按同等字段 F1 把自托管 2B 抽取器与当前 token 账单对账。合规采购方应把「缺失即 null」写成硬要求,而不是可选项。发布通才文档代理的模型实验室,应公布带幽灵字段 schema 的路径匹配字段 F1,而不只是页级 OCR CER。
接下来观察:SROIE/FUNSD 与厂商三情景组合上的独立分数;在相似数据上训练的前沿 LoRA 是否抹平 Opus 的 1.8 分差距;以及路径匹配 F1 通常塌陷的多页嵌套表生产报告。
[1]收束
Dharma 可辩护的句子不是 2B 模型取代前沿系统。而是:对按 schema 定向的字段抽取,专精小模型可以在字段 F1 上领先,同时成本差距大到足以在放量时改变账单。 六个月后,要么外部基准保住这一排名,要么前沿微调与文档 API 同时抹掉质量故事与价格故事。
[1]