
要点
- 2026年11月13日,NVIDIA 发布教程,作者是 Fatima Fall,介绍如何用 vLLM,在两台通过 ConnectX-8 RDMA 相连的 GB300 DGX Station 上部署 NVIDIA GLM-5.3 NVFP4 模型文件。
- 该模型是 Z.ai 混合专家设计的量化版本,总参数 7530 亿,每个 token 实际启用 400 亿。NVIDIA 称模型文件大约需要 464 GB 显存,超过单颗 GB300 上 252 GB 的 HBM3e。教程关闭了把权重卸载到 CPU 的做法。
- 张量并行度设为 2,把权重和计算分到两块 GPU 上。两台机器都会参与每一个请求,由 A 机通过一个与 OpenAI 兼容的接口返回结果。启动参数包括 98304 个 token 的上下文上限,以及 93% 的 GPU 显存占用。
- 服务配置打开了每步草稿 4 个 token 的多 token 预测,用 FP8 存储键值缓存,并启用前缀缓存。键值缓存是模型对已出现 token 的短时记忆。
- 在打开前缀缓存的 SPEED-Bench Coding 测试中,NVIDIA 的 AIPerf 结果是:1 路并发时总输出每秒 107.4 个 token,8 路 386.0,16 路达到峰值 607.8,32 路降到 385.0,此时平均请求延迟为 453.54 秒。人均吞吐量从 1 路时的每秒 115.3 个 token 降到 32 路时的 13.0。token 计数包含推理过程。
2026年11月13日,NVIDIA 发布了一篇教程,讲的是如何让 GLM-5.3 在两台放在桌上的机器上提供服务,而不是走云端接口。这个模型是公司对 Z.ai 混合专家设计做的 NVFP4 量化版。混合专家的意思是,系统里保留许多分工不同的子模型,每个 token 只用到其中一部分。它共有 7530 亿参数,每个 token 实际启用 400 亿。稀疏启用能减少每个 token 的计算量,但省不下显存,因为每个专家的权重仍然要放在手里。NVIDIA 称,这份模型文件大约需要 464 GB 显存,超过单颗 GB300 GPU 里 252 GB 的 HBM3e。
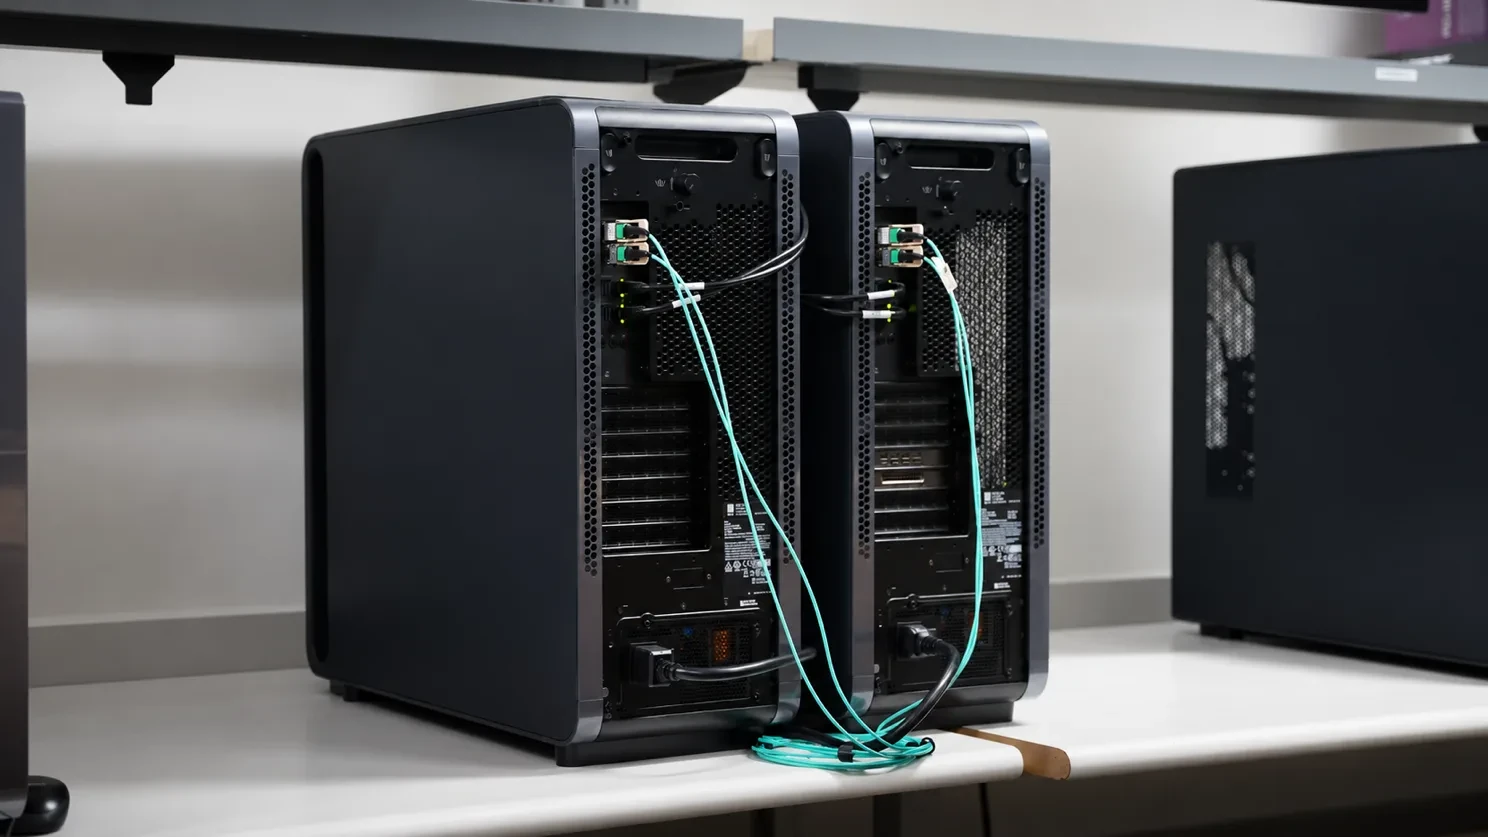
它给出的办法是两台 GB300 DGX Station,用 ConnectX-8 RDMA 相连,也就是机器之间的直接内存链路,再由 vLLM 提供一个与 OpenAI 兼容的接口。Fatima Fall 的文章既是一份操作说明,也是一次测量。难处不在模型能不能启动,而在请求稍一变多时会发生什么。
[1]张量并行度设为 2,把模型的张量分到两块 GPU 上。两台机器都会计算每一个请求,由 A 机返回答案。两块 GPU 的显存仍然是分开的。教程关闭了把权重卸到 CPU 的选项,前提是全部权重都留在 GPU 显存里。每台机器还需要大约 464 GB 空闲磁盘来放各自的模型副本,外加容器镜像的空间。使用者要接受 NVIDIA Open Model Agreement 和 GLM-5.3 原有许可。负载测试里的 SPEED-Bench 提示词另受 NVIDIA 评估数据集许可约束,准备工作还取决于能否访问 Hugging Face 上受控的 cais/hle 数据集。
启动脚本把上下文上限设为 98304 个 token,包含输入和输出,并把 93% 的 GPU 显存交给 vLLM。多 token 预测是打开的,这是一种推测解码:模型的草稿层每步先提出 4 个 token,再由 vLLM 用完整模型核验后才接受。键值缓存用 FP8 存储,也就是模型对已出现 token 的工作记忆,体积大约只有 16 位存储的一半。前缀缓存也是打开的,已经处理过的提示词前缀不会再算一遍。
[1]负载测试用 AIPerf,在 SPEED-Bench Coding 数据集上进行,同时打开前缀缓存、每步 4 个草稿 token,以及 FP8 键值缓存。预热请求不计入结果。token 计数包含推理过程。设定的并发是 1、8、16 和 32。1 路并发时,总输出是每秒 107.4 个 token,平均请求延迟 49.84 秒,到首个 token 的平均时间 479.75 毫秒,token 间隔平均 8.78 毫秒。8 路时,总输出升到每秒 386.0 个 token,平均请求延迟 114.17 秒。16 路时,总输出达到峰值,每秒 607.8 个 token,平均请求延迟 136.46 秒,token 间隔平均 23.77 毫秒。
到 32 路,服务开始往回走。总输出降到每秒 385.0 个 token,低于 8 路的数字。平均请求延迟跳到 453.54 秒,到首个 token 的平均时间是 899.36 毫秒,token 间隔平均 77.90 毫秒。人均吞吐量,也就是单个客户端实际感觉到的速度,从 1 路时的每秒 115.3 个 token 降到 32 路时的 13.0。对一套放在桌上的接口来说,这就是还能分享使用,和每个请求都要等上几分钟的差别。
[1]公允地看,NVIDIA 把这座悬崖写进了文章,而不是把图表停在峰值上。在全部权重都留在 GPU 显存的前提下,16 路并发达到每秒 607.8 个 token,对不应离开房间的工作来说,这是真实可用的本地方案。文章对硬件门槛也很直白:两台经过验证的工作站、一份 RDMA 操作手册,以及每台机器都要下载的数百 GB 文件。
这些数字仍然是 NVIDIA 在自己的硬件上测出来的,而且打开了前缀缓存和多 token 预测,只用了一个编程数据集,还把推理 token 算了进去。文章说,如果关掉前缀缓存,表现可能会不同,并建议读者用自己的提示词重跑 AIPerf。文中没有独立复现,也没有在同一工作负载上和云端接口做对比。表 2 应看作这份配置的基线,而不是 GLM-5.3 的通用速度评分。
[1]写这篇教程的理由并不是速度。NVIDIA 说,本地接口适合处理敏感或专有数据,也适合在没有按 token 计费的情况下试验代理,还适合那些不便放在托管服务上的工作。这个理由要成立,先得让这两台机器的集群稳定跑着,团队也得接受表中描述的并发窗口。超过 16 路并发后,同一篇宣传桌边大规模模型服务的文章,也写出了以分钟计的平均延迟。
另一重限制是运维。两台机器要布线、验证,并按正确顺序启动。模型文件大到在 1 Gb/s 链路上大约要下一小时,在 10 Gb/s 上大约要六分钟。说它本地,是因为权重不会送到厂商的接口上。说它不是通常意义上的本地,是因为它不是桌下一台开机即可忘记的箱子。
[1]接下来六个月,值得看的是后续的 NVIDIA 配置,或独立的 vLLM 实测,能否在不重新打开权重卸载的前提下提高 32 路并发的吞吐量,以及有没有人在非编程任务上公布同一张表。如果悬崖仍停在表 2 的位置,两台工作站上的 GLM-5.3 会是处理私有数据的低并发工具,而不是托管接口的通用替代。模型可以放在房间里。这个房间必须先布好线,队列也不能太长。
[1]