
要点
- 2026 年 11 月 9 日,Jay Carlson 和 Ansley Dunn 在 NVIDIA 技术博客上发了一篇教程,用 Holoscan 5、Pinocchio 和 Seeed Studio 的 reBot Arm B601-DM 搭一套重力补偿回路。
- 这套回路以 400 赫兹读取关节状态,算出用来抵消重力的力矩,再把命令送给电机。三个算子跑在同一条线程上,队列里只保留最新的样本。
- NVIDIA 报告每种配置测量了超过一百万个周期,并去掉了开头十秒。延迟从进入第一个算子算到进入最后一个算子,不包括把电机命令送出去的时间。
- 控制分区被钉住并隔离开之后,C++ 的 p99.99 延迟从 86.6 微秒降到 17.2 微秒。Python 从 1373.5 微秒降到 142.6 微秒。钉住时 C++ 的中位数是 7.1 微秒,Python 是 93.0 微秒。
- 作者在 Jetson Orin Nano、Jetson Thor 以及运行 Ubuntu 24.04 的 x86 机器上测过这套步骤。这些数字是 NVIDIA 对自己运行时的测量。
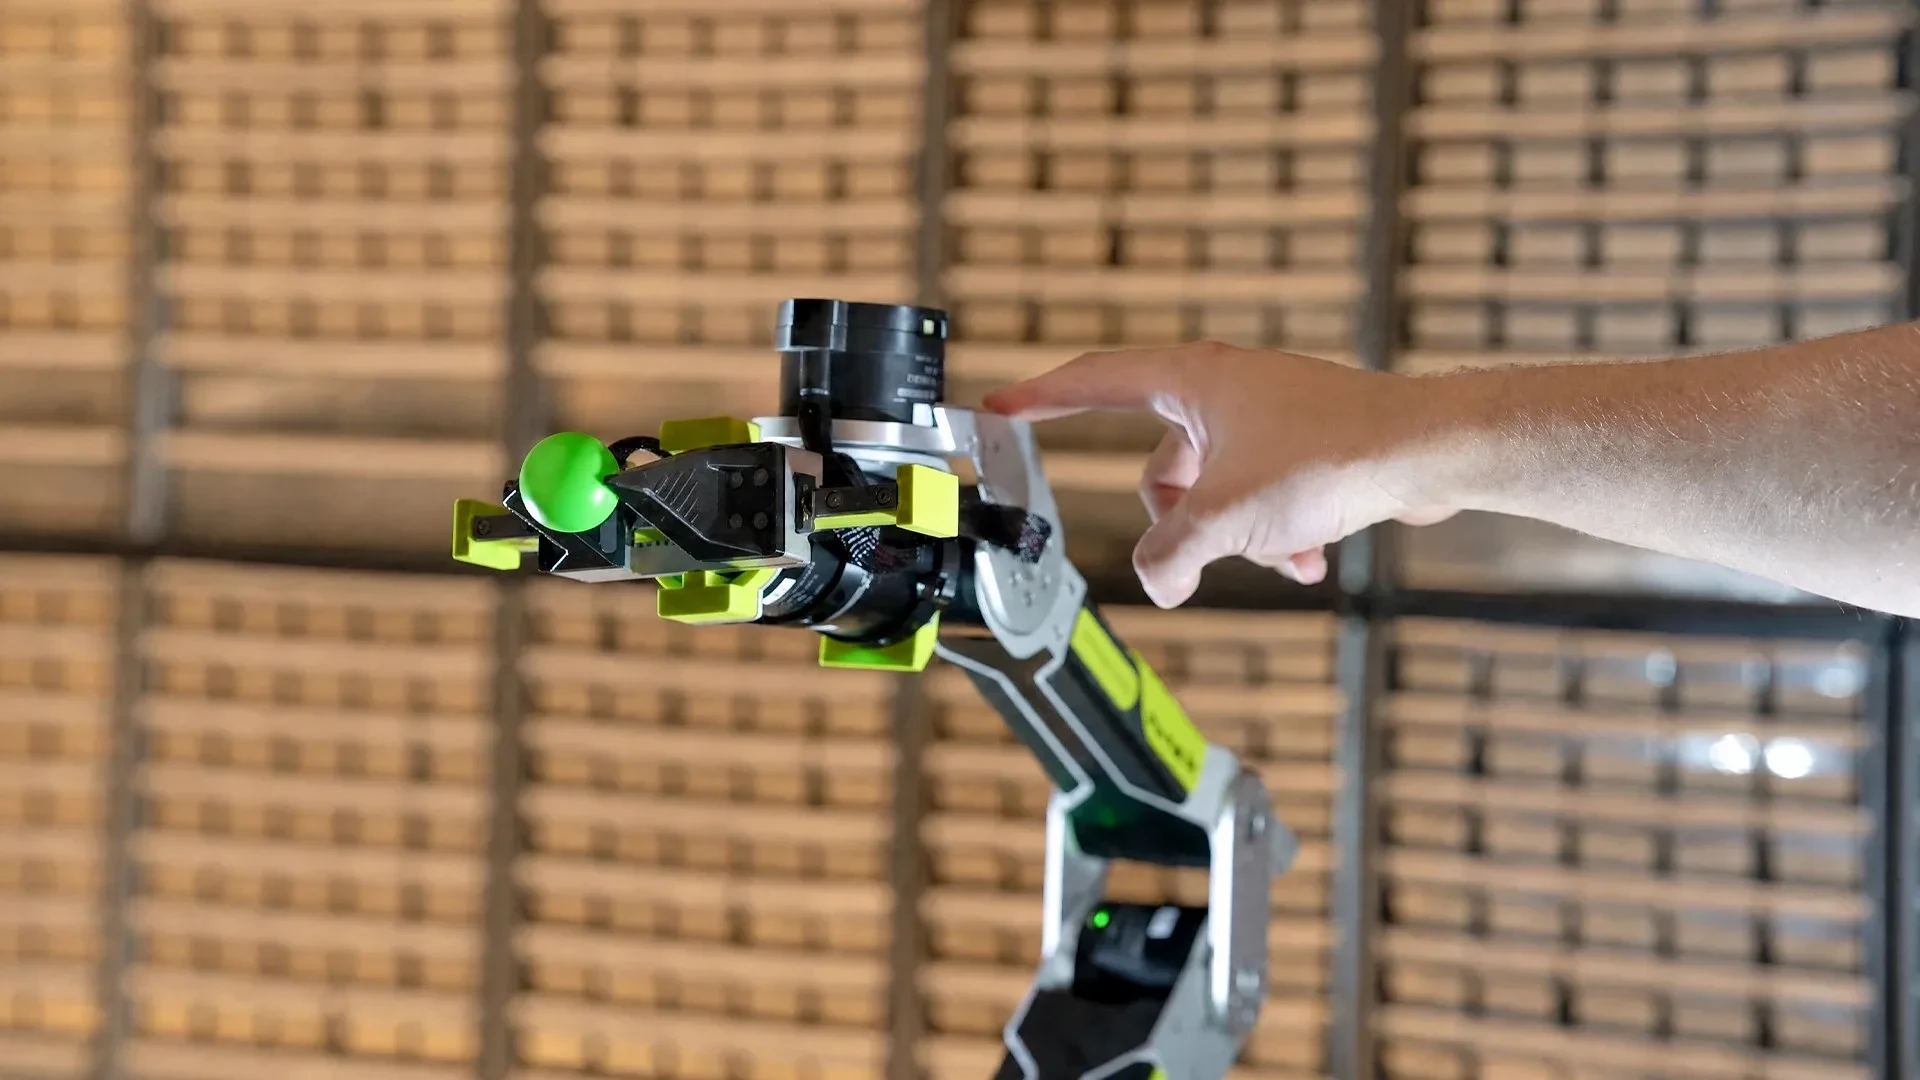
2026 年 11 月 9 日,NVIDIA 技术博客让读者想象一件事:用手去引机械臂,同时电机只输出刚够托住自身重量的力矩。Jay Carlson 和 Ansley Dunn 接着演示,如何用 Holoscan 5、名为 Pinocchio 的逆动力学库,以及 Seeed Studio 的 reBot Arm B601-DM 搭出这样的回路。演示很好看。值得写下来的理由更窄。他们的论点是,重力补偿同时在给两样东西做存活检查:手臂的物理模型,以及必须每秒数百次重算力矩、还不能乱抖的软件运行时。他们那张表回答的是第二个问题。
[1]教程搭的是什么
Holoscan 5 是 NVIDIA 的软件开发包,用来在同一套编程模型里混合低延迟控制和更重的感知工作。这篇教程停在控制路径上。它把工作拆成三个算子。JointStateSourceOp 每 2.5 毫秒醒一次,也就是每秒 400 次,并读取七个电机。PinocchioGravityOp 在状态到达时运行,把六个手臂角度映射进机器人的 URDF 模型,再通过递归牛顿-欧拉算法向 Pinocchio 要重力力矩。MotorCommandSinkOp 经 motorbridge 库把每条命令送出去,并拒绝过期、乱序或超出范围的命令。如果连续 100 毫秒没有任何一批命令完成,看门狗会尝试切断电机。
URDF 文件是对机器人连杆、关节和质量的一种标准描述。如果这些数字不对,重力补偿会以你能感觉到的方式失败。手臂会下垂,或者姿态一变就往上顶。位置控制的演示可以盖住同样的错误。所以作者把这套回路当作第一步检查,即使最终产品并不会交付重力补偿。
硬件选择也出于同样的理由。许多低价机械臂使用减速比很高的业余舵机,只适合做位置控制。reBot Arm 使用准直接驱动执行器,能够足够快地产生和感知力矩,才撑得起这种柔顺运动。这套步骤在 Jetson Orin Nano、Jetson Thor 和运行 Ubuntu 24.04 的 x86 系统上测试过。同一仓库里还有对应的 C++ 实现。
[1]延迟表测的是什么
Holoscan 允许开发者把三个算子放进同一个分区,这样它们的回调会在运行时自己的一条线程上依次执行。算子之间的连接使用深度为 1、丢掉最旧样本的队列。目的是避免跨线程交接,也避免对过期状态采取动作。
作者用 NVIDIA Nsight Systems 和内置标记,对未改动的程序做了性能分析,并比较了 C++ 和 Python 在钉核与不钉核时的运行。钉核的实验里,他们用临时的 Linux cgroup 预留物理核心,并把辅助线程和分析线程挪到一边。他们写明,中断、定时器和部分内核线程仍可能落到这些核心上。每种配置保留了超过一百万个周期。他们丢掉了开头十秒,但保留了离群值。
这里的 p99.99 表示 99.99% 的周期比这个数字更快,大约每 1 万次里只有 1 次更慢。他们公布的表是:
HSDK C++ 钉核:p50 为 7.1 微秒,p99.99 为 17.2,p99.999 为 20.7。
HSDK C++ 不钉核:15.3、86.6、133.4。
HSDK Python 钉核:93.0、142.6、1014.0。
HSDK Python 不钉核:113.8、1373.5、3134.1。
钉核加上隔离,把 C++ 的 p99.99 延迟大约降到五分之一,把 Python 大约降到 9.6 分之一。这里的延迟在最后一个算子处停止,不包括把电机命令传送出去的时间。两个语言版本都调用 Pinocchio 的 C++ 求解器。作者说,Python 多出来的开销来自解释器执行、对象分配,以及围绕全局解释器锁的协调。
在 400 赫兹下,每两拍之间有 2500 微秒。即便是他们报告的最慢 Python 尾部,3134.1 微秒,大约也只多出一拍。钉核后 Python 的 p99.99 是 142.6 微秒,在这个预算里看起来宽裕。钉核后 C++ 的 17.2 微秒,则给感知或规划腾出了更多与它共享机器的空间。
[1]为什么重力补偿是一种诊断
作者并不是在论证,一只没有重量的手臂就是产品。他们是在论证:一套无法稳住紧密、可重复的控制回路的运行时,不会是安全地加入摄像头、学习策略或一只人手的地方。力矩控制可以让手臂托住自己的重量,同时在有人推它时让步。这种组合对示范教学、对和人一起工作都有用。它也会让计时错误以不稳定的方式显现出来,而不是变成一个稍晚到达的路点。
基础回路跑通之后,教程仓库会再加入运动学和阻抗控制,作为可复用的算子,这样学习策略可以请求一个姿态,同时手臂对触碰保持柔顺。他们说,感知可以之后再通过 Holoscan 的视觉模块和 Isaac ROS 加上。这个顺序是有意的:先测量控制路径,再把它埋进更大的计算图里。
[1]更宽容的读法,以及缺口
为 Python 控制路径辩护的理由很清楚。许多机器人团队本来就住在 Python 里,而且 Holoscan 会在启用电机之前编译计算图并出示执行计划。对于耗时以毫秒而不是微秒计的感知流水线,作者自己也说,在 CPU 上去追逐小小的内存分配,通常没那么要紧。
缺口同样清楚。这些是 NVIDIA 在自己的软件包上、在一只手臂上测得的数字,而且性能分析时隔离核心的方式,比一般车间里的进程列表更仔细。公布的延迟不包括命令传输,而那是真实回路的一部分。即便钉核,Python 的 p99.999 仍是 1014 微秒,提醒你罕见的停顿仍然存在。独立团队尚未在同一只手臂、同一份 Holoscan 5 构建上公布自己的百万周期表。
[1]谁该在意,接下来看什么
任何在写一条可能被人握住的力矩回路的人,都该看这些数字。因为钉核后 C++ 17 微秒的尾部,和不钉核时 Python 1.4 毫秒的尾部,差别就在于回路是在等物理,还是在等解释器。想留在 Python 里的团队也该看:钉核让他们在远端尾部大约换来了一个数量级,但并没有和 C++ 打平。
接下来六个月,看公开教程的使用者会不会在 Jetson Thor 或 Orin Nano 上公布自己的 Nsight 摘要,并补上这张表没有计入的电机命令时间。看后来的 Holoscan 例子在加入摄像头和学习策略之后,是否仍坚持同样的分区和钉核做法。也看 Python 的尾部会不会在不放弃这门语言的前提下降下来。
[1]收束
演示让一只手臂摸上去变轻。表格说明这种感觉为什么脆弱。如果其他实验室也能复现钉核带来的五倍和十倍尾部下降,那么对这类控制来说,核心隔离就会看起来像必选项,而不是可有可无的调参。如果把命令传输和其他进程算进去之后,他们的尾部仍然很长,那么这只失重的手臂就还只是一次干净的实验室测量,而不是工厂里的运行时。
[1]