
要点
- Owen Queen 与 James Zou(Stanford,2026-11-02)用同一设定重测 50 条广被引用的 LLM 主张,覆盖 20 个模型(约 2024-07 至 2026-09,八家开发商)。
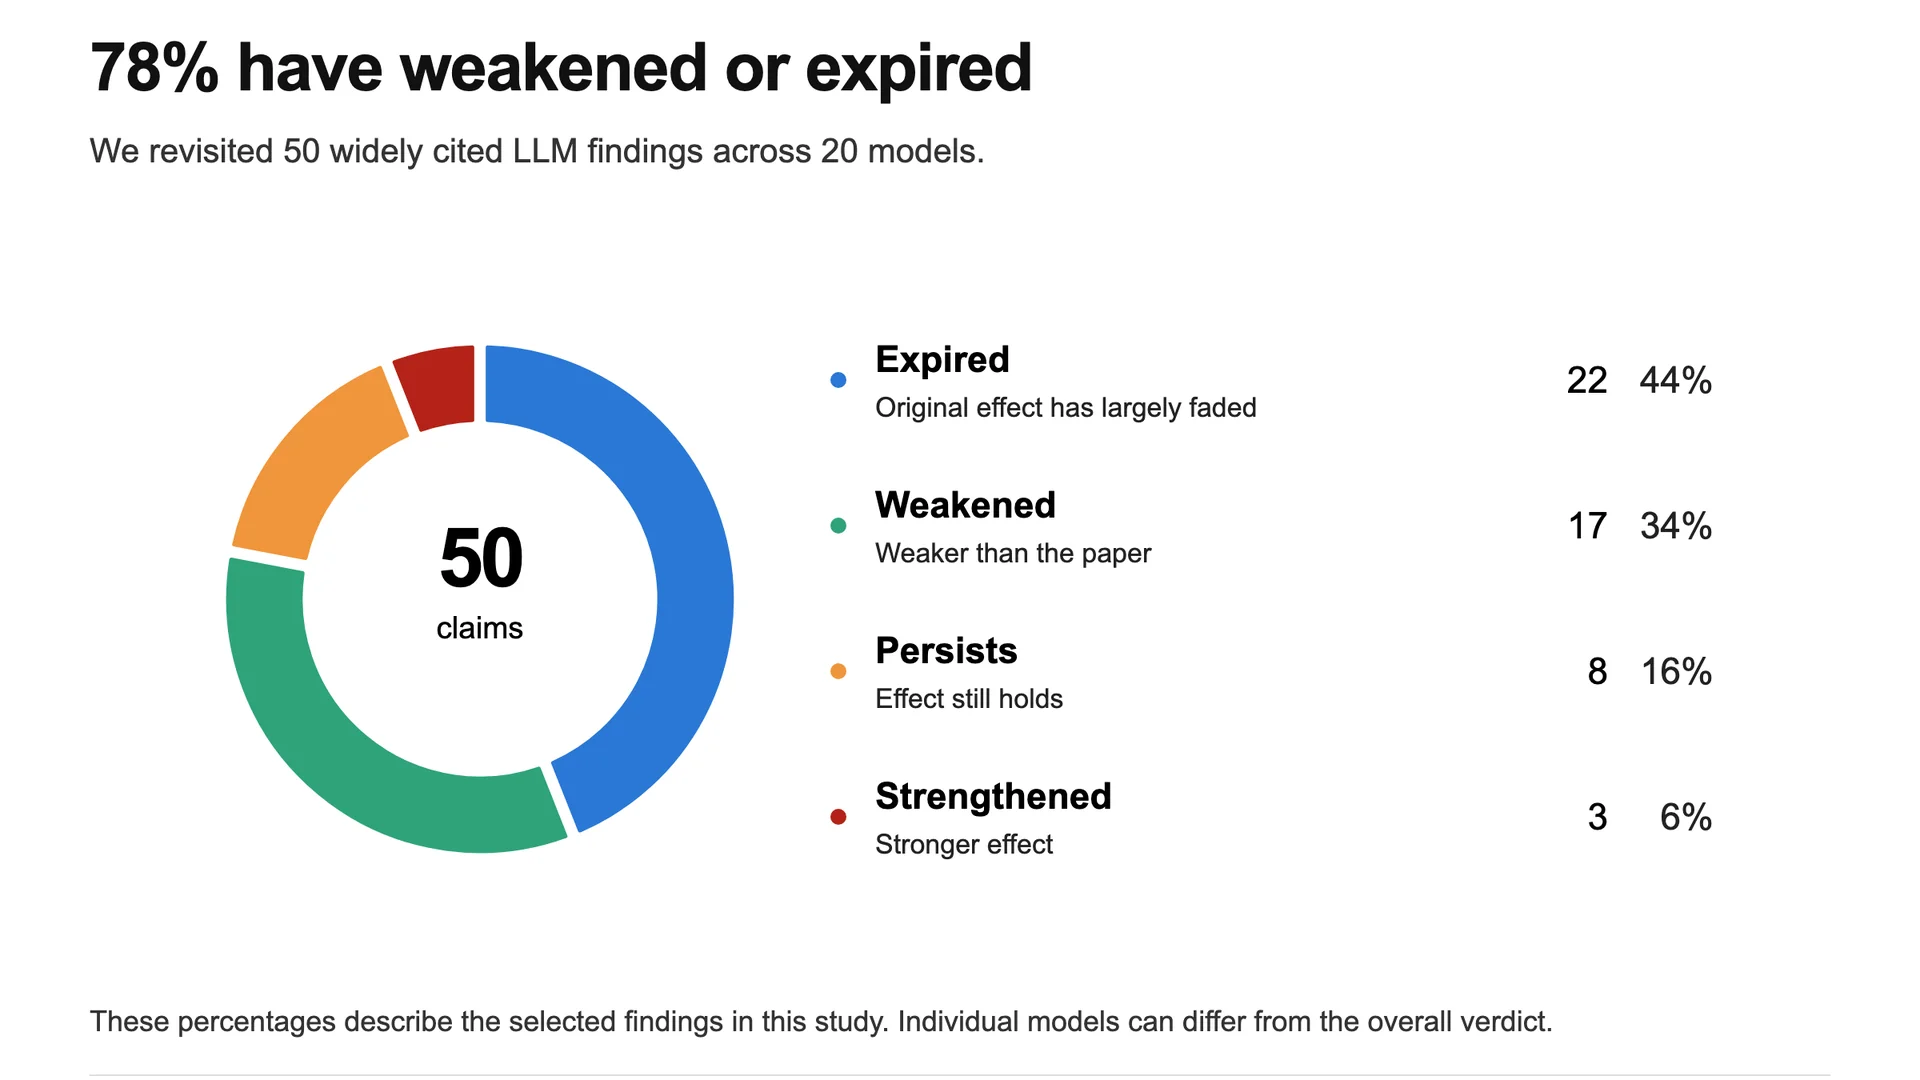
- 按相对效应 e(原论文=1,消失=0)分类:截至 2026-09-30,44% 过期(e≤0.2)、34% 减弱、16% 存续、6% 增强;已估过期日期的 22 条,发表至过期平均 15.7 个月(中位 14.7)。
- Kaplan–Meier:发表后 6/12/24 个月过期份额约 4%/16%/39%。能力失败更易过期;偏好/判断类更常存续或增强。引文捏造(C11)在多数新模型上已近消失。
2023 年 Walters & Wilder 报告 ChatGPT(GPT-3.5)文献综述中 55% 引用为假;同一提示在 GPT-6.1-Sol、Claude Sonnet 5.5 上很少再捏造——但个别模型例外仍在。Queen 与 Zou 把这类「昨天为真、今天是否仍真」问法系统化。
可证伪读法:若「LLM 经验主张有短保质期」成立,应看到能力类失败随发布时间衰减,而偏好类更顽固;若面板换一批模型后分类大翻转,或复现锚点大量失配,则应下调该保质期叙事的外推权重。
[1]硬事实(项目页,2026-11-02):50 条主张涵盖谄媚、越狱、长上下文、文化偏见等;对每条拟合随发布日期变化的趋势,并以 e≤0.2 为过期区。结果摘要:过期 22、减弱 17、存续 8、增强 3。增强三项为:裁判自偏好(C28)、迎合用户偏好的赞美(C17)、非均匀随机数(C29)。
方法要点:先把论文指标标准化为相对效应;用原模型或替代模型做复现校验(48 条数值复现中 43 条在幅度/不确定性容差内);再对复现之后发布的面板模型拟合曲线(常数/线性/指数/logistic,过复现点,取最低 AICc)。作者明确:这是对特定模型、特定时间的观察,不是 LLM 的固定属性。
[1]证据强度:一手研究站点,含分类规则、时间线、案例研究(虚假引文)与复现细节。引文案例:GPT-3.5 Turbo 复现捏造约 59%(接近原文 55%);Claude Sonnet 5.5 约 1%,GPT-6.1 Sol 为 0%;同时指出 Qwen3.7-Flash 在该测试中仍捏造 69%。作者据此批评把「幻觉引文」当作检测 AI 写作主指标的会议政策(提及 ICLR 2026、ICML 2026 的 desk-reject 依据)可能已过时。
钢人:社区常把旧失败模式写进政策与信任叙事;系统重测提供更新先验的方法。钢人之外:仅 50 条主张,置信区间宽;早期过期日期依赖较少 2024 模型;部分原模型需替代;默认 API 配置、未统一推理预算。
[1]最强钢人:能力失败有「正确答案」可被后训练针对性修补,故更易过期;偏好与判断更难用单一监督信号抹掉——与「五条推理主张过期、偏好类更耐久」的分区一致。
钢人风险:减弱≠消失(如两跳问题 Claude Sonnet 5.5 仍约 10% 错,原文 ChatGPT 为 43%);面板整体过期不等于每个模型过期;黑箱商业模型与开源小模型混拟合,可能掩盖供应商特异路径。
[1]对研究者与审稿人:主张应绑定模型、版本与日期,并公开提示与代码以便未来复测。对政策制定者:以旧模型失败率为核心的合规指标需重标定。对用户与企业:信任滞后本身会影响采用——但应用数据更新,而非永久冻结在 2023 叙事。
[1]六个星期内不要把「平均 15.7 个月过期」读成所有 LLM 论文的半衰期定律:它是已过期子集的描述统计,且排除尚未过期者。真正可迁移的纪律是:报告模型身份与日期、保留可复现产物、把经验主张当时间切片——然后在新模型上再测一遍。
【No.2】
[1]