
要点
- AWS AI Blog(2026-11-04 PT):“Use decision models with Amazon Bedrock AgentCore Evaluations”;经 AgentCore 代码型评测器接入 Jev(TypeSafe)与 Strands Decider 2B。
- 决策模型对固定答案返回校准概率(noul / choice / score),不是自由文本理由;示例评测覆盖 groundedness、helpfulness、goal completion。
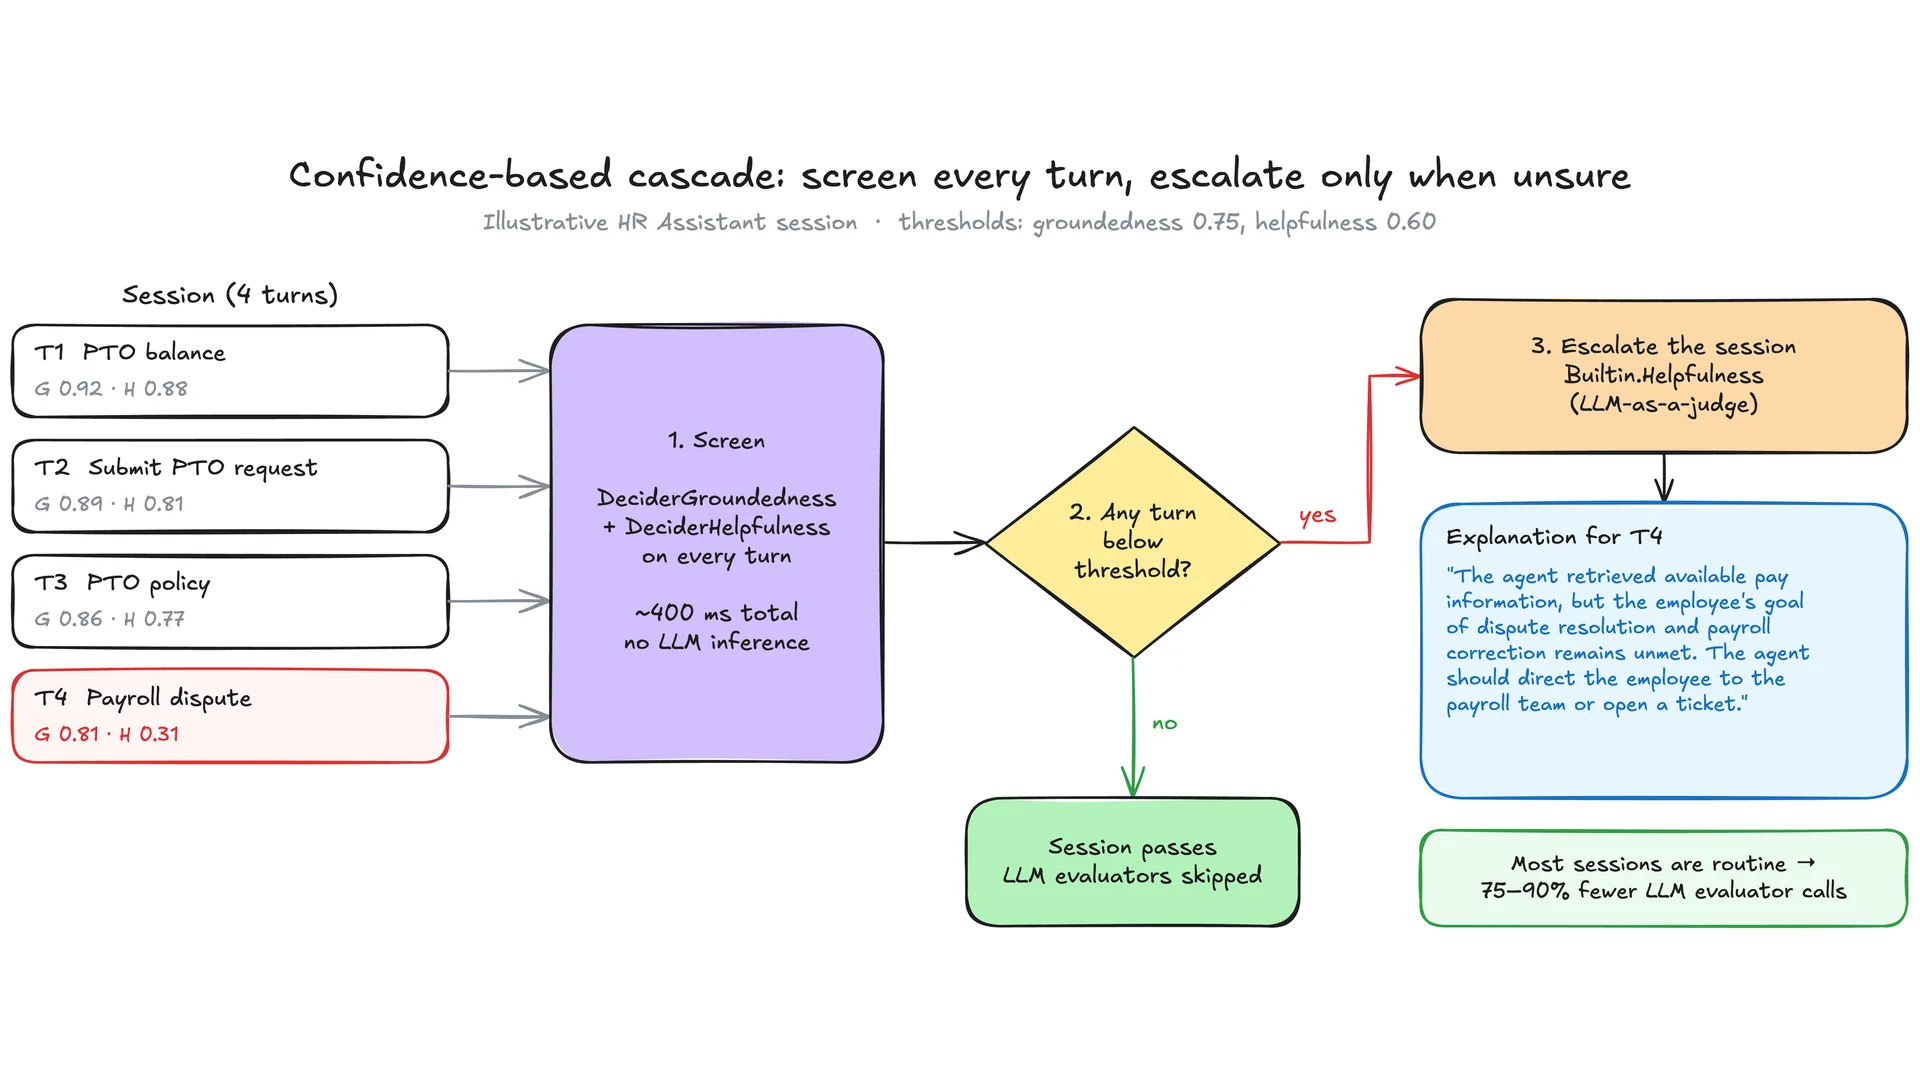
- 级联:每轮用决策模型筛(示意路径约数百毫秒、无 LLM 推理);仅当低于阈值(例:groundedness 0.75、helpfulness 0.60)才升级到 Builtin.* LLM 裁判;图示称多数常规会话可跳过 LLM 调用(示意少 75–90%)。
- 发布门禁前:在自有标注流量上用三名人工、多数票,做与内置评测的一致率/校准/分歧分析;改写问题或换模型版本后重测。
Lede
2026 年 11 月 4 日,Amazon Web Services 发布如何把决策模型接入 Amazon Bedrock AgentCore Evaluations 的实操文。代理打分仍需要可设阈值的标签。自由文本的 LLM-as-judge 置信会随运行漂移。文中可辩护的主张是架构取舍。对窄、固定答案的代理检查,校准后的决策模型应筛每一轮,只把低置信会话升级给 LLM-as-judge;它们不应整建制取代裁判。 若在同一流量上,每轮全量 LLM 裁判在按成本调整后的人工多数票一致率上胜过该级联,该主张即失败。
[1]发了什么
AgentCore Evaluations 已能在开发按需、对存量会话批测、对生产流量在线打分,带 15 个内置评测器,并支持自定义 LLM-as-judge 或代码型评测器。代码型评测在 AWS Lambda 中运行,可调用外部系统。本文经该路径接入两个决策模型后端:TypeSafe 托管的 Jev,以及需自托管的开源约 2B 参数模型 Strands Decider 2B。
决策模型吃结构化状态与固定答案集,返回校准后的概率分布。两端都支持 noul(是否概率)、choice(最多 255 选项)、score(2–10 档有序等级与概率加权分)。示例开关可为任一后端注册 Groundedness、Helpfulness、GoalCompletion,并与确定性 Lambda(回复长度、对 mock HR 数据的正则事实检查)以及 Correctness、Helpfulness、ResponseRelevance 等内置项并列。
级联是操作核心。对每一轮先跑快速决策模型检查;仅当信号低于你在校验后设定的阈值时,再调用完整内置 LLM 评测器。AWS 对比典型 LLM 裁判时延(约 2–10 秒)与示意路径上决策模型约数百毫秒级时延,并借用 JEV-as-a-Judge 预印本的“读 vs 推”区分:决策模型适合窄检查,LLM 裁判仍负责需要推导的解释。配套 HR Assistant 级联图使用示例阈值(groundedness 0.75、helpfulness 0.60),并称多数常规会话可跳过 LLM 评测调用,示意少 75–90%。
[1]证据与缺口
示例提供部署与评测脚本、OpenTelemetry span 适配,以及带五个工具、固定 mock 数据的 HR Assistant,便于核对评测行为。这对讲清管道是优点,对外推是弱点:mock 事实不是生产 HR 流量。75–90% 的 LLM 调用降幅是级联图上的示意,不是机群实测。Jev 需要 TypeSafe API key;Decider 需要可达主机(本地或 VPC 内 EC2)。关于校准的厂商说法,必须在各团队自己的标注样本上重做才算数。
AWS 自己的校验配方是必做项,不应当选配。拉取含失败的会话;三名独立人工标注并取多数票;区分全票一致与分裂轮次;在相同输入上跑决策模型与对应内置评测;检查一致率、报告概率的校准、分歧聚集处;改写问题或换模型版本后重跑。在该环闭合前,用决策模型分数做发布门禁为时过早。
钢人反驳。 更好的评分标准与缓存已能抬高 LLM 裁判;再引入一类模型会增加运维面。校准可能在容易的全票一致轮次上好看,在真正决定门禁的模糊轮次上崩塌。在 mock 上选的级联阈值会在生产误触发。托管 Jev 把第三方依赖嵌进评测路径。开源 Decider 2B 在细腻的 helpfulness 上可能弱于更大裁判。
这些保留支持的是“级联 + 校验”,而不是扔掉决策模型。方法骨架是:把可设阈值的窄检查与解释性裁判分开;两者都对照自有流量上的人工;把 LLM 裁判预算花在置信低的地方。
[1]谁买单,看什么
在高采样率下跑在线代理评测的团队,应在加更多内置项前先算每轮 LLM 裁判花费。平台组应把决策模型问题当作与提示词并列的版本化产物。采购“代理评测”套件时应要人工一致率表与级联跳过率,而不是只看内置名称列表。
接下来看:公开标注集上 Jev、Strands Decider 与 Bedrock 内置在同一轨迹上的对比;75–90% 跳过带能否离开 HR 演示成立;AgentCore 是否提供标准的阈值选择工具。
[1]收束
AWS 可用的句子不是决策模型让 LLM-as-judge 退役,而是:在自有流量完成人工校验之后,代理评测会在“每轮校准筛查、只在不确定时动用昂贵裁判”时更便宜也更稳。 六个月后,要么更多团队公布带一致率表的级联跳过率,要么评测花费继续与每一轮生产流量线性上涨。
[1]