
要点
- Autobench Router Benchmark(ARB)对七套常见商业/开源路由器、17 个表头设置做了预注册、成本感知审计:长开放题、真实账单成本。
- 奖赏区存在:按题选仍过质量门槛的最便宜模型可达 100% Delta-Hit、约 $0.0018/题;Always-Sol 仅 87.5% 却约 $0.079。
- 捕获为零:没有任何商业设置同时打赢 Always-Luna(约 85.3% @ $0.0043)的质量与成本;10,000 次 bootstrap 亦无例外。
- 17 个设置中有 5 个 ≥90% 决策塌缩到单一模型;跨厂商 59 对路由的同选率中位数为 0。
2026年10月26日,Peter Kruger 代表 Autobench 在 Hugging Face 发布 AutoBench Router Benchmark(ARB):问题不是「路由能不能省钱」,而是更硬的一句——在长开放题、按真实账单计费的池子里,你买的「路由器」是在按题选模,还是只是挡在常量前面的旋钮?作者对七套常见系统、十七个表头设置作了**规则先锁定(2026-08-29)再呼叫路由器(约 8月30日–9月1日)**的预注册审计。结论刺耳:没有任何商业设置在质量与成本两条轴上同时打赢「永远调用中档价模型 Always-Luna」;若干「路由」实质上是常量策略。
[1]发生了什么
ARB 沿用 AutoBench 的 lookup 设计:先固定 252 道跨十领域、五难度的开放题,让池内 20 个模型各答一次,十模型评审委员会打分并记下真实账单成本;路由器只负责点名模型,分数与费用按矩阵回查——路由器无法靠「写更好答案」刷分。质量指标是 Delta-Hit(Best Answer rate):所选模型在该题上的存档分是否落在池内前三附近的锁定窗口;随机策略约 64.7% @ $0.0115,应对照这条线而非 100%。
「奖赏」被画成图中一块区域:质量高于随机、成本低于随机。Always-Luna 已坐在那里(约 85.3% @ $0.0043)——接近 Always-Sol(87.5% @ $0.079)的质量、约 5% 的账单,且无需路由器。完美按题选「仍过质量门槛的最便宜模型」可达 100% @ $0.0018;完美选最优模型约 100% @ $0.034。路由承诺要收割的,正是相对 Always-Sol 约 12 个质量点、以及约 98% 的成本差。
[1][2]证据有多硬
主结果是负结果,且写法刻意可证伪:奖赏象限对商业路由器为空。十七个设置无人同时击败 Always-Luna 的质量与成本;作者称对数据做 10,000 次 bootstrap 重采样,仍无设置做到。便宜档常贴在随机质量线上——因为塌缩到某一个 flash 模型;强档买到强模型,于是贵过随机。钱的去向同样刻板:便宜路由大量落在「便宜 miss」,强路由落在「昂贵 hit」,本应证明路由价值的「便宜 hit」始终是少数。
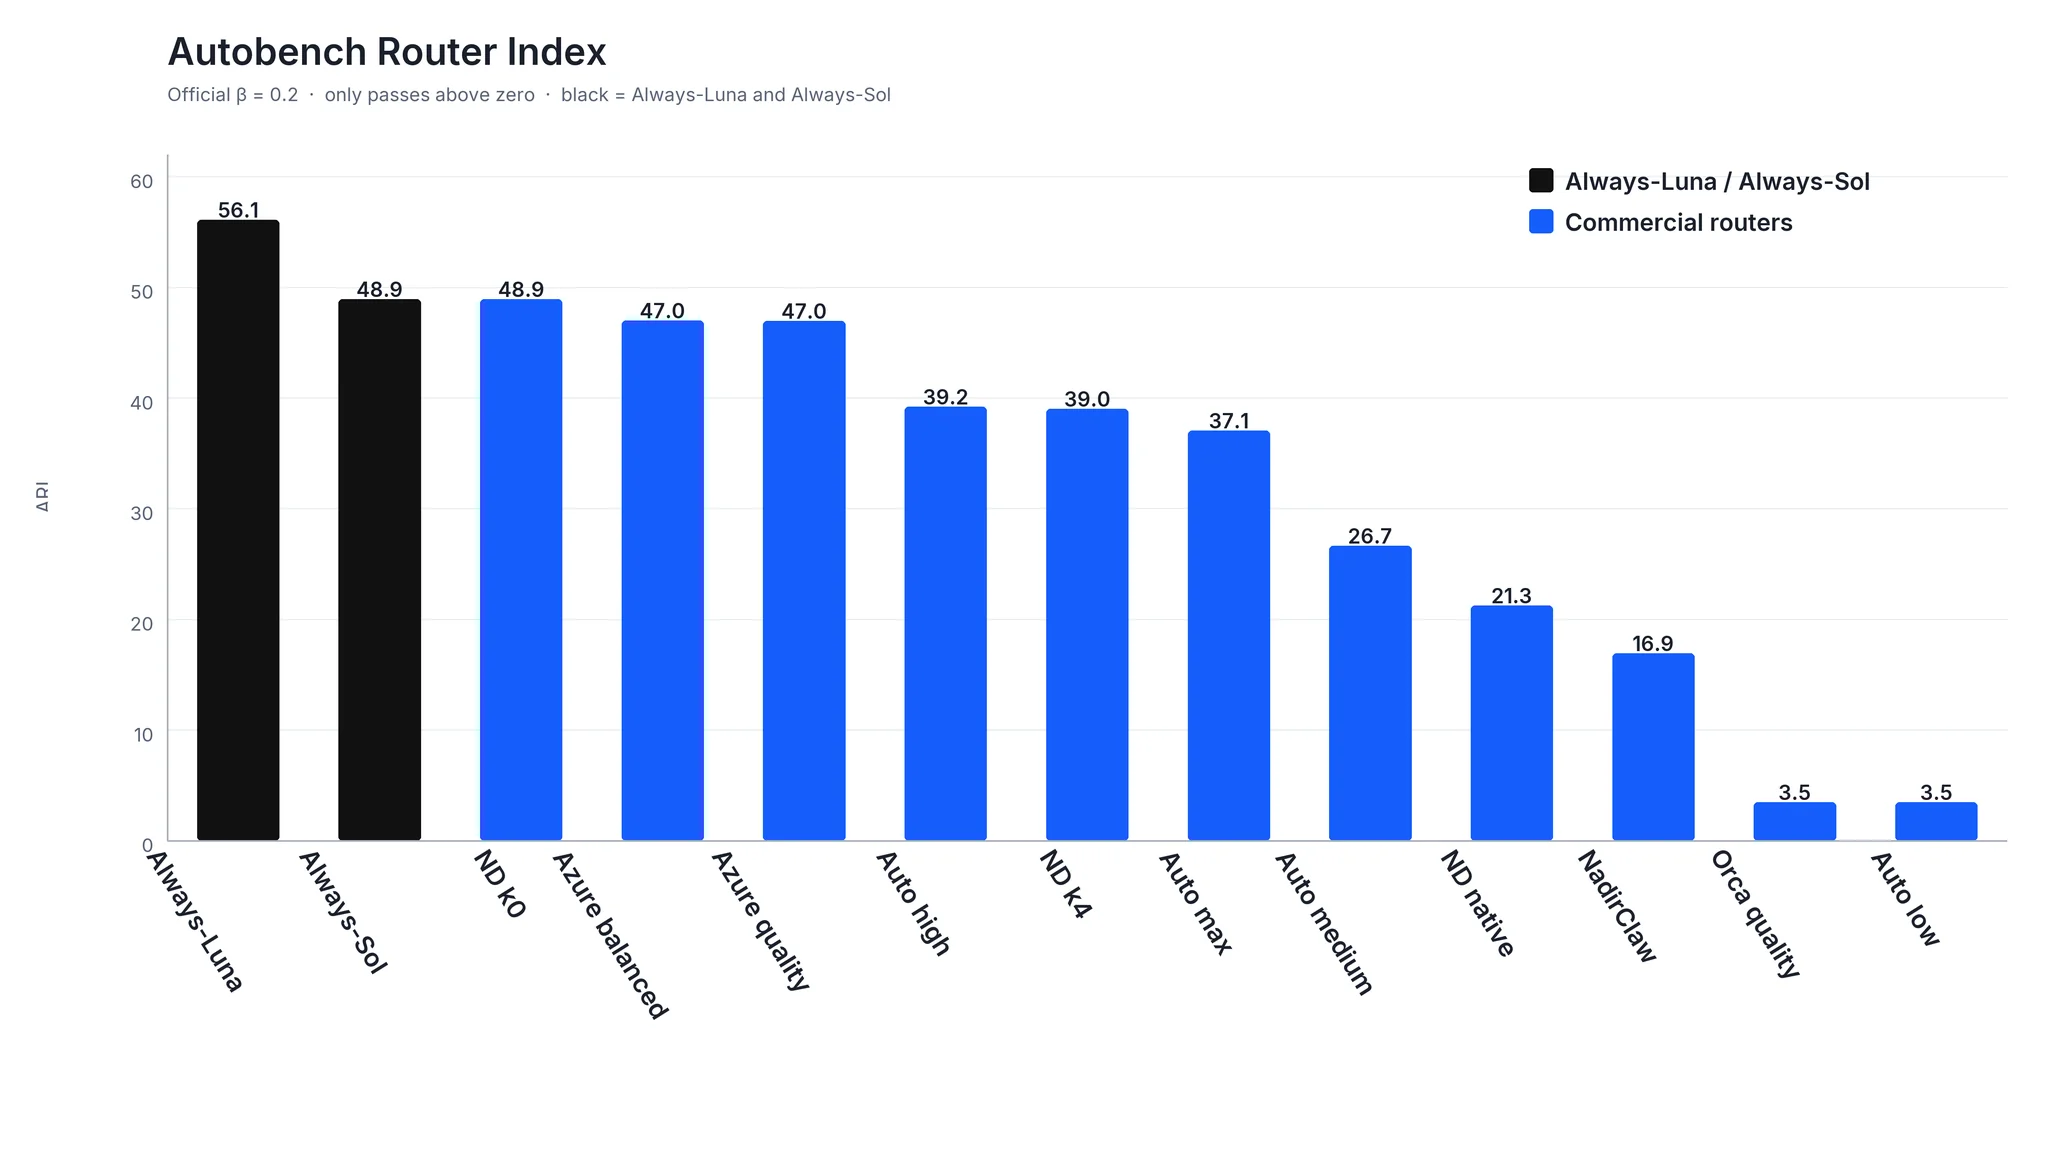
行为指标与单一分数并列:五分之十七的设置 ≥90% 决策给同一模型(质量分≈该模型分);Not Diamond 的成本–质量旋钮在 knob 4→5 呈现悬崖(约 80.3% @$0.060 落到约 46.6%、低于随机);OpenRouter Auto / Orca 的档位更像花销层而非逐题路由。跨厂商 59 对的同模选择率中位数为 0(57.6% 的对恰好为 0)——若存在可发现的「每题正解」,独立路由器本应收敛;高一致处常可用「共享塌缩到同一廉价模型」解释。联合指标 Autobench Router Index(β=0.2)上 Always-Luna 仍领先,商业通道相对其无正提升。
[1]钢人与缺口
钢人:若干系统只能触达池子切片(Not Diamond 7、NadirClaw 4、Azure/Brick 各 3),报告读的是切片内行为而非全宇宙排名;Brick 以「出厂、未针对该池调优」方式跑,失败更像分布偏移。短选择题榜单(如 RouterArena 类设定)上,廉价模型常已是最优选,恒指向它的「路由」会显得很强——ARB 刻意换成长开放、账单贵一到两个数量级的题,故事才会变安静。作者也公开数据与决策日志,声称可在不重呼路由器的情况下重算表格。
仍须保留的限制:252 题、单一时间窗的路由器版本、LLM-as-judge 委员会、以及「前三窗口」的 Delta-Hit 定义都会塑造分数;企业私有流量分布未必复现公开池。负结果打击的是这批已上架产品在该板上的联合承诺,不是「任何未来路由算法都不可能收割奖赏」。白皮书标题本身也是提问式:《Do LLM Routers Pay for Themselves?》。
[1]谁付钱、谁该改问题清单
对采购方:若路由器打不赢「永远打中档价最强静态策略」,你买的是 UX 与计费层,不是已被证明的逐题优化器。博客给出五问——静态基线是什么、顶模占比是否 ≥90%、旋钮有没有中间态、两个独立路由器是否只因共享塌缩而一致、宣称是在短选择题还是长开放账单板上测的。对云与网关厂商:把「Auto / quality / low」说成智能路由,在 ARB 上看更像档位常量;披露 collapse share 与同选率,比再贴一张准确率雷达图更诚实。对评测社区:RouterBench 类离线矩阵仍有价值,但若评测分布便宜到「永远选最便宜就赢」,商业故事会被系统性高估。
[1]六个月看什么
下一科学增量,按作者说法,贵在扩题库(含释义集、分域与 agent 切片),而非在同一 252 题上加长厂商名册——新路由器的计分已是 lookup。买方侧可执行的证伪很具体:在自有长提示流量上,强制对照 Always-「中档」静态策略,报告质量、真实美元、以及顶模占比;若仍进不了「高于随机质量且低于随机成本、并打赢该静态策略」的区域,ARB 这篇预注册审计就不是惊悚标题,而是采购基线。奖赏是真的;截至这张板,商业路由器还没把它收走。
[1][2]