
要点
- 具名采用者包括 Xiaomi MiMo-V2-Flash(命名 MOPD)、DeepSeek-V4、Moonshot Kimi K3、NVIDIA Nemotron 3 Ultra、Liquid AI LFM2.5、Mistral Large 4 等。
- 三阶段配方:通用 SFT → 分域 RL 专家 → 融合(每条提示由其域教师打分,通常对学生词元做 reverse KL)。
- TRL AsyncDistillationTrainer 用 teacher_id 与 teacher_server_urls 路由;Hub 上有 Open-MOPD 数学/代码/指令专家;示例可用 HF Jobs h200x4 启动。
- 在提示 40/40/20 的 60 步 TRL 跑中,指令遵循词元占比落到约 1-3%;数学/代码靠近教师,指令遵循几乎不动。
- 评测表:MixSFT 的 AIME24/AIME25/IFEval 为 17.5/19.2/67.5;60 步 MOPD 为 24.2/22.5/73.0;Open-MOPD 终局为 19.2/25.0/75.8。
Hugging Face TRL 博客(Sergio Paniego)不是一篇软性的「蒸馏很流行」。它是在说:实验室如何把多枚分域 RL 专家收成一个模型,以及你若照抄配方却不看词元,会在哪里静默失败。Xiaomi 在 2026 年 1 月为 MiMo-V2-Flash 命名 Multi-Teacher On-Policy Distillation。此后 DeepSeek、Moonshot、NVIDIA、Liquid AI、Mistral 等陆续采用变体。TRL 的 AsyncDistillationTrainer 现在让外部团队也能用已部署教师与 teacher_id 列跑融合阶段。
[1]实际发布了什么
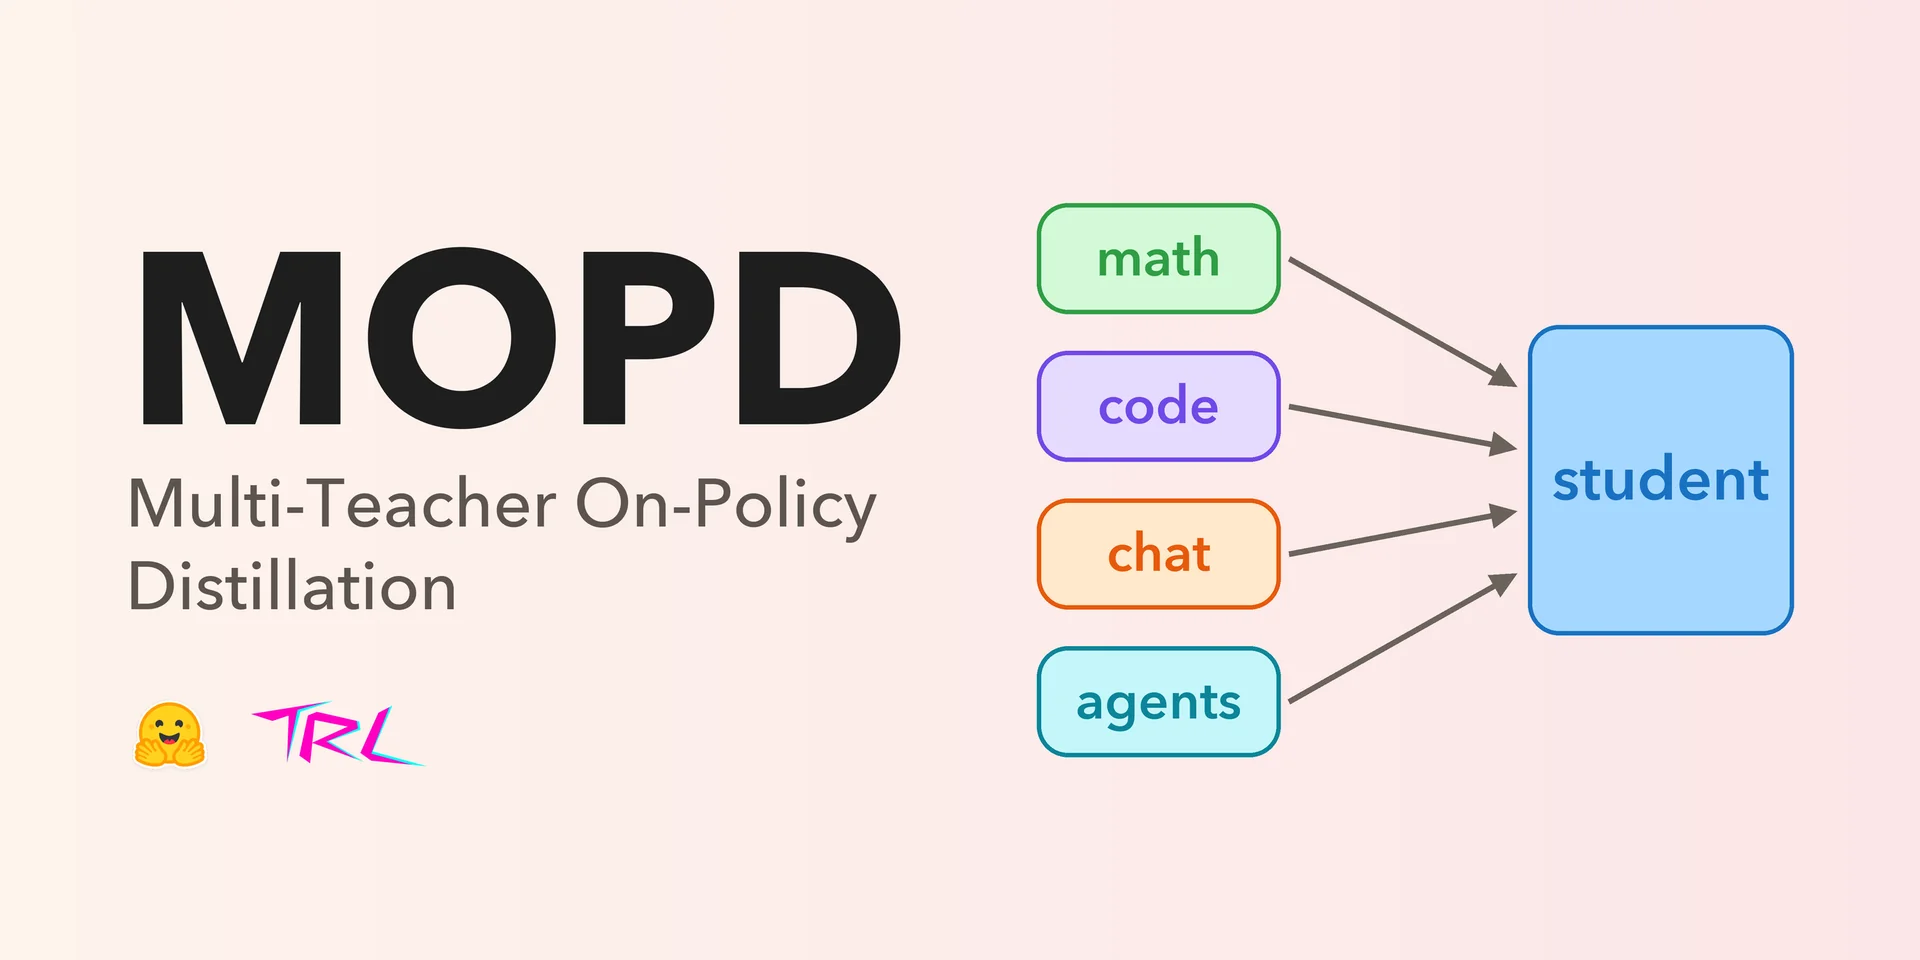
严格说,MOPD 是三阶段后训练的最后一环,尽管实验室常把整条路径都叫这个名字。第一阶段:在混合数据上做通用 SFT。第二阶段:从该检查点为每个域训练一枚 RL 专家。第三阶段:学生(常常仍是 SFT 检查点)回答各域提示;该域专家对学生答案逐词元打分,学生被推向该教师的分布,常用 reverse KL。学生学的是自己采样出的文本;信号按词元变密,而不是整答一个奖励;每条提示只交给一名教师。
各家对教师分布用量不同。Nemotron 3 Ultra 与 MiMo-V2-Flash 只用学生写出的那个词元的教师概率。Open-MOPD 比较前 16 个词元。DeepSeek-V4 与 Mistral Large 4 在单词元反馈不稳定后改用全词表分布。教师通常与学生同规模,并共享分词器。
文中采用者表从 Xiaomi MiMo-V2-Flash 写到 DeepSeek-V4、Moonshot Kimi K3(按域与推理力度共九名专家)、NVIDIA Nemotron 3 Ultra(十余名教师、两轮 MOPD)、Liquid AI LFM2.5、Mistral Large 4(按推理力度而非域分教师)及相关发布。NVIDIA 还把五枚 Nemotron 教师放到 Hub。Open-MOPD 公开完整配方与检查点,供 TRL 示例使用。
在 TRL 中,AsyncDistillationTrainer 接收 teacher_server_urls 映射与每行 teacher_id。生成、教师打分与训练异步并行。示例用 Open-MOPD 的 SmolLM3-3B MixSFT 学生,以及数学、代码、指令遵循的 GRPO 专家,提示按 40/40/20 交织。beta=1.0 的 reverse KL 对齐 Nemotron/MiMo 的单词元教师 logprob 风格。launcher.py 可把学生 vLLM、三名教师与训练塞进四张 H200,并用 HF Jobs 一键启动。
[1]台面上的证据
主证据是 2026-11-03 的 Hugging Face 博文:采用者表、三阶段示意图、AsyncDistillationTrainer 代码路径、HF Jobs 命令,以及 60 步指标。该短跑中,指令遵循起初词元份额尚可,一旦数学与代码答案变长,就落到约 1-3%;数学/代码的 teacher_jsd 下降,指令遵循几乎不动。评测表对比 MixSFT、60 步检查点与论文终局 Open-MOPD 在 AIME24、AIME25、IFEval 上的分数。代码评测未跑。作者指向 Open-MOPD 论文中的不均衡诊断与修复。TRL MOPD 的跨实验室独立对打,文中没有。
[1]钢人与缺口
钢人。单次混合 RL 会让各域在每个 batch 里互相拉扯。先训分域专家再融合是合理答案;on-policy 逐词元蒸馏也减轻「只在教师文本上 SFT、推理时却要续写自己」的错配。开放教师与 AsyncDistillationTrainer 之所以重要,是因为多数实验室只发布最终融合模型。
缺口:60 步大约只是论文训练长度的 1%,绝对分数是冒烟测试,不是 TRL 已追平生产 MOPD 的声明。提示重平衡到 40/40/20 后 IF 仍在词元上挨饿,这正是论点。top-k=1 的 reverse KL 并不复现 Open-MOPD 的 top-16 比较。全词表教师更吃带宽。没有同词表 RL 专家的人,没法干净接入。
[1]谁该在意,下一步看什么
做开放后训练的团队、已有分域 RL 专家的实验室,以及只盯提示配比的评测设计者,应把 teacher_token_frac 当成主要看板指标。未来六个月看:是否有更多实验室公开专家检查点;同步版 DistillationTrainer 是否落地;公开配方是否默认采用 Open-MOPD 式重加权;以及在强制词元占比接近提示占比后,IFEval 类短域是否不再落后。
[1]收束
耐看的句子不是「蒸馏是新事物」。而是:多教师 on-policy 融合已成为可共享的前沿配方,且能在 TRL 里跑;静默失败点是词元占比,不是提示占比。六个月后,要么开放 MOPD 跑分在榜旁公开每教师词元份额,要么短答域会继续看起来「训过了」,却几乎没被更新。
[1]