
要点
- Refit:每步把训练 GPU 上更新后的策略权重拷到分离部署的推理 GPU;双方并行布局不同(TP/PP/EP/DP/context)。
- Gather-and-broadcast 先拼全量再广播;逻辑载荷约等于权重大小的两倍(Kimi K3 约 11.2 TB,Qwen 3.8 2.4T 约 9.6 TB,按 BF16)。
- Reshard 只搬分片交集;开源 NCCL M2N Reshard;按 NVLink 域聚合,避免重复过网。
- NeMo RL 混合路径:约占参数 95% 的前馈投影走 Reshard,小权重仍走 gather-and-broadcast 以保覆盖。
- 基准:H100 上 Qwen3 235B 6.4s→1.9s;DeepSeek v3 14.9s→2.6s;GB200 上 DeepSeek 6.1s→2.3s;Nemotron Ultra 8.2s→2.3s;Qwen3.8 2.4T 微基准 4.3s。
2026 年 11 月 6 日,NVIDIA 开发者博客称:强化学习后训练里,训练 GPU 每次向推理 GPU 刷新权重都在付一笔越来越大的税。软叙事是又一个 NCCL 特性。更锋利的句子是运维句。当开源策略靠近数万亿参数,gather-and-broadcast 的 refit 已意味着每步约十 TB 量级逻辑流量,稀缺的是如何在不匹配的并行布局之间搬分片,而不只是如何采样。 若 Reshard 在故障恢复导致布局抖动时仍能保住 NeMo RL 上 2.7×–5.7× 的时延收益,主张成立。若团队写不出 DTensor 描述,或混合路径把载荷重新胀大,它就缩成微基准。
[1]实际发布了什么
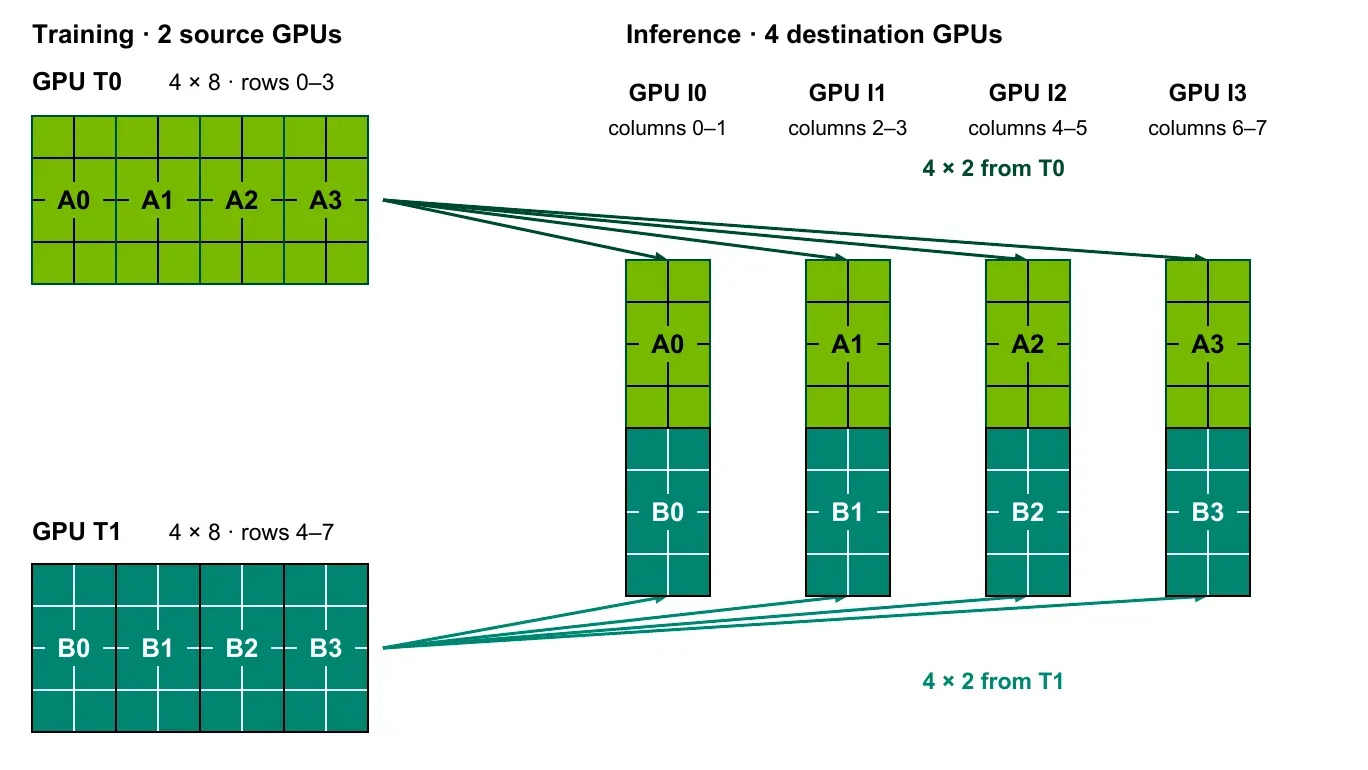
分离式 RL 里,推理与训练用不同并行切分。经典 refit 在训练侧 all-gather 每个参数,再把完整张量广播到推理 rank,各 rank 留下本地分片。这简单,也浪费:目的端收到稍后会丢掉的字节。
Reshard 把任务改写成:把一个分布式张量搬进另一种分布。源与目的的 DTensor 描述(全局形状、device mesh、placement)即可发起调用。NCCL M2N Reshard 计算分片交集,再映射到 NVLink 域,使每份贡献只过一次网络,副本用 NVLink 补齐。
NeMo RL 在非同置推理时可用 refit_transport: nccl_reshard。因各层切分边角多,参考设计让占主导的前馈投影走 Reshard,较小张量仍走 gather-and-broadcast。
台面上的证据
表 2 是硬核。DGX H100 上,Qwen 3 235B(TP4×PP8×EP16 → TP8×DP16)从 6.4 秒降到 1.9 秒;DeepSeek v3 671B(PP16×EP16 → TP32×DP8)从 14.9 秒降到 2.6 秒。DGX GB200 上同一 DeepSeek 布局从 6.1 秒到 2.3 秒;Nemotron Ultra v3 从 8.2 秒到 2.3 秒。仅 refit 的微基准给出 Qwen3.8 2.4T BF16 用时 4.3 秒。
载荷算术也不含糊:BF16 权重字节乘约 2(all-gather + broadcast)。权重已近 5 TB 的模型,每步逻辑流量就在约 10 TB。
[1]钢人与缺口
钢人。 大实验室已经在用分离式 RL 换效率。通信库应吃掉布局数学,框架只需吐 DTensor 元数据。开源 M2N Reshard 让非 NVIDIA 栈可对照。混合覆盖是工程诚实,而不是宣称边角全灭。
缺口:数字是 NVIDIA 栈上的 NVIDIA 结果(NeMo RL、NCCL、DGX)。加速的是 refit 时延,不是端到端每美元 token。「最新 LLM 前馈约占 95%」在此文未附逐模型表。NeMo RL 遇成员变更仍销毁重建通信域;shrink/grow 属后续。其他框架或已有定制 P2P,可能收窄差距。
[1]谁该在意,下一步看什么
在独立推理池上训大策略的团队,应把 refit 秒数当成一级预算。集群架构要问集合通信能否看见 NVLink 域拓扑。冲万亿参数 RL 的开源实验室,要看 4.3 秒级 refit 在混合精度与专家并行下是否仍真实。
未来六个月看:第三方框架是否接入 nccl_reshard 或等价物;是否出现把 refit 单独拆出的端到端 RL 步进分解;NCCL shrink/grow 是否落地,使 reshard 在节点故障后不必整组重建。
收束
这篇容易被读成「集合通信更快」。耐看的句子是:前沿权重规模上的 RL,正在变成「两个在线布局之间最少必要字节」的分布式系统问题。 六个月后,要么 Reshard 类路径出现在 NVIDIA 博客以外的步进耗时报告里,要么 gather-and-broadcast 那笔约 10 TB 的税,仍会安静地限制策略能更新得多勤。
[1]