
要点
- AWS ML Blog(2026-11-03)演示在 Amazon SageMaker AI 上用序列级知识蒸馏(SeqKD)把 Bedrock 上的 GLM-5.3 教师行为压进 Qwen3.5-4B 学生。
- ShoppingBench:750 题拆成 426 训练 / 324 留出;教师温度 1.0 每题采样两次共 850 轨迹,基准自带打分器只保留已解轨迹;逐步编码约 2600 训练行。
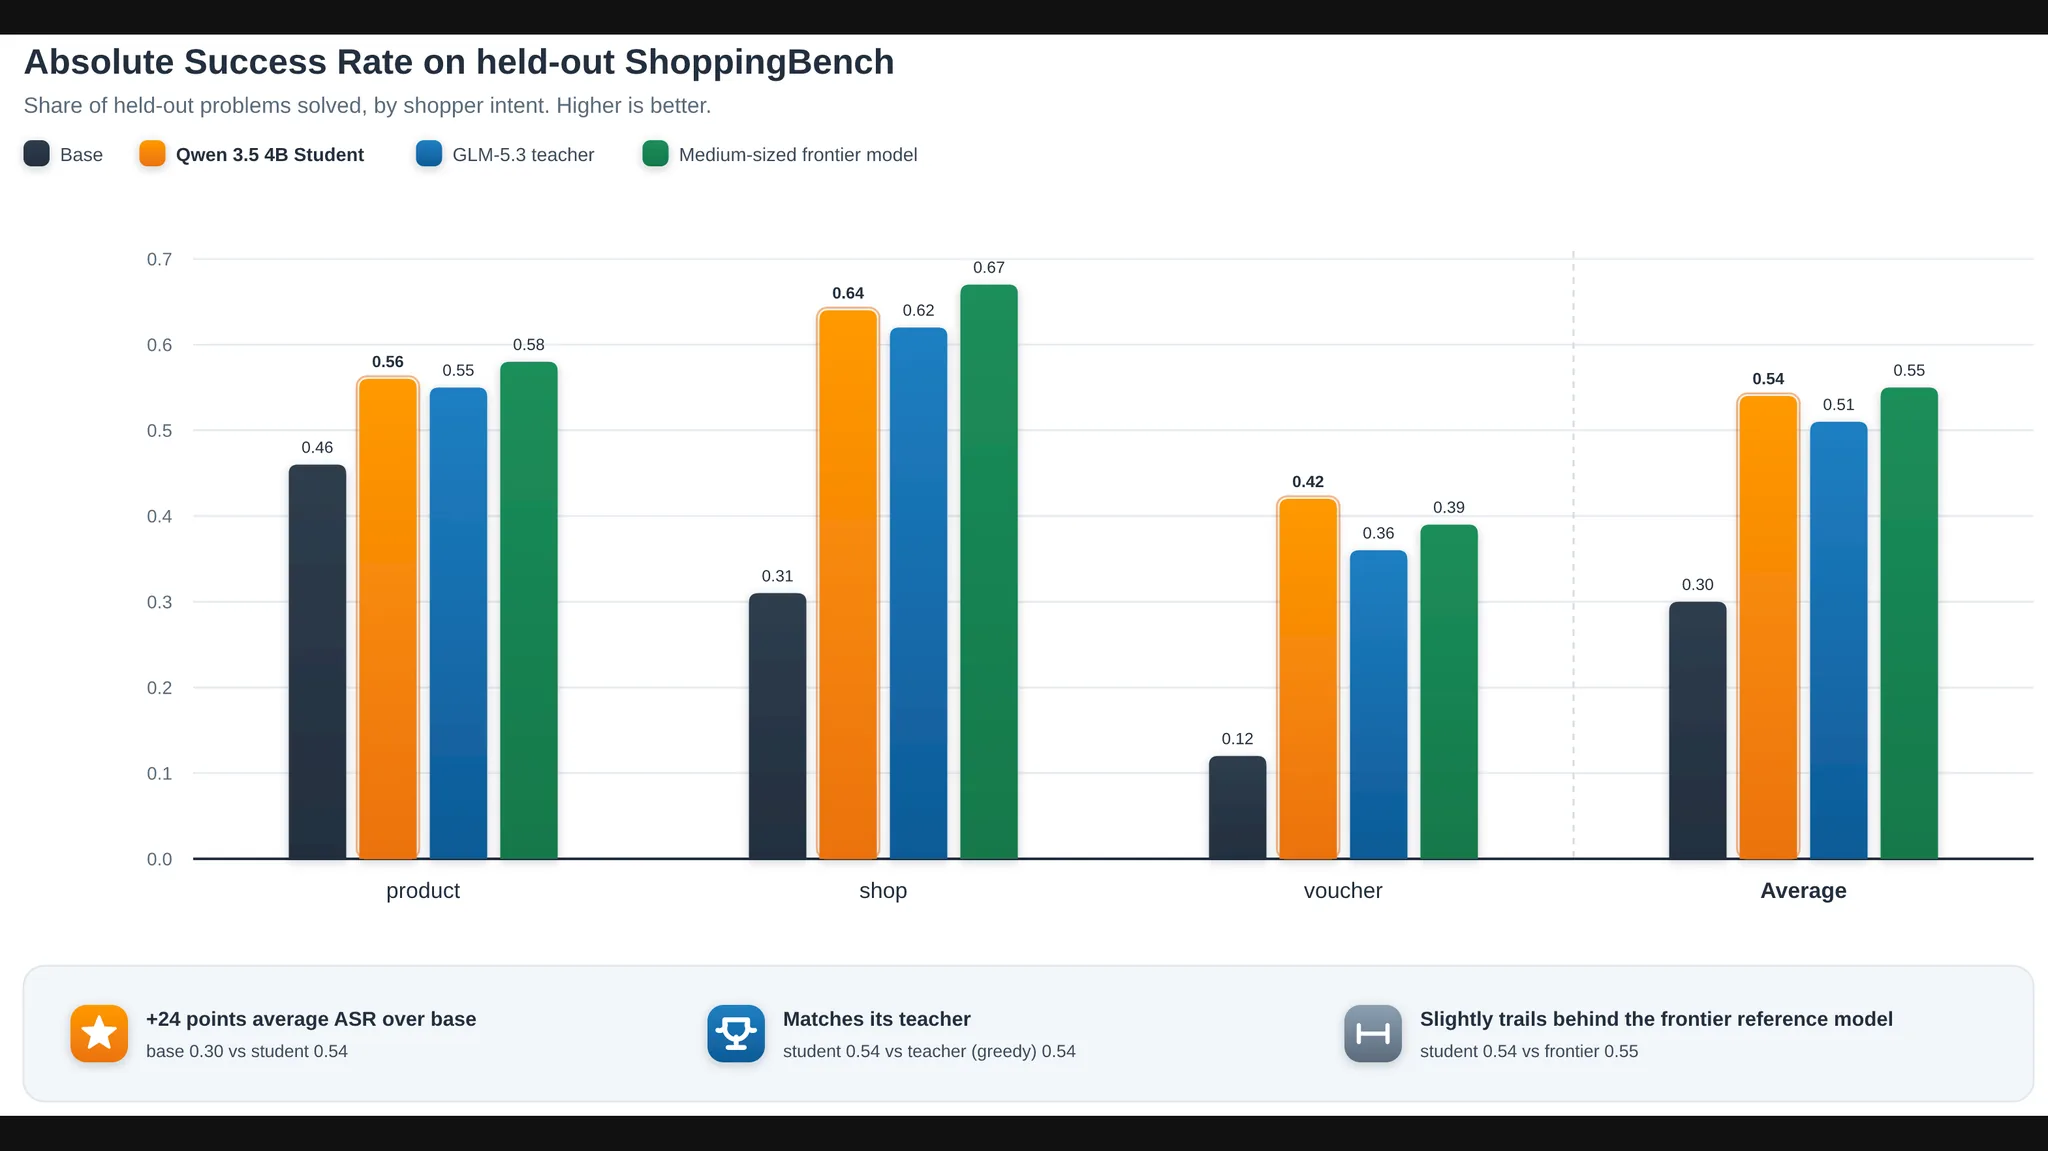
- 留出集 Absolute Success Rate:Base 4B 平均 0.297 → SeqKD 学生 0.541;贪心教师 0.540、采样教师 0.511、中型前沿 0.546。去推理只留工具调用 → 0.415(约 −13 点)。
- IFEval 提示严格分 0.819→0.741、指令严格 0.872→0.813(约 −6~8 点)——专业化有回归代价;作者称 SeqKD 是第一步,难尾可用 on-policy 续训。
你做出了一个能用的购物助手:用户说「找一个二十美元以内、店铺评分至少 4.5 的黑色腰包」,agent 搜索、核对约束、再给出推荐。问题不在单次调用,而在循环计费——搜索、读结果、收窄、校验、决策,每一步都可能是一次前沿模型账单。AWS 机器学习博客在 2026 年 11 月 3 日的文章里,把对策钉在序列级知识蒸馏(SeqKD):让 API-only 的教师写出整段工具轨迹,用基准打分器只留下「解出来」的样本,再在 Amazon SageMaker AI 上对小模型做普通监督微调。
中心判断很具体:生产级多步工具 agent 的可持续路径,不是永远把前沿模型留在循环里,而是蒸馏「已解轨迹」——并且推理文本要一起留下。
[1]发生了什么
SeqKD 在蒸馏谱系里处在「只要教师文本」的一端:不需要教师权重、logits,也不需要 RL 基建,因此对只能走 API 的前沿模型仍然可行。对 agent 而言,被复制的序列不是一段散文,而是按时间排列的推理、工具调用与环境观察。
流水线用 ShoppingBench(约 270 万商品目录上的合成购物题)做可编程打分:750 题按 product / shop / voucher 意图各 250,固定切成 426 训练与 324 留出。教师 GLM-5.3(Bedrock,reasoning on,温度 1.0)每题采样两次,得到 850 条轨迹;打分器只保留满足全部约束的推荐。已解轨迹按步展开成 chat 行(约 2600 训 / 130 验),损失只落在助手步——学的是下一步推理+动作,而不是复述观察。学生为 JumpStart 上的 Qwen3.5-4B,LoRA 无服务器 SFT,再挂到带工具循环的实时推理端点。
[1]证据有多硬
主张被钉在留出集 Absolute Success Rate(ASR)表上,且按意图拆开。Base Qwen3.5-4B 平均 0.297;SeqKD 学生 0.541;贪心教师 0.540、采样教师 0.511、文中对照的中型前沿模型 0.546。作者强调单次 LoRA 跑有若干点波动,但「4B 基本收回教师任务质量」写得很清楚。
更关键的消融是推理:同一批轨迹若剥掉推理块只留工具调用,平均 ASR 从 0.541 掉到 0.415(约 13 点),且三个意图都掉——工具调用 alone 仍高于 base,但把学生送到教师档位的是夹在动作之间的推理。学生还能略高于采样教师,因为拒绝采样让它模仿的是教师「解出来」的切片,而不是平均输出。回归检查用 IFEval:提示严格 0.819→0.741、指令严格 0.872→0.813,约 6–8 点,被明确写成专业化代价,而不是藏起来。
[1]钢人与缺口
钢人:当教师只能走 API 时,SeqKD + 可编程打分器是少数仍可落地的蒸馏路径;温度 1.0 采样再过滤,把「教师不够稳」转成「训练集更干净」;按题而非按行切分避免近重复泄漏;压缩观察以迁就长度上限是工程诚实。
缺口同样硬。ShoppingBench 是合成题与隐藏金标,外推到真实目录噪声、库存动态与欺诈约束未证明。中型前沿对照未点名具体型号。学生匹配的是任务 ASR,不是通用能力——IFEval 下滑已写明。作者自己把 SeqKD 定位为强第一步:最难尾部若拒学,需要文中未展开的 on-policy 方法让学生在自身 rollout 上学习。LoRA 单次跑的点波动也限制「精确追平」的统计强度。
[1]谁付钱、谁该改问题清单
对产品与财务:若 agent 账单被「每步前沿」吃掉,问题清单应包含——有没有可编程成功判据、能不能拒样教师轨迹、推理是否进训练目标、留出集是否按题隔离。对平台:无服务器 SFT + 轨迹资产复用,降低「为每个学生重建蒸馏栈」的固定成本。对评测:只报相对 base 的涨幅不够,必须并排教师贪心/采样与中型前沿;同时报一条通用回归。
[1]六个月看什么
可证伪下一跳:在非购物、非合成金标的工具域,保留推理的 SeqKD 是否仍能把 ≤8B 学生送到 API 教师贪心档;若打分器变噪声或只能人工抽检,拒绝采样红利还剩多少;on-policy 续训能否在不进一步打伤 IFEval 的前提下吃掉难尾。主张不是「小模型已经普遍取代前沿 agent」,而是:对有硬成功判据的多步工具任务,已解轨迹上的 SeqKD(推理保留)可能比把前沿留在每个循环步骤更接近可运维的成本曲线。
[1]