
要点
- 同一模型(GLM-5.3-flash),同一批 90 道 AppWorld 题、30 个场景、每题一次尝试,在 Harbor 框架中计分。作者的 Harbor 分支已公开。
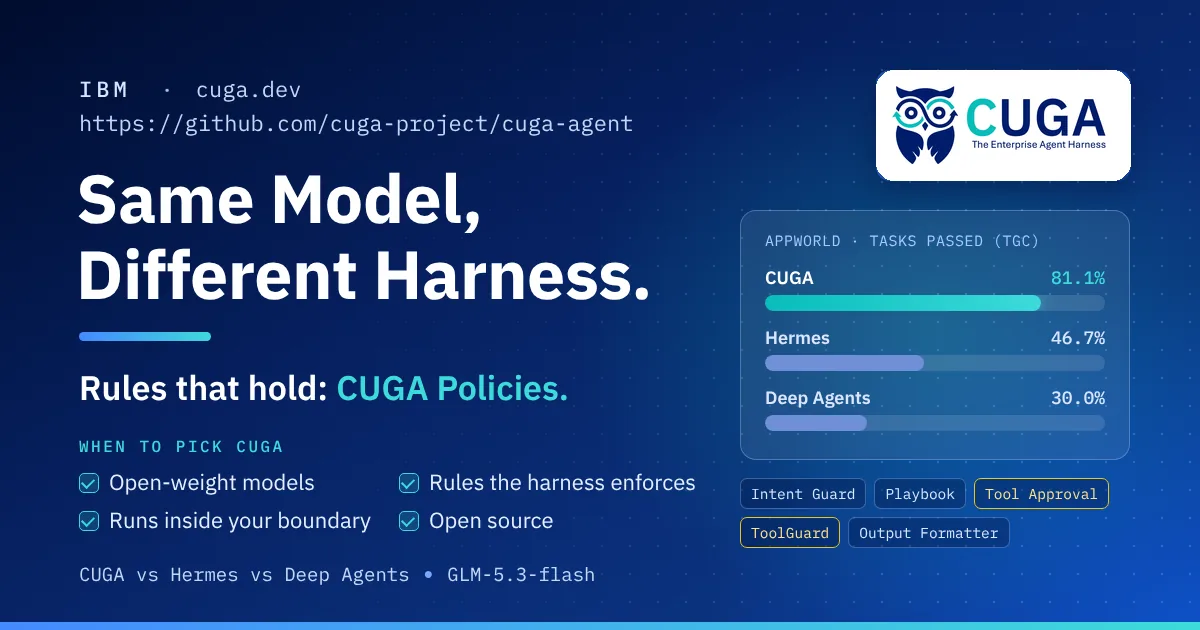
- 任务成功率:CUGA 81.1%(73/90),Hermes 46.7%(42/90),Deep Agents 30.0%(27/90)。场景成功率要求一个场景的三种变体全部通过:CUGA 66.7%(20/30),Hermes 26.7%(8/30),Deep Agents 6.7%(2/30)。
- 另一项被引用的 SWE-bench Pro 分析(不是本次实验)显示,同一 GLM-5.2 模型在只更换运行框架时,从 23% 升到 52%。
- CUGA 的 AppWorld 配置会按应用拆任务、筛选工具、让模型写 Python 在沙箱里调用接口、在改数据的代码运行前先检查,并在事后复盘。
- 策略可以作用在意图、流程剧本、工具批准、工具护栏和输出格式上。Policy Playground 里,一句「把我欠的都付了」让没有策略的智能体付了 90 美元,包括一笔被拒赔的账款;有策略的智能体先请求批准,然后只付了到期的 10 美元。
2026 年 11 月 3 日,IBM Research 在 Hugging Face 发文,把常见问题「该买哪个模型」写成了问错方向。社区清单现在追踪将近 200 种 agent harness,也就是给模型配上规划、工具和检查的运行框架。作者固定模型,只换这套运行框架。在 AppWorld 的 90 题切片上,完成率从 30.0% 挪到了 81.1%。
[1]实际发布了什么
AppWorld 是一个跨 9 个消费级应用、457 个接口的多步任务基准,包括邮件、支付和文件存储。作者把它称作代理指标,不是完整的企业套件:它测试登录、阅读接口文档、翻页,以及在多个应用之间改状态。他们用 CUGA(IBM 的 Configurable Generalist Agent)、Nous Research 的 Hermes,以及 LangChain 的 Deep Agents,全部搭配 GLM-5.3-flash,在同样的 90 道题、30 个场景上各跑一次。
CUGA 用的是它的 AppWorld 配置:AppWorld 说明、任务分解、执行前检查,以及自动复盘。Hermes 用 Harbor 默认的 Hermes 设置,并通过 MCP 接上 AppWorld 工具。Deep Agents 同样通过 MCP 接工具,外加按 469 个工具配置的 LangChain 中间件,包括工具选择、上下文摘要、待办列表、重试和调用上限。作者还加了两处小修补,避免格式不良的 GLM 回复直接结束 Deep Agents 的运行。
他们报告两个分数。TGC 是通过的任务比例。SGC 是「一个场景的三种变体全部通过」的比例,因此奖励的是稳定性,而不是一次走运。CUGA 达到 81.1% 的 TGC 和 66.7% 的 SGC。Hermes 是 46.7% 和 26.7%。Deep Agents 是 30.0% 和 6.7%。作者说,这不是对 Hermes 或 Deep Agents 的判词:它们分别面向一直在线的个人助手和偏研究的长任务,而不是 AppWorld 这类跨应用接口工作。他们想强调的正是这一点:运行框架必须匹配工作本身。
他们接着说明此次运行中的 CUGA 循环。每个智能体都是准备、调用模型、执行,然后重复。同一循环可以从一个自带工具的智能体,扩展到在本地或远程协调多个智能体的监督者。在 AppWorld 配置里,运行框架按应用把任务拆成步骤;每一步只看见该应用的工具和少数共享工具,而不是全部 469 个;需要时可以再搜索其他工具;模型写出调用接口的 Python;代码在有时限的受限沙箱里运行;任何会改数据的代码块在执行前先经过检查;事后系统查看结果并可以改计划;翻页审查会标记「返回了满页结果、却从未请求下一页」的调用。
这些步骤里的每一步,也都可以用来执行规则。多数团队会把付款批准或「客户数据留在组织内部」写进系统提示词。提示词是指令。模型可能读错,用户可以说服它放弃,插入的消息也可以在任务中途改掉它。CUGA 的策略写在作者的 ACM CAIS 2026 论文 Governance by Construction for Generalist Agents 里,作用在四个位置:意图护栏可以在智能体行动前拦住或直接回答请求;流程剧本给出标准做法;工具批准会暂停运行、出示拟执行的代码并等人确认;带 ToolGuard 的工具指南会在调用前跑检查代码,被拦住的调用到不了工具;输出格式器则把最终回复收成核准过的模板。指导只是在影响模型。批准和 ToolGuard 由运行框架强制执行,不论模型当时怎么决定。
Policy Playground 会把同一句话发给两个实时智能体。面对「把我欠的都付了」,没有策略的智能体付了 90 美元,包括一笔进入催收的拒赔账款。有策略的智能体先把支付拿去批准,然后只付了到期的 10 美元。
作者也写了什么时候不该选 CUGA:终端里的编码工作应使用 opencode、Codex 或 Claude Code;住在聊天应用里的个人助手应使用 OpenClaw 或 Hermes;若你要一张空白的图框架,直接用 LangGraph。CUGA 建立在 LangGraph 之上,面向的是跨接口、应用和网页、并且规则必须能被强制执行的业务工作。它采用 Apache 2.0,可对接任何兼容 OpenAI 的接口,并能在本地、私有或主权云的 Kubernetes,乃至隔离集群中运行。他们写道,搭配托管模型时,CUGA 曾在 2025 年 2 月至 9 月的 WebArena、以及 2025 年 7 月至 2026 年 2 月的 AppWorld 上排在第一。
[1]台面上的证据
主证据是 2026 年 11 月 3 日这篇 IBM Research 文章:设置对照表,73/90、42/90 与 27/90 的计数,场景分数,功能列表,以及 Policy Playground 的例子。比较所用设置公开在作者的 Harbor 分支里。文中写明了三条限制:这是一个基准上的 90 题样本;各方设置并不完全相同;这些运行没有启用策略,因此测不到策略执行。作者还写明,比较由 CUGA 团队运行,且 CUGA 使用了其他框架没有的 AppWorld 配置。他们欢迎把更好的 Hermes 或 Deep Agents 配置送到 harbor-eval,并说会在同一批题目上重跑并公布结果。GLM-5.2 在 SWE-bench Pro 上从 23% 到 52% 的变化,引自 best-of-Agent-Harnesses 汇集的另一项分析,不是这次实验产生的。
[1]钢人与缺口
钢人。买方仍先比较模型,并把外面的包装当成管道。如果同一组权重在跨应用工作上可以完成 30%,也可以完成 81%,差别来自规划、工具可见范围、代码执行和「先检查再写入」,那么包装就是能力的一部分。只写在提示词里的策略,失败方式是可预期的:它可以被忽略。一套能够拒绝调用支付工具的运行框架,是另一种对象。公开 Harbor 分支并征求对手配置,是让这个主张保持诚实的做法。
缺口。比较由 CUGA 团队运行,并使用了 CUGA 专用的 AppWorld 配置,因此标题上的差距混合了框架本身和额外的配方工作。Hermes 与 Deep Agents 并非为这个基准设计,作者承认这一点,而这也让对比更容易。90 道题、每题一次尝试,仍有波动空间。策略故事来自演示场和一篇论文,而不是那张 90 题表,因为那些运行并没有打开策略。独立团队尚未在本文中追平或确认这一差距。
[1]谁该在意,下一步看什么
正在把内部接口上的业务自动化的团队、把支付或隐私规则写进系统提示词并称之为治理的人,以及那将近 200 种已列出运行框架的作者,都该看。未来六个月看:对手配置是否在 harbor-eval 上缩小 AppWorld 差距;买方是否开始问一条规则在哪里被执行,而不只问它有没有被提到;其他实验室是否在第二个基准上重复「同一模型、不同运行框架」的做法。
[1]收束
有用的句子不是「CUGA 赢了选美」。而是:你包在模型外面的运行框架,可以把完成率移动数十个百分点;一条只写在提示词里的规则,仍然只是建议。六个月后,要么公开的同模型比较成为选择智能体栈的常规办法,要么团队还会继续换模型,而那个未受检查的外壳,其实在做看起来像智能的工作。
[1]