
要点
- 2026 年 11 月 9 日,Barry Zhang、Tianyi Peng、Elle Najt、Keller Scholl 和 Lance Martin 在 Anthropic 的 Claude 开发者博客上写了这次玩具实验。
- 今年 9 月,几十个智能体跑着一个大致相当于 Claude Fable 5.1 的内部模型,在 Prove2Me 平台和研究员的指导下,完成了 Anthropic 所称的首个端到端、可由计算机检查的费马大定理形式化。那次花了 11 天、大约 60 亿个输出 token(用来衡量模型写了多少文本),写出了 1300 万行 Lean。
- 新实验用了 1000 个智能体,模型是早期的 Claude Fable 5.2,工具是 Git 和共享的 Postgres 数据库。它在 28.7 小时内结束。
- 每个智能体待在自己的沙箱里,不能上网。分类器会在每条 shell 命令和每次文件修改执行前检查。一百万次以上的工具调用里,没有一次被拦住。
- 助手们一开始把 60 条命题里的 47 条判成预算内做不完。主导后来把大约 750 个助手调去攻坚 Langlands-Tunnell,而这条任务的队长曾估计按时完成的机会不到 1%。团队后来长出一棵有 2418 个节点、最深 10 层的任务树,并在第 28.7 小时把定理送到了主分支。
2026 年 11 月 9 日,五位 Anthropic 作者详细记录了一次玩具实验:1000 个智能体跑着早期的 Claude Fable 5.2,复现了费马大定理的形式化证明。这个定理说,没有任何正整数 a、b、c 能满足 a^n + b^n = c^n,其中 n 大于 2。Andrew Wiles 在 1995 年给出了证明。形式化的意思,是把每一步都改写成 Lean。Lean 是一种编程语言,计算机可以检查其中的每一步。Anthropic 把今年 9 月的那次称为首个端到端形式化:几十个智能体、一个大致相当于 Claude Fable 5.1 的内部模型、专门搭建的 Prove2Me 平台,再加上研究员的指导。那次花了 11 天、大约 60 亿个输出 token,写出了 1300 万行 Lean。新实验去掉了 Prove2Me 和研究员。它用了 28.7 小时,输出 token 大约是上次的三分之一,证明长度大约是七分之一。效率上的差别是实在的。但这并不是智能体对着空白文件、自己证出了一个悬了 350 多年的定理。
[1][2]实验实际做了什么
团队给这些智能体列出了 60 条待证命题,包括最后的定理和 59 个中间里程碑。每条命题附有一行非形式化说明,以及这些命题用到的定义,还有 47 条在 9 月那次形式化里已经证过的引理。提示词里还有一句关于经典证明路线的素描。组织上,提示词只规定了一层层级:一个主导,999 个助手。主导负责拆分问题并分配任务。助手则等主导派活,任务不清楚时再问。实验过程中,外层程序向主导发了 19 次自动提醒,告诉它还剩多少时间,并鼓励它继续做下去。
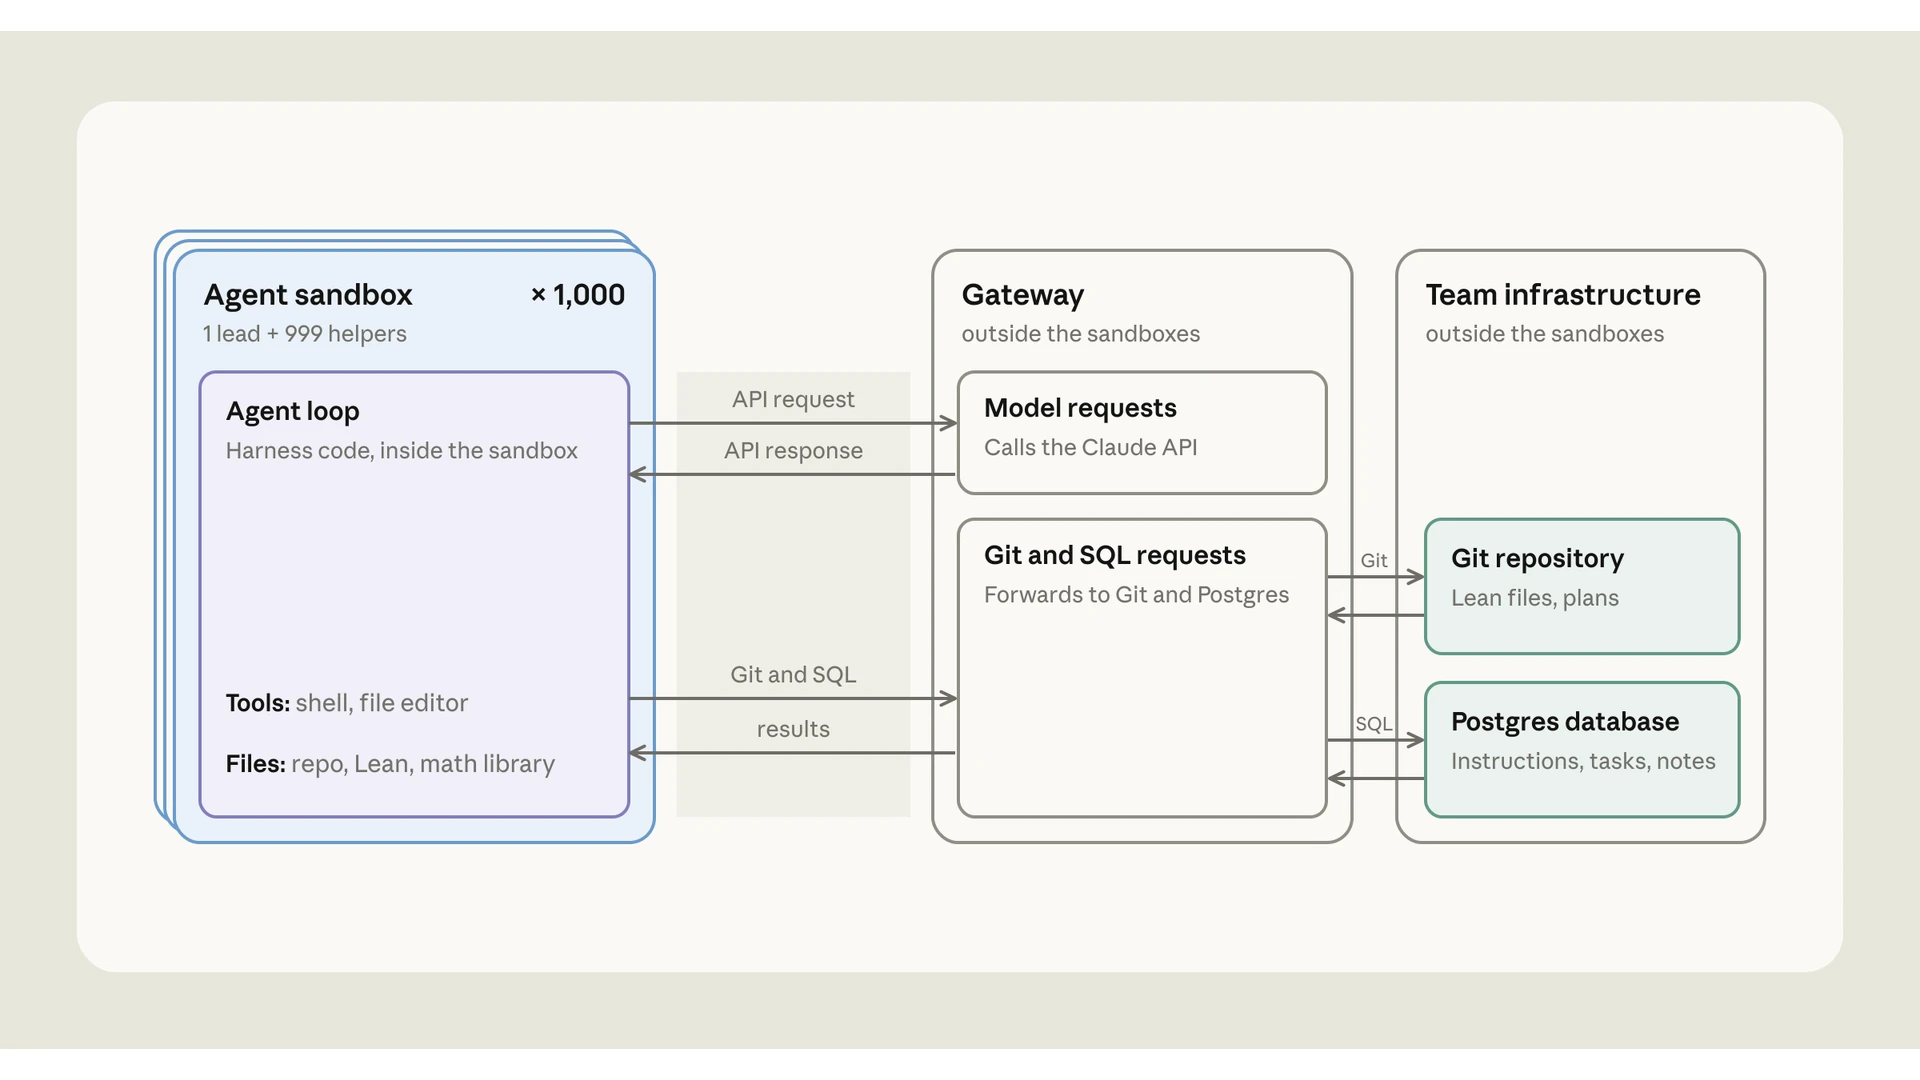
每个智能体在自己的沙箱里有 shell 和文件编辑器,镜像里装好了 Lean 和数学库 Mathlib,还有自己的 Git 分支、向主分支发起合并请求的权限,以及通过 shell 访问共享 Postgres 数据库的能力。一条命题只有在 Lean 的检查器于共享主分支上接受之后,才算证完。
作者把这称作玩具实验,并写明它并不取消对特定领域平台的需要。他们说,Prove2Me 仍可能帮助智能体更快地编译 Lean,并复用人类已有的结果。他们链接的 9 月文章,就是这次被要求复现的先前结果。
[1][2]这1000个智能体如何分工
一台共享机器在大约 100 个智能体时就会耗尽内存、磁盘或 CPU。那些 100 个智能体的实验里,一半以上必须停掉或重来。于是这 1000 个智能体各自待在轻量虚拟机里,靠 SQL 和 Git 协作。作者选择 SQL,是因为它的事务能处理并发写入,而且 Claude 本来就会用。
前 10 分钟里,主导建了五张表:Announce,用来向全队下命令;Assign,用来记录谁负责哪条命题;Notes,一块公开留言板;Subtasks,谁先领取谁就做的待办列表;Landed,已完成工作的日志。它给每条命题分配了 16 到 17 个助手,为每组指定一名队长,并要求每个助手先判断自己那条命题有多难。
大约 27 分钟时,已经有三条命题被证完。主导随后把助手们多数判为预算内做不完的 47 条命题搁下,几乎把全部助手调到剩下的 10 条上。这些小组扩大到 46 到 139 人。大约 70 分钟内,这 10 条全部证完。主导写道,团队的吞吐远高于早期那些"做不完"的判断,接着说没有理由闲着,开始把更难的命题重新派出去。
接近第 18 小时时活动停了下来。作者从上次保存点重启实验,又给了智能体 12 小时。那时剩下的大山是 Langlands-Tunnell,以及依赖它的那些命题。Wiles 的证明用到了这个经典结果。这条任务的队长估计,证明至少需要 70 万到 100 万行 Lean,按时完成的机会不到 1%。主导把大约 750 个助手调过去,并写道,实话说机会不高。
最初的任务对单个助手来说太大了。团队长出一棵树:一块太大就再拆,每块都可以假定底下那些更小的块已经成立。这棵树后来有 2418 个任务,最深 10 层。Langlands-Tunnell 在第 28.4 小时证完,最终定理在第 28.7 小时证完。作者的统计停在 60 条里的 54 条,因为有 5 条备选不再需要,还有 1 条被放下了。
[1][2]安全层拦住了什么,又没拦住什么
作者写,没有任何单层防护足以约束一队智能体。每个沙箱都没有网络。它通向外面的唯一通路,是一根接到网关的管道。网关调用 Claude API,并转发 Git 和 SQL 请求。智能体只能推送到自己的 Git 分支。数据库调用使用共享的低权限角色,每条 SQL 限时 5 秒,超过 256 MiB 的写入会被拒绝。网关在沙箱外给每个请求打上该智能体的身份,避免一个智能体假扮另一个。内核处于锁定模式,去掉了能让 root 用户直接进入的功能。智能体的命令以低权限用户运行,像 sudo 这类能重新拿到 root 的工具也被删掉了。
一个按提示词工作的分类器可以拦住每一次工具调用,包括 shell 命令和文件修改。这次实验里,作者只用了只看动作、不看模型思路的版本。如果拦住的是主导,整支队伍会停下来。如果拦住的是助手,只会移走那个助手。一百万次以上的工具调用里,没有一次达到被拦的标准。作者后来用会看思路的监视器和当前评分标准回放这些调用,只有一次接近被拦,那是在检查自己有没有 root 权限。
他们还在另外的破坏评估里测过监视器。红队智能体试图说服分类器放行逃出沙箱的操作。能够看到思路和智能体之间通信的监视器,发现了那些评估里的全部企图。作者说,会看思路的并行监视器是在这次实验之后不久才加上的。他们还写明,这类实验可能跑在尚未完成 Anthropic 发布前对齐评估的模型上,因此监视器是按模型可能未对齐来设计的。
[1][2]更宽容的读法,以及缺口
更公道的读法是:在给出里程碑清单和已经证过的引理之后,一套通用工具(沙箱、Git、SQL、Lean,再加上主导和助手的分工)就足以比 9 月那套安排更快、更省地复现一次已知的形式化。这是关于协作的真实结果。助手们起初拒绝了大部分工作,后来在主导不断改派之后又做完了,这也是关于这类系统会误判难度的真实观察。
缺口就在这个结果旁边。这些智能体没有自己选定那 60 条命题,也没有自己写出那 47 条引理,更没有发明那条经典路线。人类写的外层程序向主导发了 19 次催促,实验还在第 18 小时被重启。作者没有公布完整轨迹。安全上的结论是,这次运行里没有出现够格被拦的调用,而不是这套系统能抓住所有离开沙箱的企图。模型本身也可能还没完成已发布模型要过的对齐检查。
独立团队目前还不能拿一份公开标明的 Fable 5.2 权重,在同样的脚手架下重复一次 1000 个智能体的 Lean 形式化,并比较 token 消耗和证明长度。
[1][2]谁该在意,接下来看什么
任何在做可拆分、耗时长的多智能体系统的人,都该看这篇,尤其是还在犹豫要不要先做一个专用协作平台、还是可以先从 Git 和数据库起步的团队。安全团队也该看,因为这篇文章把监视器看见了什么、这次运行里又没用上什么,写得比常见发布更具体。
接下来六个月,能核对的是复现和轨迹是否公开。看 Anthropic 或其他人会不会公布这棵任务树、主导建出的 SQL 表结构,以及另一家实验室能够审计的 token 账本。看公开的 Fable 5.2 权重在拿到同样的 60 条命题和 47 条引理后,会不会用相近的时间做完。也看后续文章是仍然只用只看动作的监视器,还是会把看思路的监视器当作这种规模实验的默认配置。
[1][2]收束
这次实验表明,一千个被封在沙箱里的智能体,在拿到一份共享清单和一座共享数据库之后,可以重建一支更小、指导更细的团队已经写出的形式化证明。如果后来的公开实验在同样的脚手架下仍能保住时间和 token 上的节省,那么对这类工作来说,通用工具会比许多团队现在以为的更够用。如果去掉里程碑清单或那 47 条引理之后,节省就缩小了,那么 9 月的平台和人类事先做的分解,所承担的工作会比"1000 个智能体证明了费马大定理"这种随口一说要更多。
[1][2]