
要点
- Token 池化会把ColBERT 这类多向量检索模型中相似的 token 向量合并,从而减少需要存储的文档向量,但通常会损失一些质量。
- 在 pool_factor=4 时,常规训练的 ModernBERT-base 模型在文档向量约减少 74.8% 的情况下,保住了未池化时 NanoBEIR nDCG@10 的 94.6%。适应池化的训练把保持率提高到 97.8%。
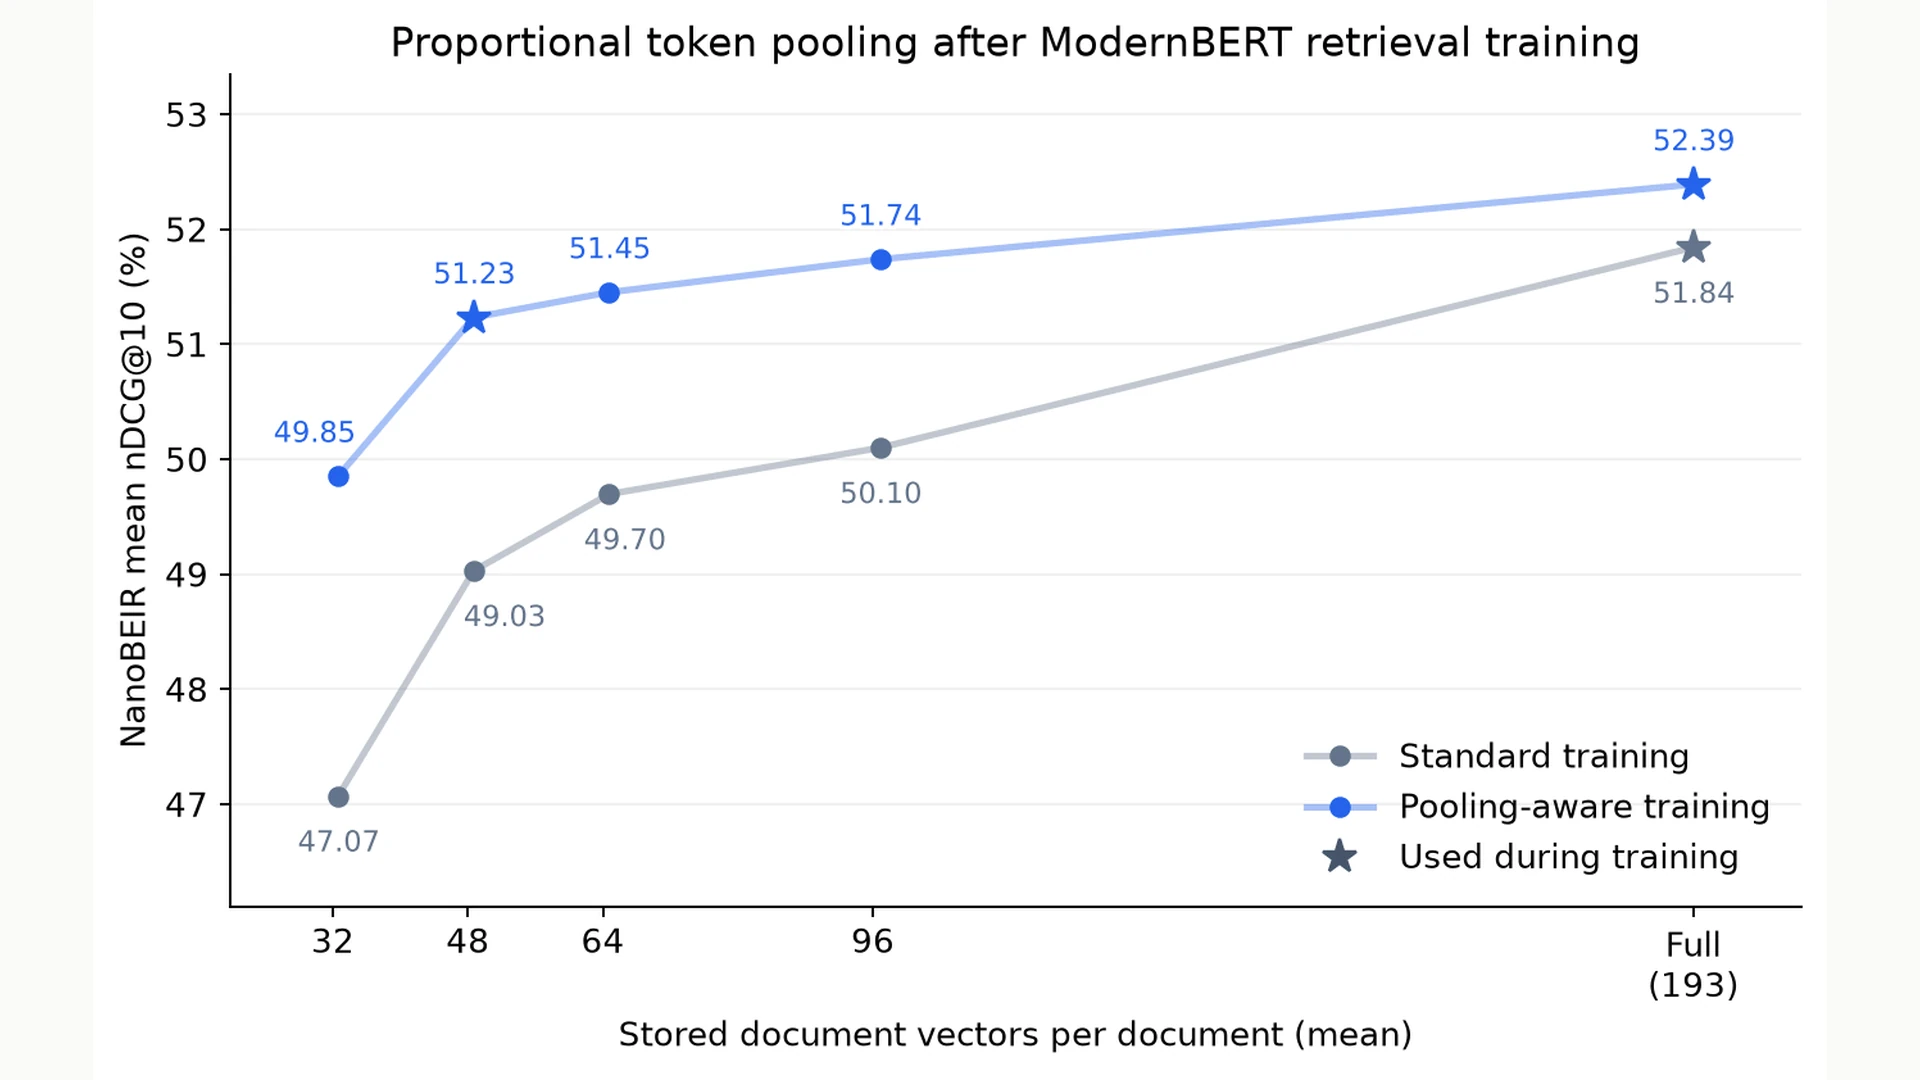
- 在 pool_factor=4 时,普通模型的平均 nDCG@10 为 49.03,适应池化的模型为 51.23,高出 2.20 分。压缩更狠时差距更大,例如每篇文档最多保留 4 个向量时,高出 5.78 分。
- 两个模型都以 answerdotai/ModernBERT-base 为起点,加上新的 128 维投影,在 12 万条 MS MARCO 三元组上训练一个周期,随机种子为 42,没有做超参数搜索。唯一差别是损失函数。
- 该方法延续了 Stefan Josef 以及 LightOn 较早的池化感知训练工作。权重已发布为 tomaarsen/mve-ModernBERT-base-token-pooling,并提供对照基线,配方写在 Sentence Transformers 中。
2026年11月11日,Hugging Face 的一篇博客讨论了多向量检索里一个很具体的问题。ColBERT 这类模型会为文档中的许多 token 各保留一个向量,匹配因此更精细,索引也因此变得很大。常见的补救办法是 token 池化:把相似的 token 向量合并,让一篇文档只存储更少的向量。通常的代价是检索质量下降。这篇文章的主张是:大部分下降是训练问题。如果在训练编码器时就让它预期这些向量会被合并,那么在同样的存储预算下,它能保住更多未池化时的质量。
[1][2]训练了什么,池化如何工作
单向量模型会把整篇文档压成一个嵌入。多向量模型则保留一组带上下文的 token 向量,因而查询的不同部分可以匹配文档的不同部分。常用的打分方式是 MaxSim:每个查询向量选择与它最匹配的文档向量,再把这些分数加起来。存储成本会很快累积。文章给了一笔具体的账:在每个残差坐标 4 比特的条件下,200 个 128 维向量每篇文档要占 12.8 KB,一百万篇就是 12.8 GB。如果把每篇文档池化到 50 个向量,在相同维度和精度下会降到 3.2 GB。
Sentence Transformers 中的 HierarchicalTokenPooling 用 Ward 层次聚类,把相似的 token 嵌入分组。它反复合并使组内离散程度增加最少的那一对组,再用均值代表剩下的每一组,并重新归一化。当 pool_factor=4 时,文档大约保留原来四分之一的向量,较长的文档可以保留更多容量。默认情况下,第一个 token 不会被合并,而且池化只作用于文档嵌入,查询保持未池化。库还支持给每篇文档设置向量上限,以及一个可以校准到目标平均向量数的距离阈值。
文章把渊源写得很清楚。池化感知训练已经在 Stefan Josef 的 Learn to Pool,以及 LightOn 的池化正则化研究中讨论过。这篇博客是一个可复现的 Sentence Transformers 操作说明,并公布了权重,并不是宣称发明了这一想法。
[1][2]一次受控对比,以及一个重要限制
两个模型都从 answerdotai/ModernBERT-base 训练,并各自加上新的 128 维 token 投影。一份是 tomaarsen/mve-ModernBERT-base-token-pooling-baseline,只使用缓存的对比损失。另一份是 tomaarsen/mve-ModernBERT-base-token-pooling,在同一损失外包了未池化和 factor-4 的池化感知目标。两者都在同样的 12 万条 MS MARCO 三元组上训练一个周期,随机种子为 42,初始化与优化设置相同。训练时的 token 上限为 300。短查询被扩展到至少 32 个 token 位置。作者没有做超参数搜索。唯一差别是损失。
评估使用 NanoBEIR@13,报告的是平均 nDCG@10,以百分数计。这是一种常用分数,用来衡量正确文档在排序列表中有多靠前。在 pool_factor=4 时,普通模型为 49.03,适应池化的模型为 51.23,高出 2.20 分,同时比未池化检索少存储 74.8% 的文档向量。保持率定义为池化后的平均 nDCG@10 除以该模型自己未池化时的平均值,从 94.6% 提高到 97.8%。未池化检索也略有提高,从 51.84 到 52.39。
表格在其他预算下也呈现同样的趋势。pool_factor=2 时高出 1.64 分,pool_factor=6 时高出 2.78 分。硬性上限为 16 个向量时高出 2.65 分;上限为 4 个时高出 5.78 分,从 37.22 到 43.00。当用距离阈值校准到平均 64、32 或 16 个向量时,优势较小,但仍为正。文章指出,短文档会把这些平均值拉到名义上限以下。
需要诚实面对的限制是测试床。NanoBEIR 是 BEIR 的较小替代。这次运行只有一个周期、一个随机种子、一个基座模型,而且没有超参数搜索。这对受控对比是优点,也是不能把 97.8% 当成普遍常数的理由。
[1][2]应该先压缩什么
文章给出的是一套操作顺序,而不是一句口号。如果主要约束是索引体积,先把嵌入量化到 4、2 或 1 比特,例如用 Fast-PLAID,这样能减少每个坐标占用的存储。然后再做 token 池化,必要时再做池化感知微调。接着再考虑 Matryoshka token 嵌入,也就是训练这些向量在截断到更小宽度后仍然有用。这些方法可以组合。可以用 MultiVectorTokenPoolingLoss 包装 MultiVectorMatryoshkaLoss,让同一个编码器同时为更少的维度和更少的文档向量接受训练。
文中还提到一个在 CUDA 上运行的 Ward 聚类内核,按设置不同,速度可以达到 SciPy 的 30 到 150 倍。这影响的是建索引的时间,并不改变关于质量的主张。
[1][2]一个公平的反对意见
一种公平的回应是:已经在推理时做池化的人本来就知道会有质量损失;在向量量约为四分之一的预算下,于一个较小的基准上提高 2.20 分,是有用的工程结果,而不是检索领域的新定律。先前的论文已经主张,编码器应当针对它将会遇到的池化来训练。这篇博客的主要贡献,是让这套配方容易运行,并把它测量得更清楚。
这样评价它的新颖性是公平的。这也正是这个结果用得上的原因。如果后续在完整 BEIR 上,或在私有语料上的运行,仍能保持大部分保持率差距,那么默认做法就应当改变:不要把多向量模型按“每个 token 向量都会被存储”来训练,然后只在建索引时池化,并把损失当成不可避免。
[1][2]未来六个月该看什么
下一步的核对并不复杂。把这一次只训练一个周期的 ModernBERT 对比,在完整 BEIR 以及至少一个大型私有语料上,按同样的 pool_factor=4 预算再跑一遍。如果保持率仍接近 97.8%,而基线仍在 90% 出头,那么池化感知训练就应当成为 Sentence Transformers 里多向量索引的默认路径。如果差距缩小,这篇博客作为一次仔细的测量仍然有用,只是还不足以成为新的默认。
[1][2]