要点
- Databricks 称平台上逾 70% 的 Spark 声明式流水线(SDP)已由智能体创建,每次失败尝试都有真实成本。
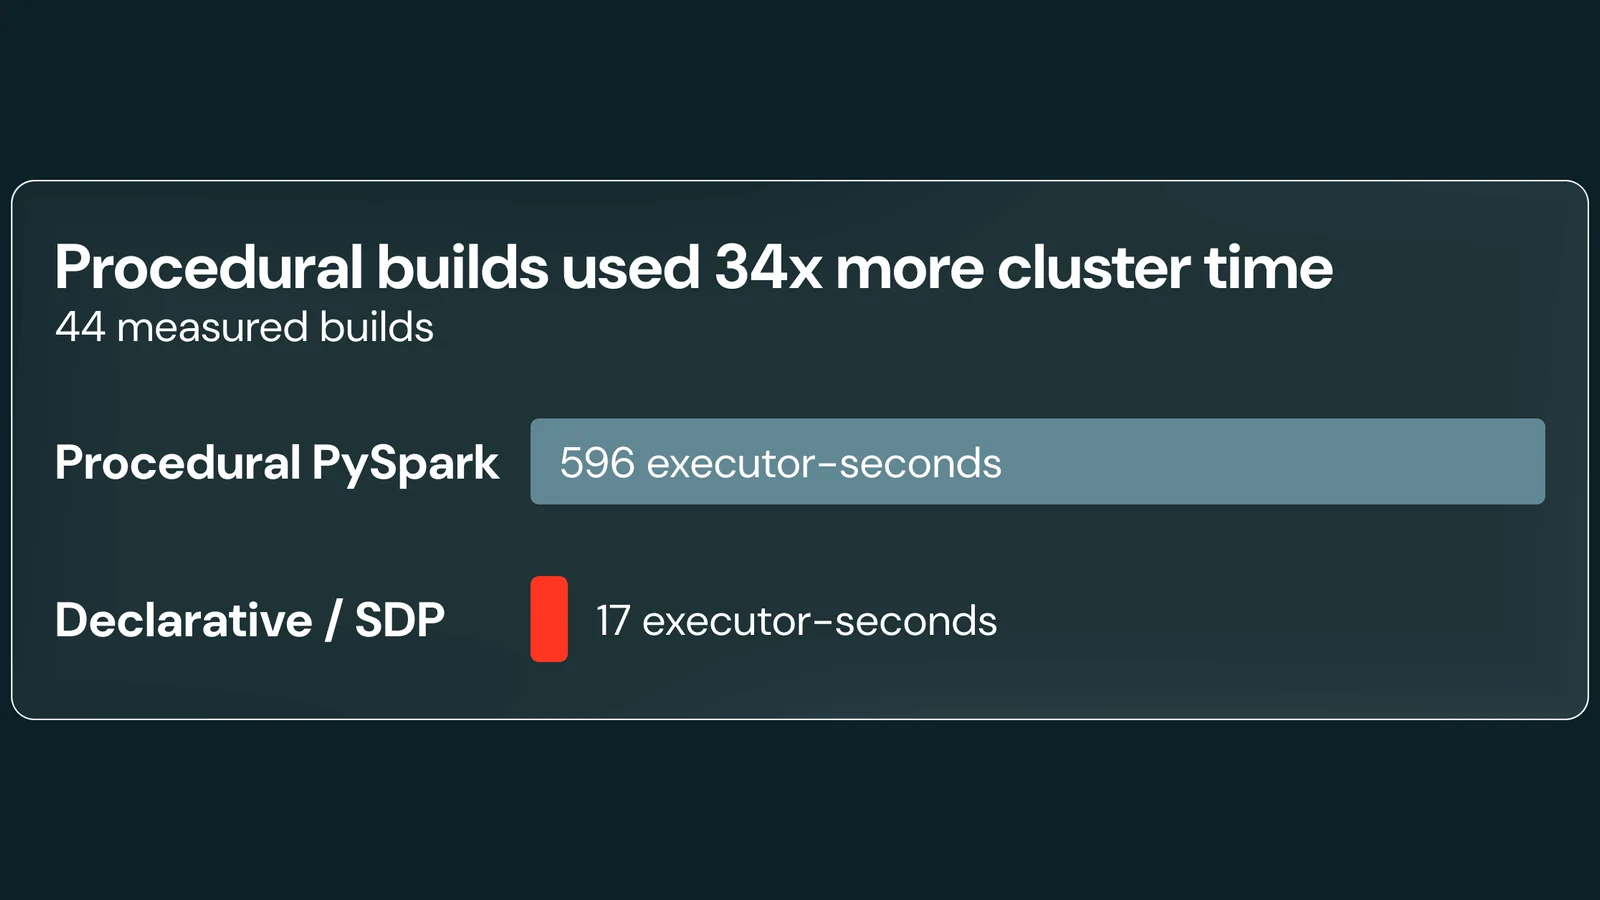
- 528 次构建中,过程式 PySpark 的 executor 秒数约为声明式的 34 倍;dry-run 在上集群前拦住结构性错误。
- 静默逻辑错误两端大致持平——声明式优化的是失败成本,不能替代测试与评审。
Databricks 本周抛出一个相当硬的工程判断:当自主智能体开始编写生产数据流水线,编程模型与模型权重同样重要。在 528 条由智能体生成的流水线对照实验中——22 个任务、每个任务 12 份带噪数据集、过程式 PySpark 对 Spark Declarative Pipelines(SDP)、统一使用 Opus 4.8——声明式方案消耗的集群时间显著更少,代码量大约减半,并且结构性失败发生在运行之前,而不是跑到一半才爆。
公司还称其平台上超过 70% 的 SDP 流水线现由智能体创建。该比例来自自述,但方向并不陌生:编码智能体正从演示走进工单。一旦多数流水线代码由智能体写出,每次重试都是账单,每一份难读的 diff 都是评审税。
[1]按 Databricks 的界定,过程式流水线逐步告诉 Spark 如何 构建每个数据集,验证对错几乎只能靠真跑。声明式流水线描述你想要的数据集,由 Spark 决定顺序、物化与大量样板代码。缺列、缺生产者、非法依赖边等结构性问题,可以在不必完整上集群执行的 dry-run 中被拒绝。
这听起来像编译器与解释器的老争论。新变量是写代码的人变成了智能体。智能体靠生成—失败—再生成迭代;若失败必须付出半次集群运行,成本曲线就不友好;若失败只是廉价校验,同一智能体就能负担更多尝试。
[1]即便按厂商博客常见折扣阅读,测量差距仍值得认真对待。过程式构建合计约 596 executor-秒,声明式约 17 秒,约 34 倍。完成构建的声明式中位行数 64,过程式 131(约少 51%)。完成率接近(255/264 对 258/264),因此故事不是“谁更能交差”。
两个限制 Databricks 基本自己承认了:dry-run 抓住结构性错误,抓不住静默逻辑错误;两端静默错答率相差约 15% 量级(约 28% 对 32%),不足以封王。声明式还在前端多花约 2.3 倍 LLM token(中位约 $0.50 对 $0.26,按 Opus 4.8 标价)。赌注是:固定的 token 溢价,能换掉随数据体量反复出现的集群浪费。
更关键的是,团队公开了含设置、提示词、数据集、评分器与溯源的仓库。这不等于独立科学,但把证据门槛抬到了高于一张只印「34×」的幻灯片。
[1]文章低估的是组织层,而非统计层。声明式优势假设平台校验器可信,且智能体被约束只输出声明式形态。在遗留 notebook、临时 Spark 作业与半迁移并存的环境里,智能体仍会写过程式捷径。Databricks 自己提到 19 个过程式构建把数据拉进内存逐行处理;声明式构建没有出现这种捷径——这是架构强制,而不只是风格指南。
另一缺口:基准只用一个智能体(Opus 4.8)和 Databricks 自有 SDP 表面。更弱的模型、别的声明式 DSL、或没有等价 dry-run 的数仓,都可能压缩差距。论点可迁移——“把想要什么与如何运行分开,使前者可单独检查”——但量级在他人复现之前仍是局部的。
[1]对数据平台团队,可操作含义比「改用 SDP」更锋利:把智能体的编写契约当成生产控制。若智能体可任意输出 PySpark,你买下的是概率性的集群账单;若只能提出在校验中失败即关闭的声明式图,你买下的是可评审产物和更便宜的失败模式。
这也重塑代码评审。行数减半不等于风险减半——静默错误仍要测试——但评审面变了:模式、依赖与声明输出,而不是命令式胶水。在智能体占多数的世界里,这或许是人类还能持续承受的评审形态。
[1]未来半年,值得关注其他湖仓与编排厂商是否拿出带开放 harness 的对照——不是营销胜率,而是 executor 时间与静默错误表。若声明式(或 SQL-first、类 IaC)编写能稳定让智能体的错误变便宜,行业争论会位移:模型选择仍重要,但稀缺资源变成了在集群上认错的成本。
[1]