
Artificial Analysis 的帖子把时间写成 2026-11-05T08:28:08.000Z,即北京时间 11 月 5 日 16:28,早于午报窗口,晚于回补线,所以按回补。帖子写,腾讯 Hy4 在 Artificial Analysis Intelligence Index v5 上是 35 分,在中国实验室的模型里排第二,只低于 Kimi K3.1 Pro 的 46 分。同一句写,35 分与 Grok 4.7(xhigh)持平,比 Claude Haiku 5.5(max)低 1 分。这是评测机构的帖子,不是腾讯此前那篇自测发布。腾讯账号随后只回了一句感谢,没有改这些数字。
[1][2]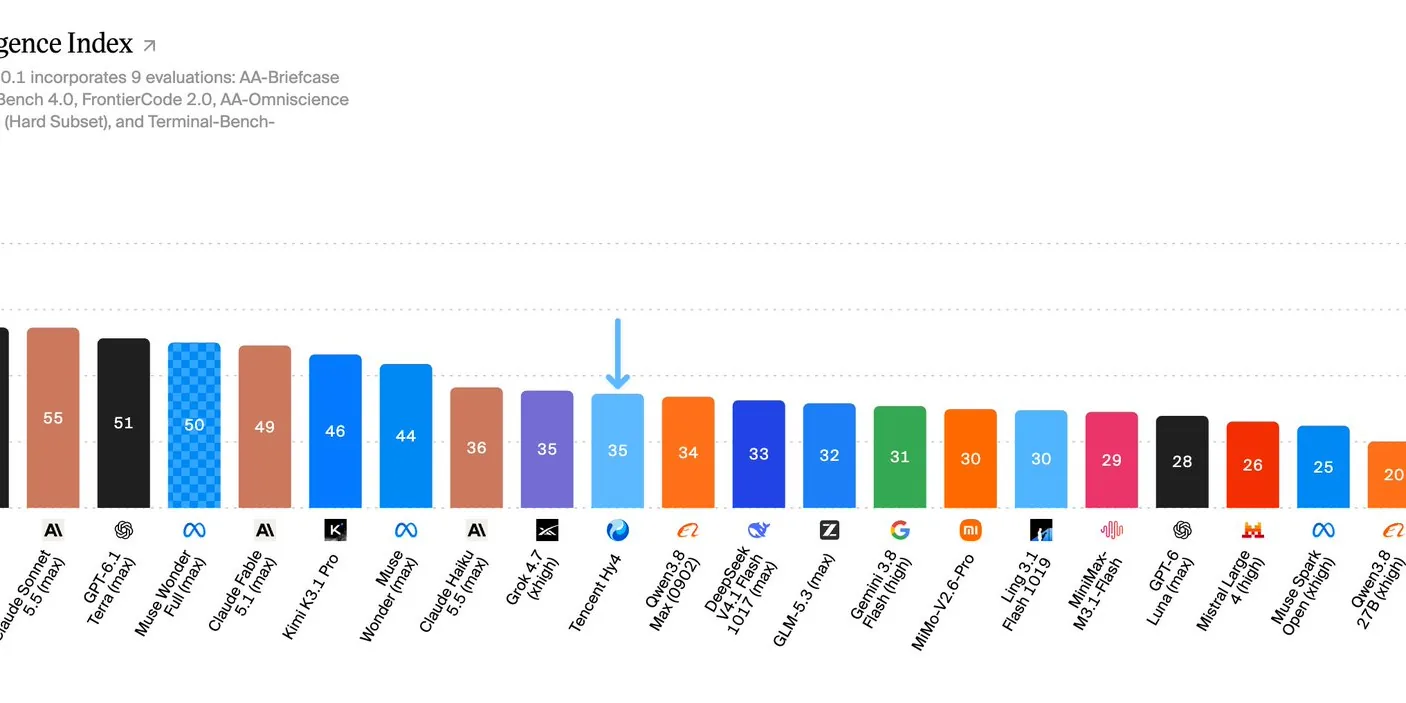
标价写成每百万输入 0.834 美元、每百万输出 2.501 美元。缓存读取是每百万 0.042 美元。上下文窗口写成 100 万 token。输入是文本和图像,输出是文本。帖子另给了一个指数任务成本:0.78 美元。按帖子的比较,这个 35 分的成本是同样 35 分的 Grok 4.7(xhigh)的十分之一,是 34 分的 Qwen3.8 Max(0902)的十三分之一,又几乎是 36 分的 Claude Haiku 5.5(max)的两倍。十分之一和十三分之一是帖子自己的倍数,这篇没有重算。
[1]编码一段写,FrontierCode 2.0 上 Hy4 是 31%,Claude Fable 5.1(max)是 32%,DeepSeek V4.1 Flash 1017(max)是 28%,Kimi K3.1 Pro 是 25%。帖子把 31% 称为中国实验室模型里的最高。Terminal-Bench 4.0 上是 37%,帖子写这是中国实验室模型里的第四。知识一段写,AA-Omniscience v1.1 的准确率是 50%,比 Kimi K3.1 Pro 高 1 分,幻觉率却是 89%,Kimi K3.1 Pro 是 37%。HLE-Diamond 上是 33%,Kimi K3.1 Pro 是 37%。50% 和 89% 写在同一句里。
[1]因此 35 分不能单独拿走。幻觉率、价格和两项编码分数都在同一篇帖子里。评测怎么出题,帖子没有写成步骤,这篇也不补。配图是帖子里的指数条形图,裁成宽幅之后两边的柱子不完整,正文数字以帖子文字为准,不按图重读。
[1]