
要点
- 作者把科学建模拆成三个循环步骤:确定模型形态、约束可调参数、解释它对真实系统说了什么。
- Hodgkin 与 Huxley 1951 年的神经细胞方程需要四次方项,因为更简单的形式拟合更差。数十年后,相关钾离子通道被发现由四块相同部件围着中心孔排列。
- 把复杂模型里所有说得通的参数组合都列出来,常常做不到。基于模拟的推断(SBI)用大量正向运行来训练网络(Hodgkin-Huxley 一类模型约 10 万次,更大的模型可达数百万次),随后可在数秒内根据新数据反推。
- 基于大语言模型的智能体已经能根据数据和自然语言描述提出并修改候选模型。作者认为这些系统应返回一组带权重的模型,而不是一个冠军。
- 解释仍是最难交给 AI 的一步。此类系统多在「重新发现科学家已知道的模型」上测试;它们在尚无已知答案的问题上是否成立,证据仍然稀少。
2026 年 11 月 6 日,Anthropic 研究博客刊出 Jakob Macke、Daniel Gedon 与 Stefan Wahl 的客座文章。三人在 ELLIS Institute Tübingen 和图宾根大学开发用于神经科学及其他领域的科学建模工具。他们的由头是一段旧事。1951 年,剑桥的计算机停机六个月,Andrew Huxley 只好用一台手摇计算器花了三个多星期,去核对他与 Alan Hodgkin 为鱿鱼神经细胞写下的方程。作者要说的不是怀旧。而是:如今一个下午就能找到类似拟合的 AI,仍可能交不出那几个星期真正留下的东西,也就是哪些部分被数据钉住了,哪些替代方案已经被排除。
[1]实际发布了什么
这是一篇论述,不是一张新的基准表。作者把大多数科学建模看成三个步骤;数字对不上,或解释说不通时,人就会再走一遍。
第一步是建立模型:决定它由什么构成、方程是什么形状。对 Hodgkin 和 Huxley 来说,这意味着把细胞膜当成电路,并把一个变量升到四次方,因为更简单的形式不如它贴近记录。他们谨慎猜测:膜上的闸门打开之前,也许要有多个带电粒子就位。
第二步是约束模型,也就是把可调数字调到测量上。一组好用的数字只说明「拟合是可能的」。它不说明别的数字组合是否同样好用,或会不会给出不同预测。作者把它比成只知道一顿晚饭总共 120 美元,却不知道谁点了什么。
第三步是解释模型:问它到底对真实系统主张了什么。Hodgkin 与 Huxley 关于四个粒子的想法之所以站得住,是因为更低的次方不够用。两人在 1963 年分享诺贝尔生理学或医学奖之后,另一组研究者发现,一种相关的钾离子通道蛋白由四块相同部件围着中心孔排列。1951 年的方程并不是为这个结构而拟合的,却指向了它。作者引用 Richard Hamming 1962 年的话:「计算的目的是洞见,不是数字。」
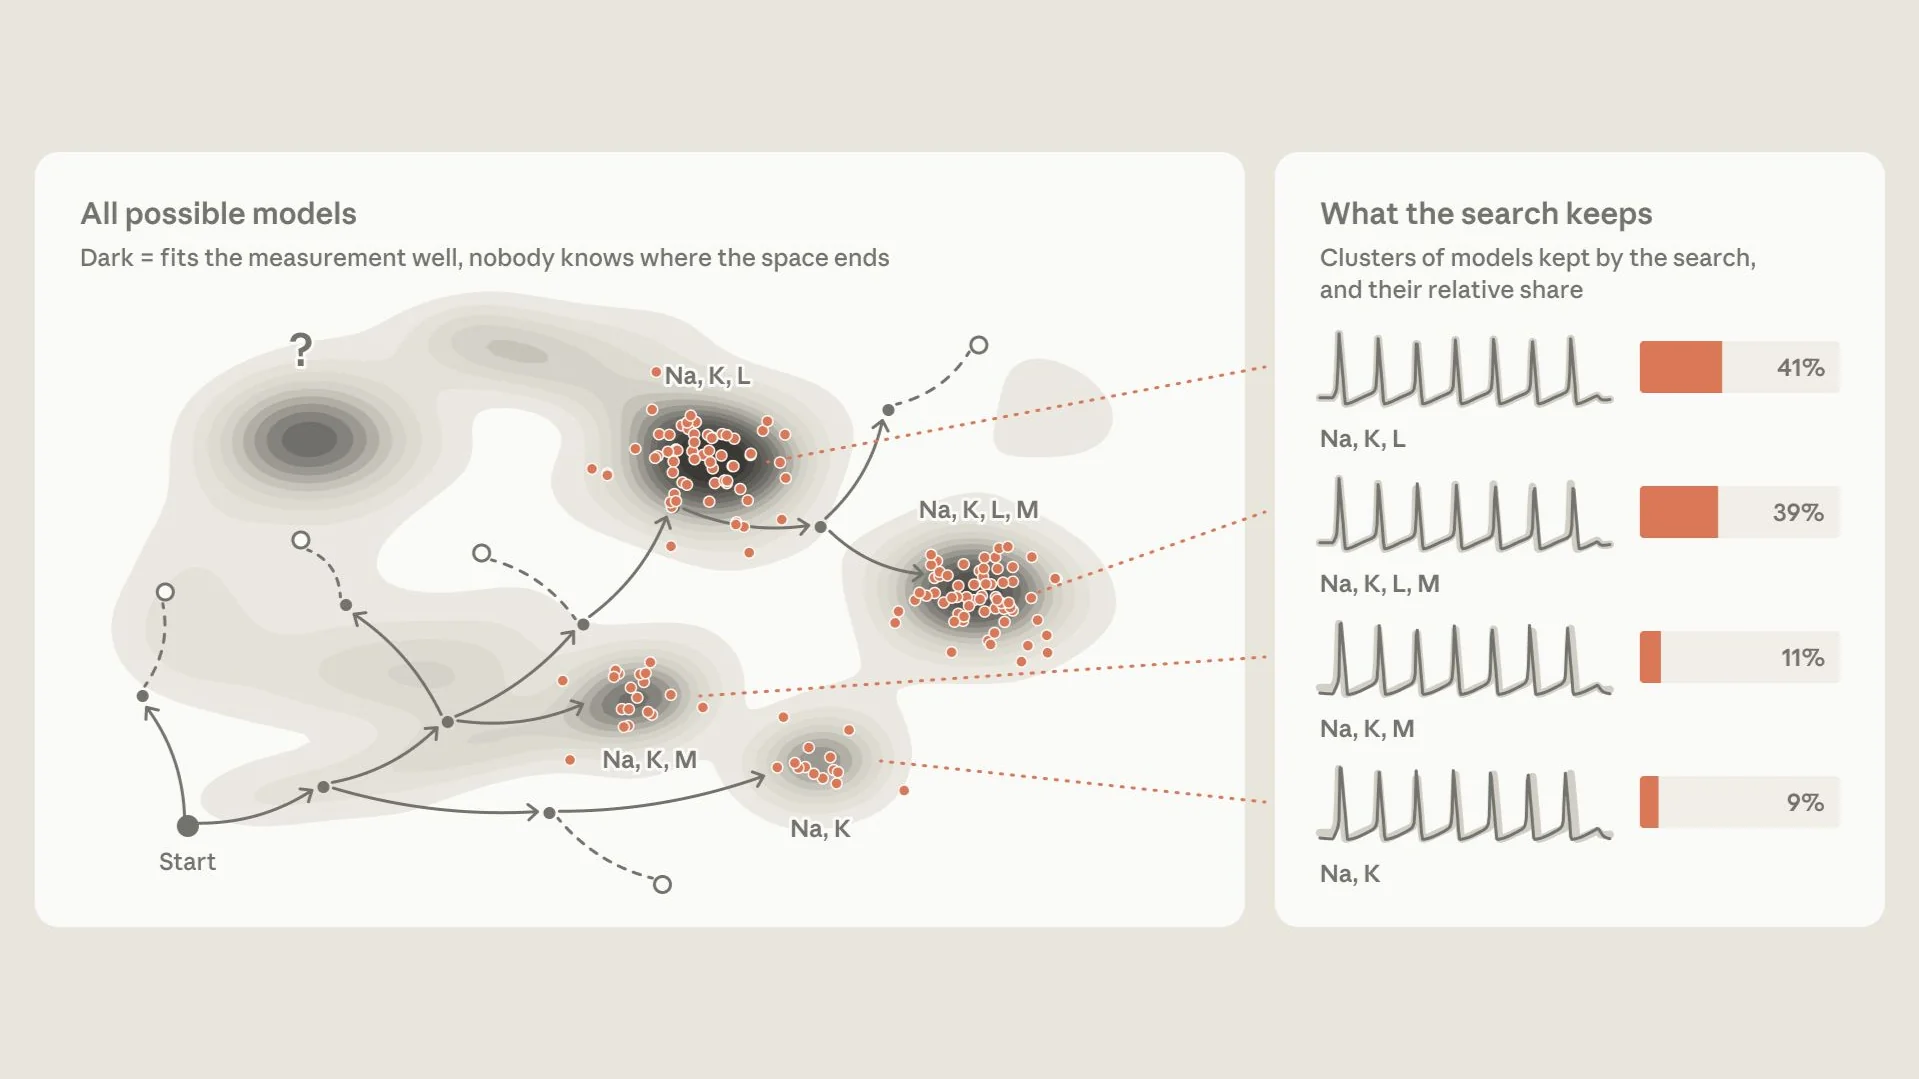
机器在第二步上走得最远。标准的贝叶斯推断会返回所有还算说得通的参数组合,并由拟合程度和先验知识来定形。若模型里有大量随机开关的离子通道,列出这些组合在计算上常常做不到。基于模拟的推断绕开了缺失的似然公式:你随机抽参数、正向跑模型、记下输出,如此重复十万次量级,再训练一个网络,让它从输出反推可能产生该输出的参数范围。你只需要一个能正向运行的模拟器。这段训练很贵,但一旦完成,新数据可以在数秒内反推。作者举了双中子星碰撞的例子:这种方法能足够快地估计出大致方位,好在信号还在时把望远镜转过去。他们还提到宇宙学、结构生物学、地球物理以及神经细胞模型本身的成功应用。因为答案是一个分布,研究者能看出哪些数字被钉住了,哪里仍有多种解释,下一次实验该补哪一块。
建立模型正在进入同一套逻辑。可能的方程空间几乎是无限的,只凭经验提出少数几个,很容易漏掉同样拟合得好的其他模型。过去两年出现的若干系统,会用大语言模型根据数据和文字描述写出候选模型代码,再运行、约束、与测量比较并修改。作者提醒:同一批数据跑两遍,可能得到两个不同但同样好的模型。只交出其中一个,等于把其余藏起来,就像只报告一组最佳参数。更好的做法是提出许多候选,按数据支持它们的自然程度加权,淘汰弱的,再在强的附近繁殖变体。若所有存活模型都共享某一特征,数据多半偏向它;若它们意见不一,下一次实验就有了目标。
解释仍最难自动化。拟合可以打分,理解至少现在还不能。一种提议是看系统能不能预测你扰动真实对象之后会发生什么,例如堵住部分钠离子通道。另一种是看智能体的输出是否帮助人类科学家理解问题,比如一个为量子实验写短程序的系统,物理学家可以直接从程序里读出设计原则,而不必从单次装置反推。这两种情况下,完整的合适模型分布都很重要,因为单个模型会诱使人去解读数据从未约束过的部分。
模型变大之后,紧凑将较少是「人写得下来」的限制,而更多是「人还能否读懂」的限制。Hodgkin-Huxley 方程描述的是一个细胞。果蝇脑有超过 10 万个神经元,人脑则有数百亿。研究者现在已经得到果蝇脑的完整接线图谱。作者附了一张雄性中枢神经系统连接组的渲染图,注明来自 HHMI Janelia、剑桥大学、MRC LMB 与 Google Research,采用 CC BY 4.0,分别显示 1、10、255 和 124,635 个细胞。在这种尺度上,很少存在唯一正确的模型。他们引用 George Box 的话:所有模型都是错的,但有些有用。有用的问题变成:所有与数据相容的模型共享哪些性质。气候集合模拟,以及大型强子对撞机上「某种粒子理论的哪些版本仍未被排除」的地图,已经按这个精神工作。
[1]台面上的证据
主证据就是 2026 年 11 月 6 日这篇 Anthropic 客座文章本身:Hodgkin-Huxley 史实、三步框架、晚饭账单比喻、SBI 的方法说明(包括 Hodgkin-Huxley 一类模型约 10 万次运行的量级),以及果蝇连接组的署名。脚注中的支持文献包括近年用大语言模型做模型发现的工作(如 Romera-Paredes 等,2024;Shojaee 等,2025;Ma 等,2024;Novikov 等,2025;Xia 等,2026;Ziaei Bideh 与 Gryak,2026),以及关于搜索模型分布的论文(Wahl 等,2026;Mishra-Sharma,2026;Murphy,2026)。果蝇接线图谱的引用包括 Dorkenwald 等,2024;Schlegel 等,2024;Azevedo 等,2024。本页并没有给出一张新的对打表,证明「返回分布的智能体」在尚未有著名答案的科学问题上,优于「只返回一次拟合」的智能体。
[1]钢人与缺口
钢人。如果许多参数组合或许多方程形式都能贴合同一组记录,那么只交给科学家一本拟合好的笔记,本身就是一种隐藏。Hodgkin 与 Huxley 之所以能对细胞膜提出主张,是因为他们知道什么没有成功。气候科学和对撞机物理已经拒绝把这种不确定性压成单次运行。一套只优化拟合的科学 AI,会把 Hamming 认为并非要点的那部分自动化。
缺口。作者写得很清楚:这些智能体多半在重新发现已知模型上受测,在没有已知答案的问题上证据稀少。这是 Anthropic 托管的客座文章,作者正是讨论中那些工具的建设者,不是一次独立审计。关于当前智能体的若干定量主张,住在被引用的论文里,而不是本页的新图中。「理解」也还没有公认的打分规则,这正是解释难以移交的原因。
[1]谁该在意,下一步看什么
为科学搭建 AI 工具的人、把「模型被找到了」当成里程碑的资助方,以及想写「智能体发现了方程,因为残差看起来很小」的记者,都该读。未来六个月看:模型发现类智能体是否默认返回带权的模型集合和被淘汰的替代方案;奖项和基准是否给这些分布打分,而不只看最佳拟合误差;是否有人在一个原本没有著名答案的科学问题上拿出清楚的胜负。
[1]收束
Huxley 的三个星期不是浪费掉的计算。它们是一份「已经被排除之物」的记录。一次不保存这份记录的下午拟合,可以贴合数据,却仍让科学家说不清系统究竟像什么。六个月后,要么科学智能体把存活的模型和失败的模型一同交付,要么「AI 建成了模型」将继续只意味着:有个东西,在某处,再现了一条曲线。
[1]