要点
- 榜首通过率仅 32.7%,长任务榜仍有区分度
- 通过率之外,完成率更能说明「差多远」
- 写新代码强于重构迁移,跨端转原生仍是开放题
- 选型要看模型 × harness 整包,而不是裸模型分
为什么要有 2.0
Android Bench 1.0 测的是 GitHub 上的局部 PR——中位数改动约 32 行、1–2 个文件。前沿模型很快刷到约 90% 通过率,区分度被抹平。
2.0 把题面换成 30 个长任务(Long-horizon tasks),官方对标的工期是「中级到高级工程师数天到一周」:按设计稿从零做多屏 App、库与架构迁移、在成熟仓库里加平台能力、把 Flutter / React Native 转成原生 Compose。规模从上千行到跨上百文件——从「写代码」的考试,变成了「做工程」的考试。
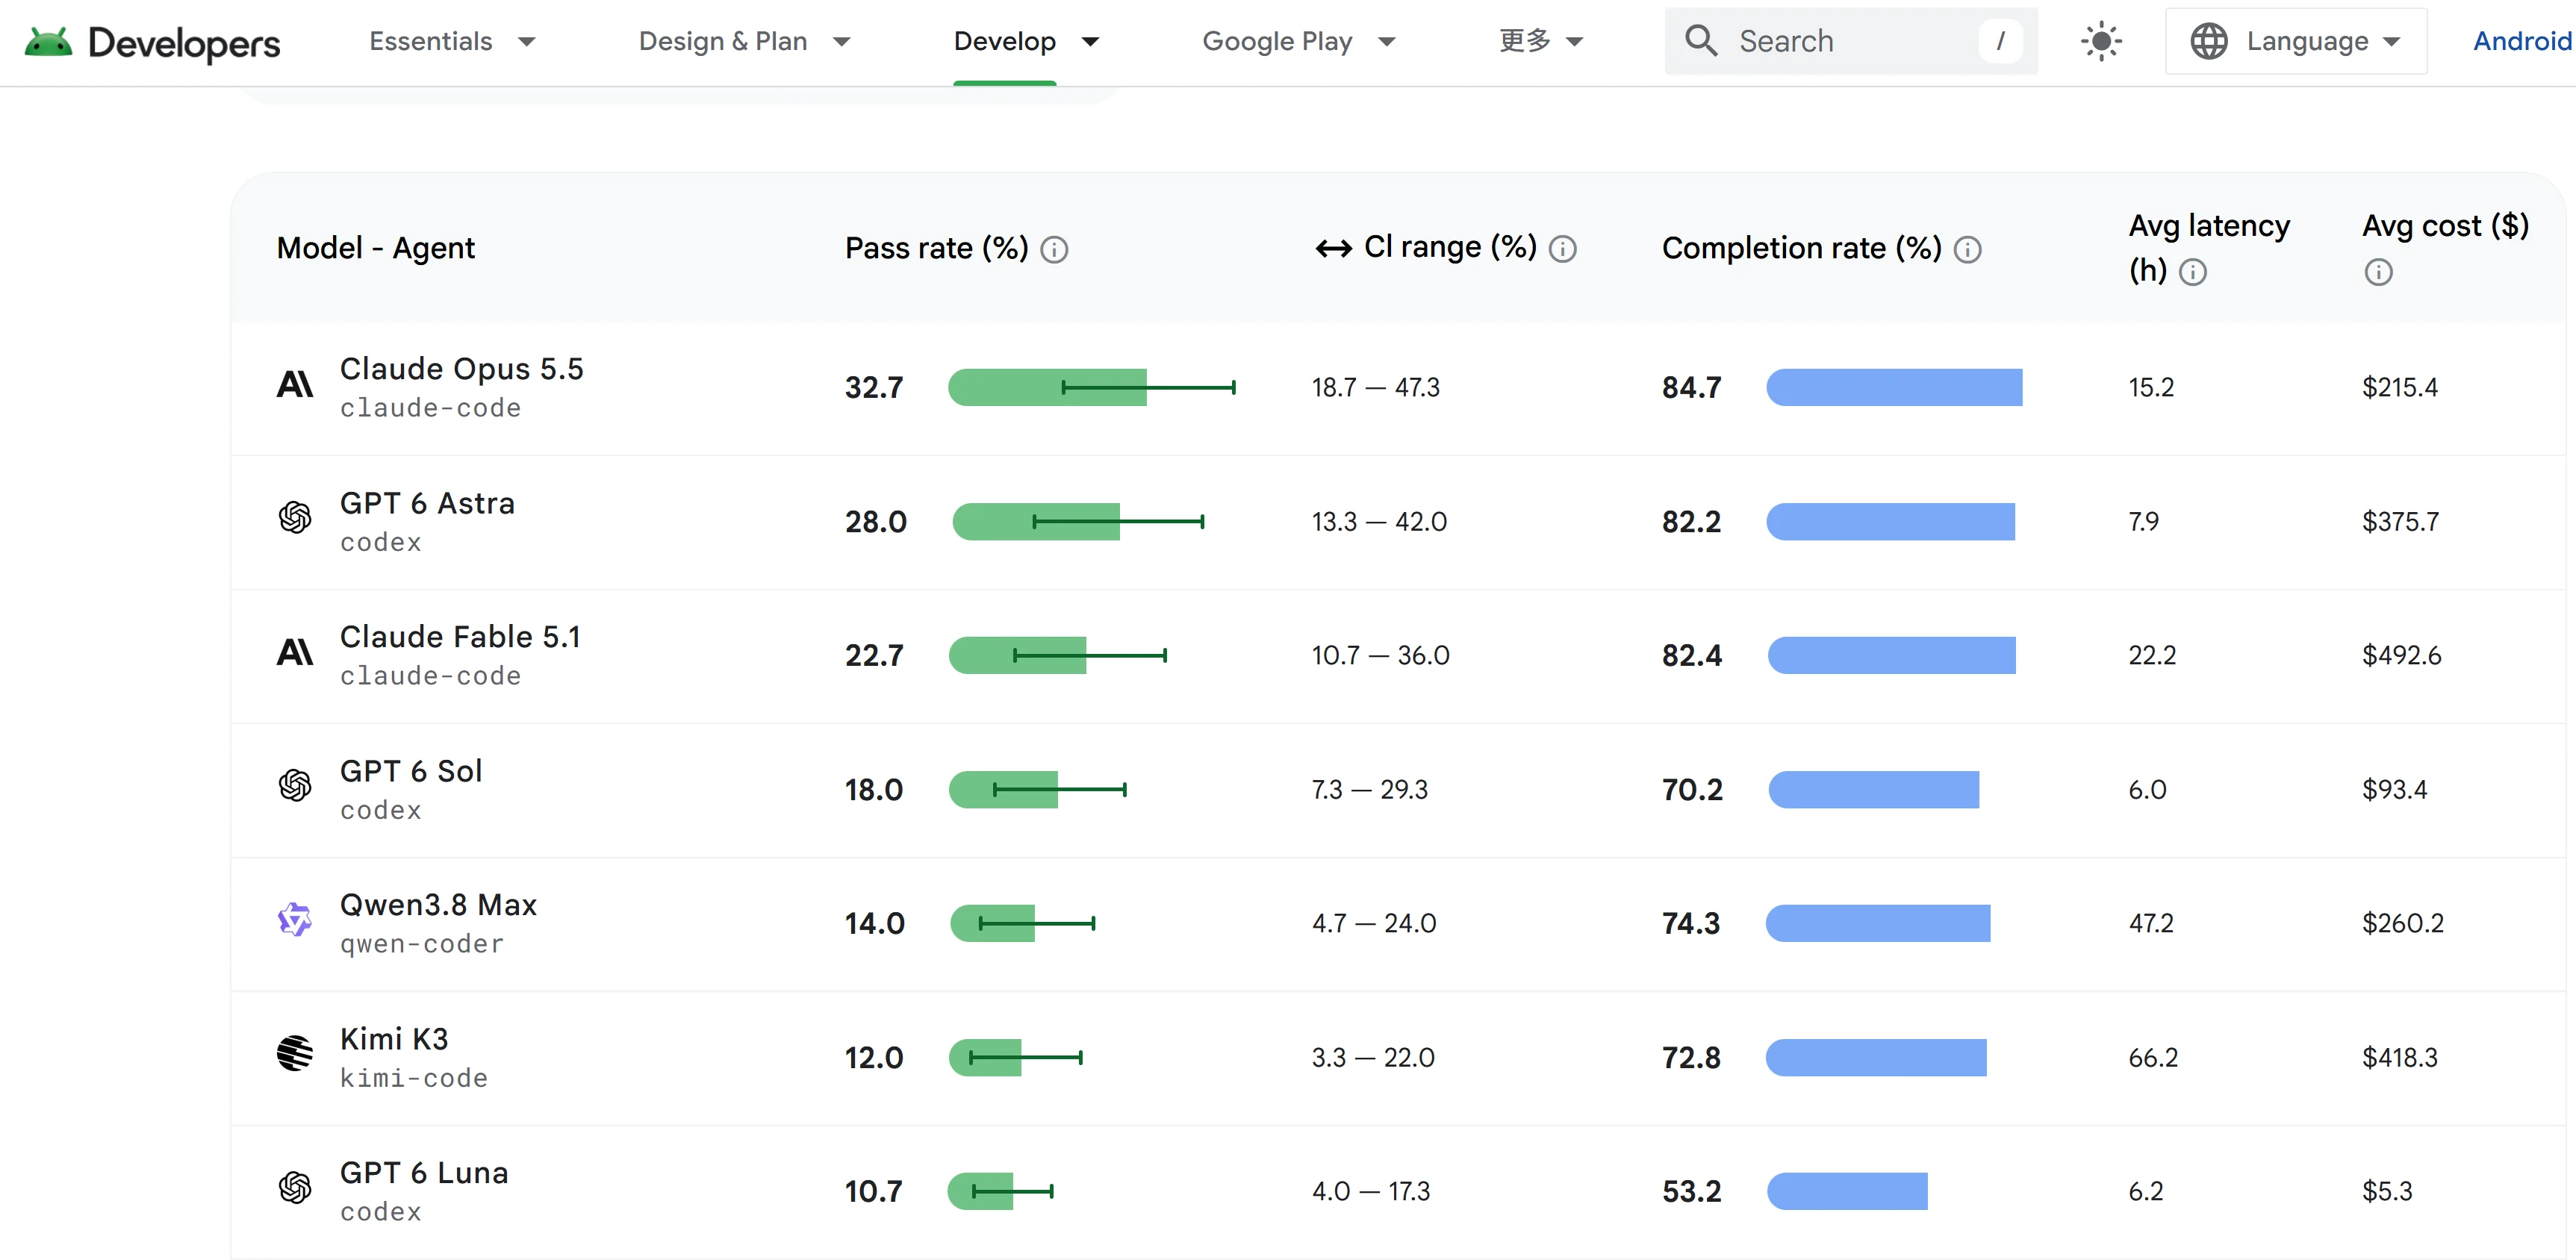
[1][2]长任务榜前七名(2026-10-10)
Claude Opus 5.5 · claude-code
- 通过率
- 32.7%
- 完成率
- 84.7%
- 耗时
- 15.2 h
- 单次成本
- $215.4
GPT 6 Astra · codex
- 通过率
- 28.0%
- 完成率
- 82.2%
- 耗时
- 7.9 h
- 单次成本
- $375.7
Claude Fable 5.1 · claude-code
- 通过率
- 22.7%
- 完成率
- 82.4%
- 耗时
- 22.2 h
- 单次成本
- $492.6
GPT 6 Sol · codex
- 通过率
- 18.0%
- 完成率
- 70.2%
- 耗时
- 6.0 h
- 单次成本
- $93.4
Qwen3.8 Max · qwen-coder
- 通过率
- 14.0%
- 完成率
- 74.3%
- 耗时
- 47.2 h
- 单次成本
- $260.2
Kimi K3 · kimi-code
- 通过率
- 12.0%
- 完成率
- 72.8%
- 耗时
- 66.2 h
- 单次成本
- $418.3
GPT 6 Luna · codex
- 通过率
- 10.7%
- 完成率
- 53.2%
- 耗时
- 6.2 h
- 单次成本
- $5.3
方法论上值得单独说的四点
防污染:私有代码库 Food Vibes、上游不存在的迁移路径(Nav 3 / Coil 3 / Ktor 3)、无原生对照的跨端转换,并配合轨迹审计抓 reward hacking 与硬编码。
多模态验证:像素对比会被状态栏时间、电池图标等噪声干扰(语义正确界面也可达 47.5% 像素 diff),因此用模拟器走查 + Gemini 3.5 Flash 视觉裁判 + 无障碍树解析。
双指标:Pass rate 只有功能全过、视觉合规、零违规才算 1.0;Completion rate 用 0–1 连续分保留「快做完了」的爬山信号。
模型 × harness:榜单写的是 Model · Agent,承认 harness(缓存、工具窗口等)会改变结果。
[2]三条实战规律
- 写新代码 > 改旧代码。重构与迁移更难,因为成败取决于架构复杂度,而不是代码行数。
- 确定性变换很强,模糊工程仍然弱。Java→Kotlin、Retrofit→Ktor、补 ViewModel 可在 125+ 文件 / 8,000+ 行上稳定执行;运行时校验、破坏性框架变更、未正式发布的库容易掉链子。
- 跨端转原生仍是开放难题。Flutter / React Native → Android:没有任何模型做到 100% 通过,前沿模型完成率最高约 80%。
失败长什么样
以榜首 Claude Opus 5.5 为例:CameraX 头像拍摄、促销模块、Retrofit→Ktor、Bitwarden 双栏布局等题 5/5 全过;Flutter→Compose 的 Habo、短信验证码登录、设计系统组件库等题 0/5。失败原因多为 failed tests 或 failed validation。
GPT 6 Astra 的对照更说明问题:它在 App creation 里有多个完成率 90%+ 的模块仍是 0/5 通过。通过率低,未必是写不出来,而是差最后一公里的验收。
[1]给开发者的三条建议
- 选型别只看通过率,把完成率和成本一起看。
- 把「验收」当成护城河:你自己的 instrumentation 测试、视觉验收、回归门禁,比再换一个模型更能决定交付质量。
- 长任务要配可观测进度:一次跑十几小时、花上百美金,没有中途检查点就是在赌博。
为什么这榜值得关注
Android Bench 2.0 把评测从「补丁能力」推进到「工程能力」:私有题面与轨迹审计对抗污染,多模态裁判对齐「人眼看到的好界面」,连续完成率保留爬山信号,并承认 harness 与模型同等重要。
当第一名只有 32.7% 时,说明这个榜还没有失去区分度。
[1]