
当全世界都在争论"要不要给前沿 AI 减速"时,Anthropic 做了一件更激进的事:把自家机房的三块仪表盘拆下来,挂到了公共广场上。
Anthropic 研究院最新发布的测量报告,首次系统披露了前沿实验室内部 AI 研发的真实速度:Claude 已经"主导"(AL4)Anthropic 26% 的 AI 研发工作,"协作"级别以上的占比超过 90%;公司内部任一时刻约有 30,000 个 AI 代理在做研究和工程工作,8 月单月监控决策超过十亿次;而在 7 月中旬那一周,投入 AI 研发的算力中只有约 6% 流向了安全。
这三个数字分别对应报告提出的三项测量:AI 在多大程度上建造下一代自己、人类对 AI 代理的监督有多强、算力这块最可验证的资源怎么分配。背景是 CEO Dario Amodei 此前发文《We Must Pace the Frontier》呼吁协调减速——这份报告就是给"减速"配的第一套度量衡。
[1]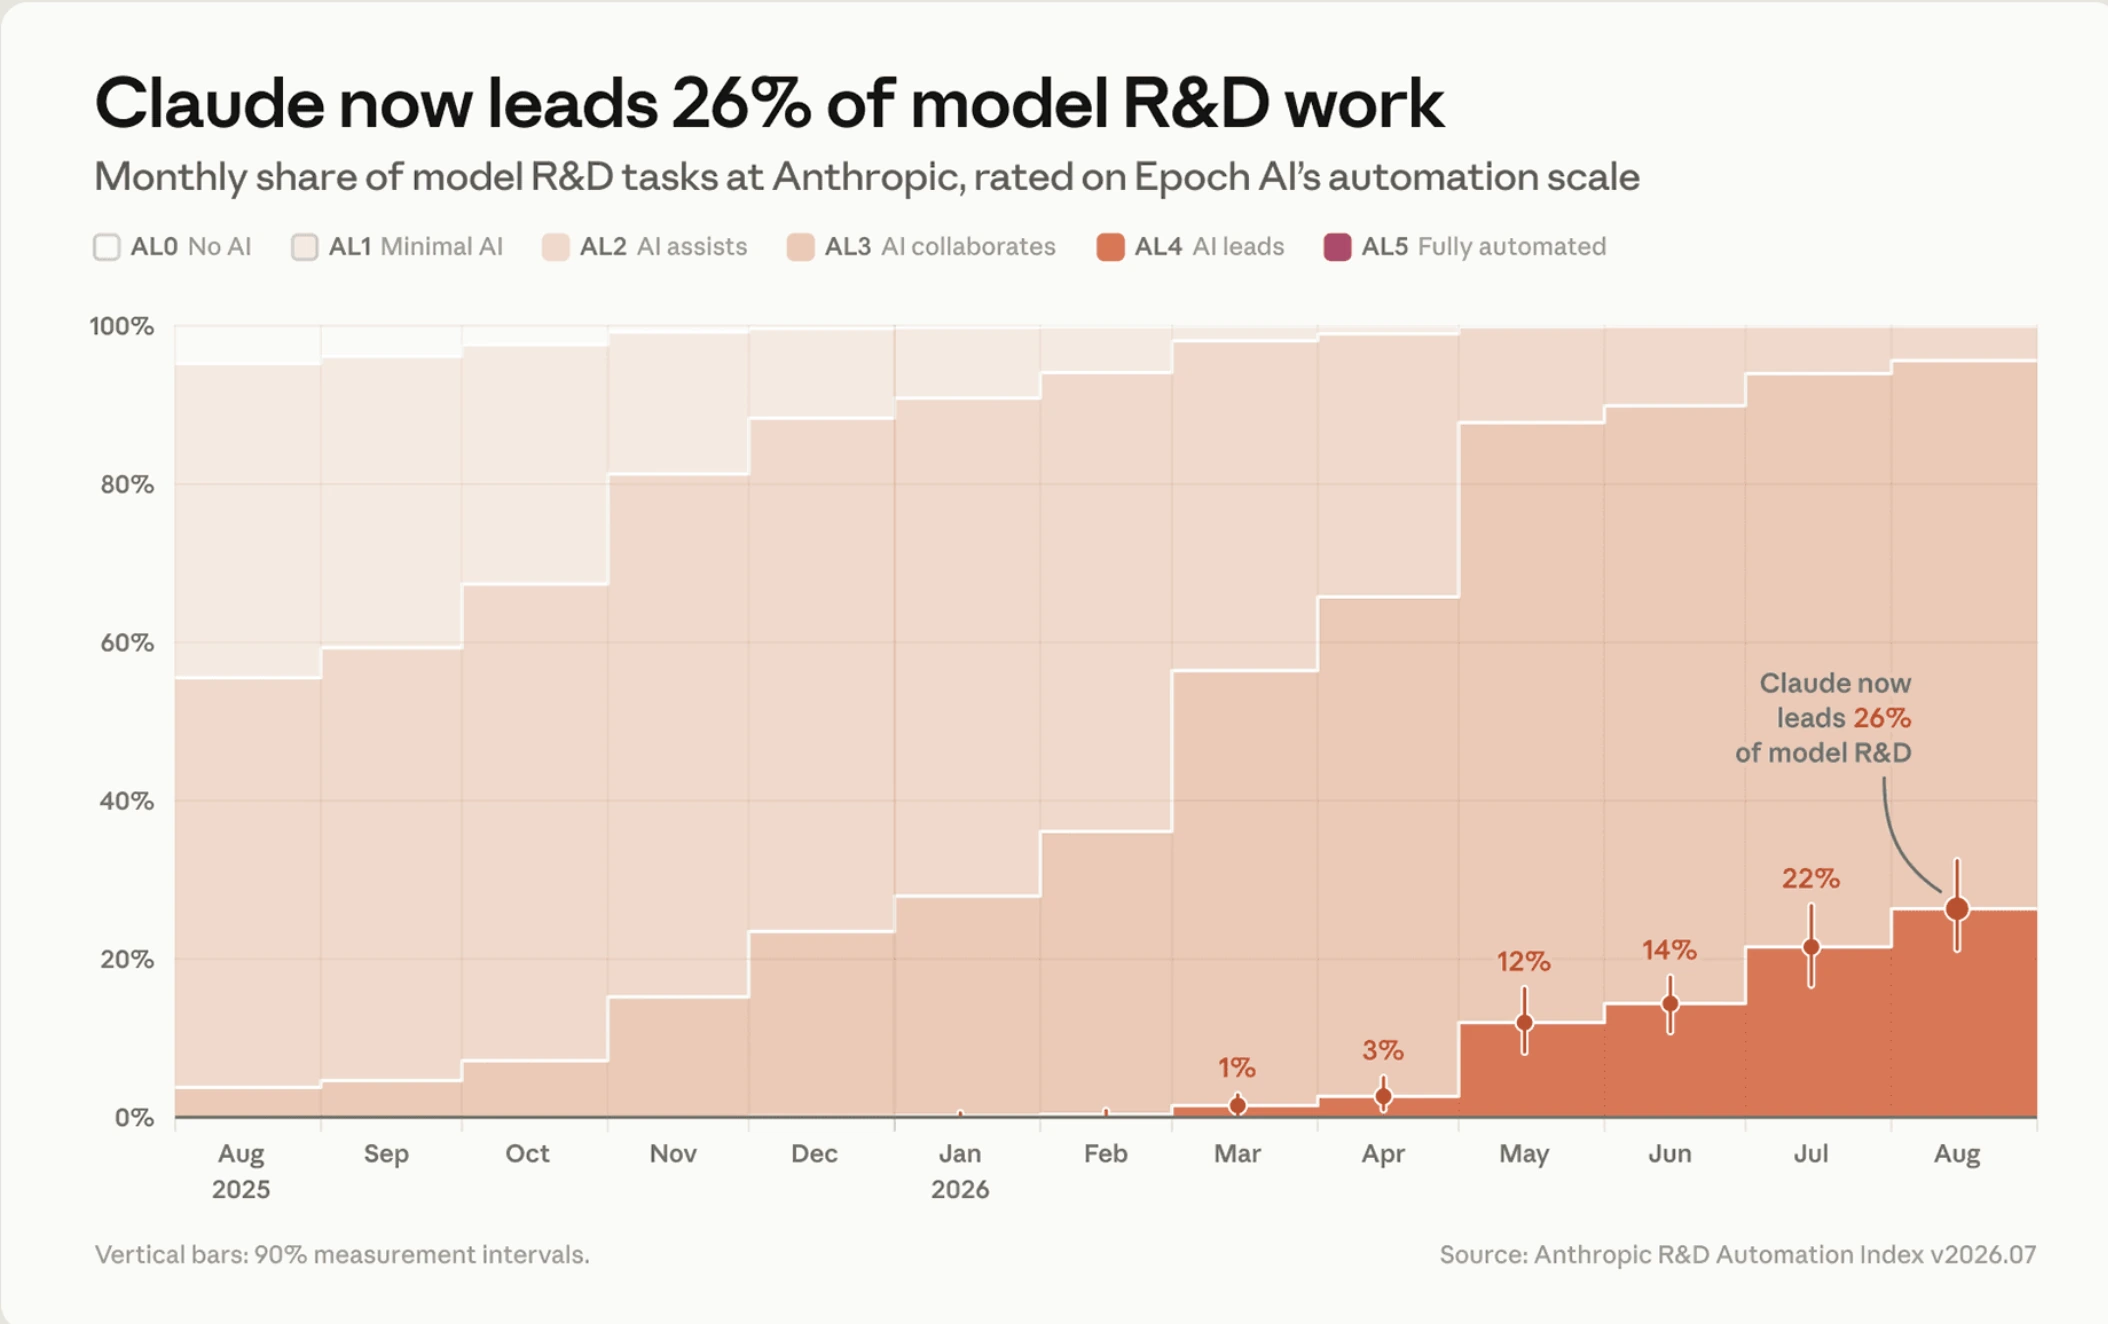
仪表盘一:AI 建造 AI,进度条到 26% 了
第一项测量叫 Anthropic R&D Automation Index,回答一个最敏感的问题:距离递归自我改进(模型完全自主建造继任者)还有多远?
方法是从下往上爬梳:对 2026 年 7 月每一周,随机抽取各部门 20% 的员工,让 Claude 研究代理阅读他们的 Slack 记录和内部文档,列出每个人做过的任务——最终得到约 15,000 条颗粒度极细的任务清单,再组织成一棵 542 个节点、378 片叶子的任务树(叶子如"评测平台缺陷诊断与修复""RL 沙箱出网策略")。然后对每类任务按 Epoch AI 的六级自动化量表(AL0 无 AI 参与到 AL5 全自主)评级,按人时加权聚合。
截至 2026 年 8 月的结果:没有任何一个研发子领域达到 AL5(完全自主、无人在环);26% 的研发工作由 Claude "主导"(AL4:能从高层指令端到端完成大部分任务,人类退居监督);90% 以上的工作达到"AI 协作"(AL3)及以上。
比绝对值更刺眼的是斜率:官方图表显示 AL4 占比在 3 月还只有 1%,随后是 3%、12%、14%、22%、26%——五个月 26 倍。
评级可靠性方面有个颇耐寻味的细节:Claude 评委与人类领域负责人评级的一致率(59%)高于人类彼此之间的一致率(35%),且 97% 的评分差距在一个等级以内。Anthropic 也坦承两个方法论软肋:评委是自家模型("裁判和选手可能犯同类错误"),任务篮冻结在 7 月(测得出"旧工作被自动化",测不出"人类转向新工作"——不过他们对比 1 月和 7 月的任务篮,未发现新任务类型显著增加)。
[1]仪表盘二:3 万个代理的监督网格
第二项测量回答:当代理开始替我们决定"下一步研究什么",监督跟得上吗?
截至 8 月,Anthropic 最常用的内部平台上,任一时刻约 30,000 个代理在做研究和工程。监督分两层:
- 在线监控:100% 的代理动作在执行前(通常几秒内)过检,危险动作直接拦截或自动纠偏,被拦动作一周内由人工复核。8 月超过十亿次决策中,0.002%(约 4.7 万分之一)被在线拦截;
- 离线监控:100% 的动作事后被摄取,约千分之一二的对话记录被标记,每周约 10 万条进入多分类器复核,其中优先级最高的约 50 条升级到人工审查。METR 已对该离线监控平台做过独立红队测试。
报告还披露了支撑监督的两个架构选择:给每个代理独立的、跨模型升级持续存在的身份(所有行为可按代理个体审计),以及代理之间通过公开消息系统通信(互相可见、互相纠错,避免"传话游戏")。Anthropic 同时承认:只做了几个月而非几年的监控,"无法确定是否看清了所有可能的行为模式"。
[1]仪表盘三:算力的 6% 给了安全
第三项测量挑了 7 月 13 日至 20 日这一周,把全部算力负载分类:投入 AI 研发的算力中约 6% 用于安全工作;在"AI 驱动的 AI 研发"算力中,安全占约 12%。
Anthropic 强调这是刻意保守的口径:能力与安全"五五开"的工作全部计入研发而非安全;能大幅提升模型安全性的防护分类器算力也未计入。他们同时说明安全研究天然算力需求低(研究员设计实验耗的是人时),所以这个指标的价值不在绝对数,而在跨实验室、跨时间的同口径比较——算力是 AI 研发中最可验证的投入,可能因此成为未来"协调减速"的关键杠杆。
[1]分析:三个判断
第一,递归自我改进(RSI)第一次有了公开进度条,而它的斜率比读数更重要。"AI 建造 AI"过去是论坛论战里的思想实验,Anthropic 把它变成了一个可月度追踪的指数——AL4 占比五个月从 1% 到 26%,如果这条曲线再按这个速度走半年,"是否触发更强管制"就不再是哲学问题而是日程问题。这套指数的真正野心是成为行业标准:报告反复呼吁其他前沿实验室用公开方法论报告同一指标,并让第三方交叉验证。谁先定义度量衡,谁就定义了"减速"谈判桌上的语言。
**第二,监督数据最诚实的地方,恰恰暴露了最难的瓶颈:人的带宽。**0.002% 的拦截率听起来很低,但基数是单月十亿次决策;每周约 50 条最高优先级告警升级到人工——这个数字不会随代理数量线性扩张,因为审查它的是人。报告自己点破了规模悖论:单个代理很少犯错,但当经济体里有百万、十亿个代理时,稀有事件会定期发生。"代理身份"和"公开通信"两个设计明显吸收了行业教训——持续性身份让"哪个代理干的"永远可查,公开消息让代理互相监督,这正是对"代理私下串联"场景的针对性防御。
第三,6% 这个数字是一次精心计算的政治行动。安全算力占比并不漂亮,主动公布一个不漂亮的数字,是为了抢在监管者之前设定"诚实口径"的基准:举证责任在开发者、边界从严、第三方核验。它同时是一份含蓄的行业挑战书——OpenAI、Google 愿不愿意用同样保守的口径报出自己的数字?配合把独立第三方评估者嵌入内部流程、开放与内部风控团队同级的数据访问权限这一计划,Anthropic 正在把"透明度"从公关话术变成可审计的基础设施。当然,评委用自家模型、口径由自家定义这两件事提醒我们:这套仪表盘距离"公共基础设施"还差一个独立的读表人。
[1]附:短帖版(微博 / X 可直接发)
Anthropic 公开自家研发仪表盘:Claude 已"主导"26% 的 AI 研发(3 月才 1%,五个月 26 倍),90%+ 工作达"AI 协作"级;内部任一时刻约 3 万个代理在跑,8 月十亿次决策拦截率 0.002%,每周约 50 条告警升级人工;7 月那周 AI 研发算力仅约 6% 给了安全。递归自我改进第一次有了公开进度条——斜率比读数更刺眼。#Anthropic #AI安全 #递归自我改进
[1]