
要点
- Tether AI Research 发布了 BotPsy-0.8B,这是在 Qwen3.5-0.8B 上继续训练、用于端侧工具调用的模型,Apache 2.0 权重现已放在 Hugging Face。
- 作者自己在 2026 年 11 月 3 日完成的测试显示,它在主要智能体基准上大约把基座模型的分数翻了一倍,并在六项中的五项上超过 Qwen3.5-2B-Think,其中 BFCL v4 为 44.0,对方面为 37.7。
- 知识能力仍随规模上升:GPQA Diamond 为 38.1,2B 模型为 59.9。BrowseComp-Plus 为 4.5,是五个受测模型里最好的,但仍然很低。
- 训练分四个阶段:监督微调,再由三个 Qwen3.5-4B 专长教师做在线蒸馏,然后进行两轮强化学习。
- 作者写明,这个模型适合低到中等难度的任务,不适合高利害决策,也不适合涉及金钱、健康或个人信息的工作。
2026年11月11日,Tether AI Research 在 Hugging Face 博客发布了 BotPsy-0.8B。这是一个 0.8B 参数的模型,训练目标是在用户自己的设备上调用工具,充当个人助手。作者以 Tether Data, S.A. de C.V. 的名义写作,称选择在 Qwen3.5-0.8B 之上继续训练,是因为前沿云端模型成本高、可能被撤回,而且会把用户数据留在设备之外。真正有用的问题,比这套说辞更窄。这些公开分数证明的,是一个整体更强的小模型,还是一个专攻工具使用、而知识能力仍随参数规模上升的小模型?
[1][2]实际发布了什么
BotPsy 面向日常助手工作,包括检索、出行、购物与理财、日历与邮件、文件,以及设备或车辆控制。作者认为,它最适合低到中等难度的任务。权重已经以 Apache 2.0 许可放在 Hugging Face 上,提供 bf16、Q8 和 Q4,格式包括 safetensors,以及供 QVAC SDK 和 llama.cpp 使用的 GGUF。博客仍写模型“将发布”。仓库 qvac/BotPsy-0.8B 目前已经可以访问。
作者把限制写得很清楚。BotPsy 仍会出错。它不适合安全关键或高利害的自动决策,也不适合涉及金钱、个人信息或健康的工作。推荐语言是英语。Multi-IF 在八种语言、三个回合里测试指令遵循,其中印地语和俄语的分数远低于英语、中文和几种欧洲语言。
[1][2]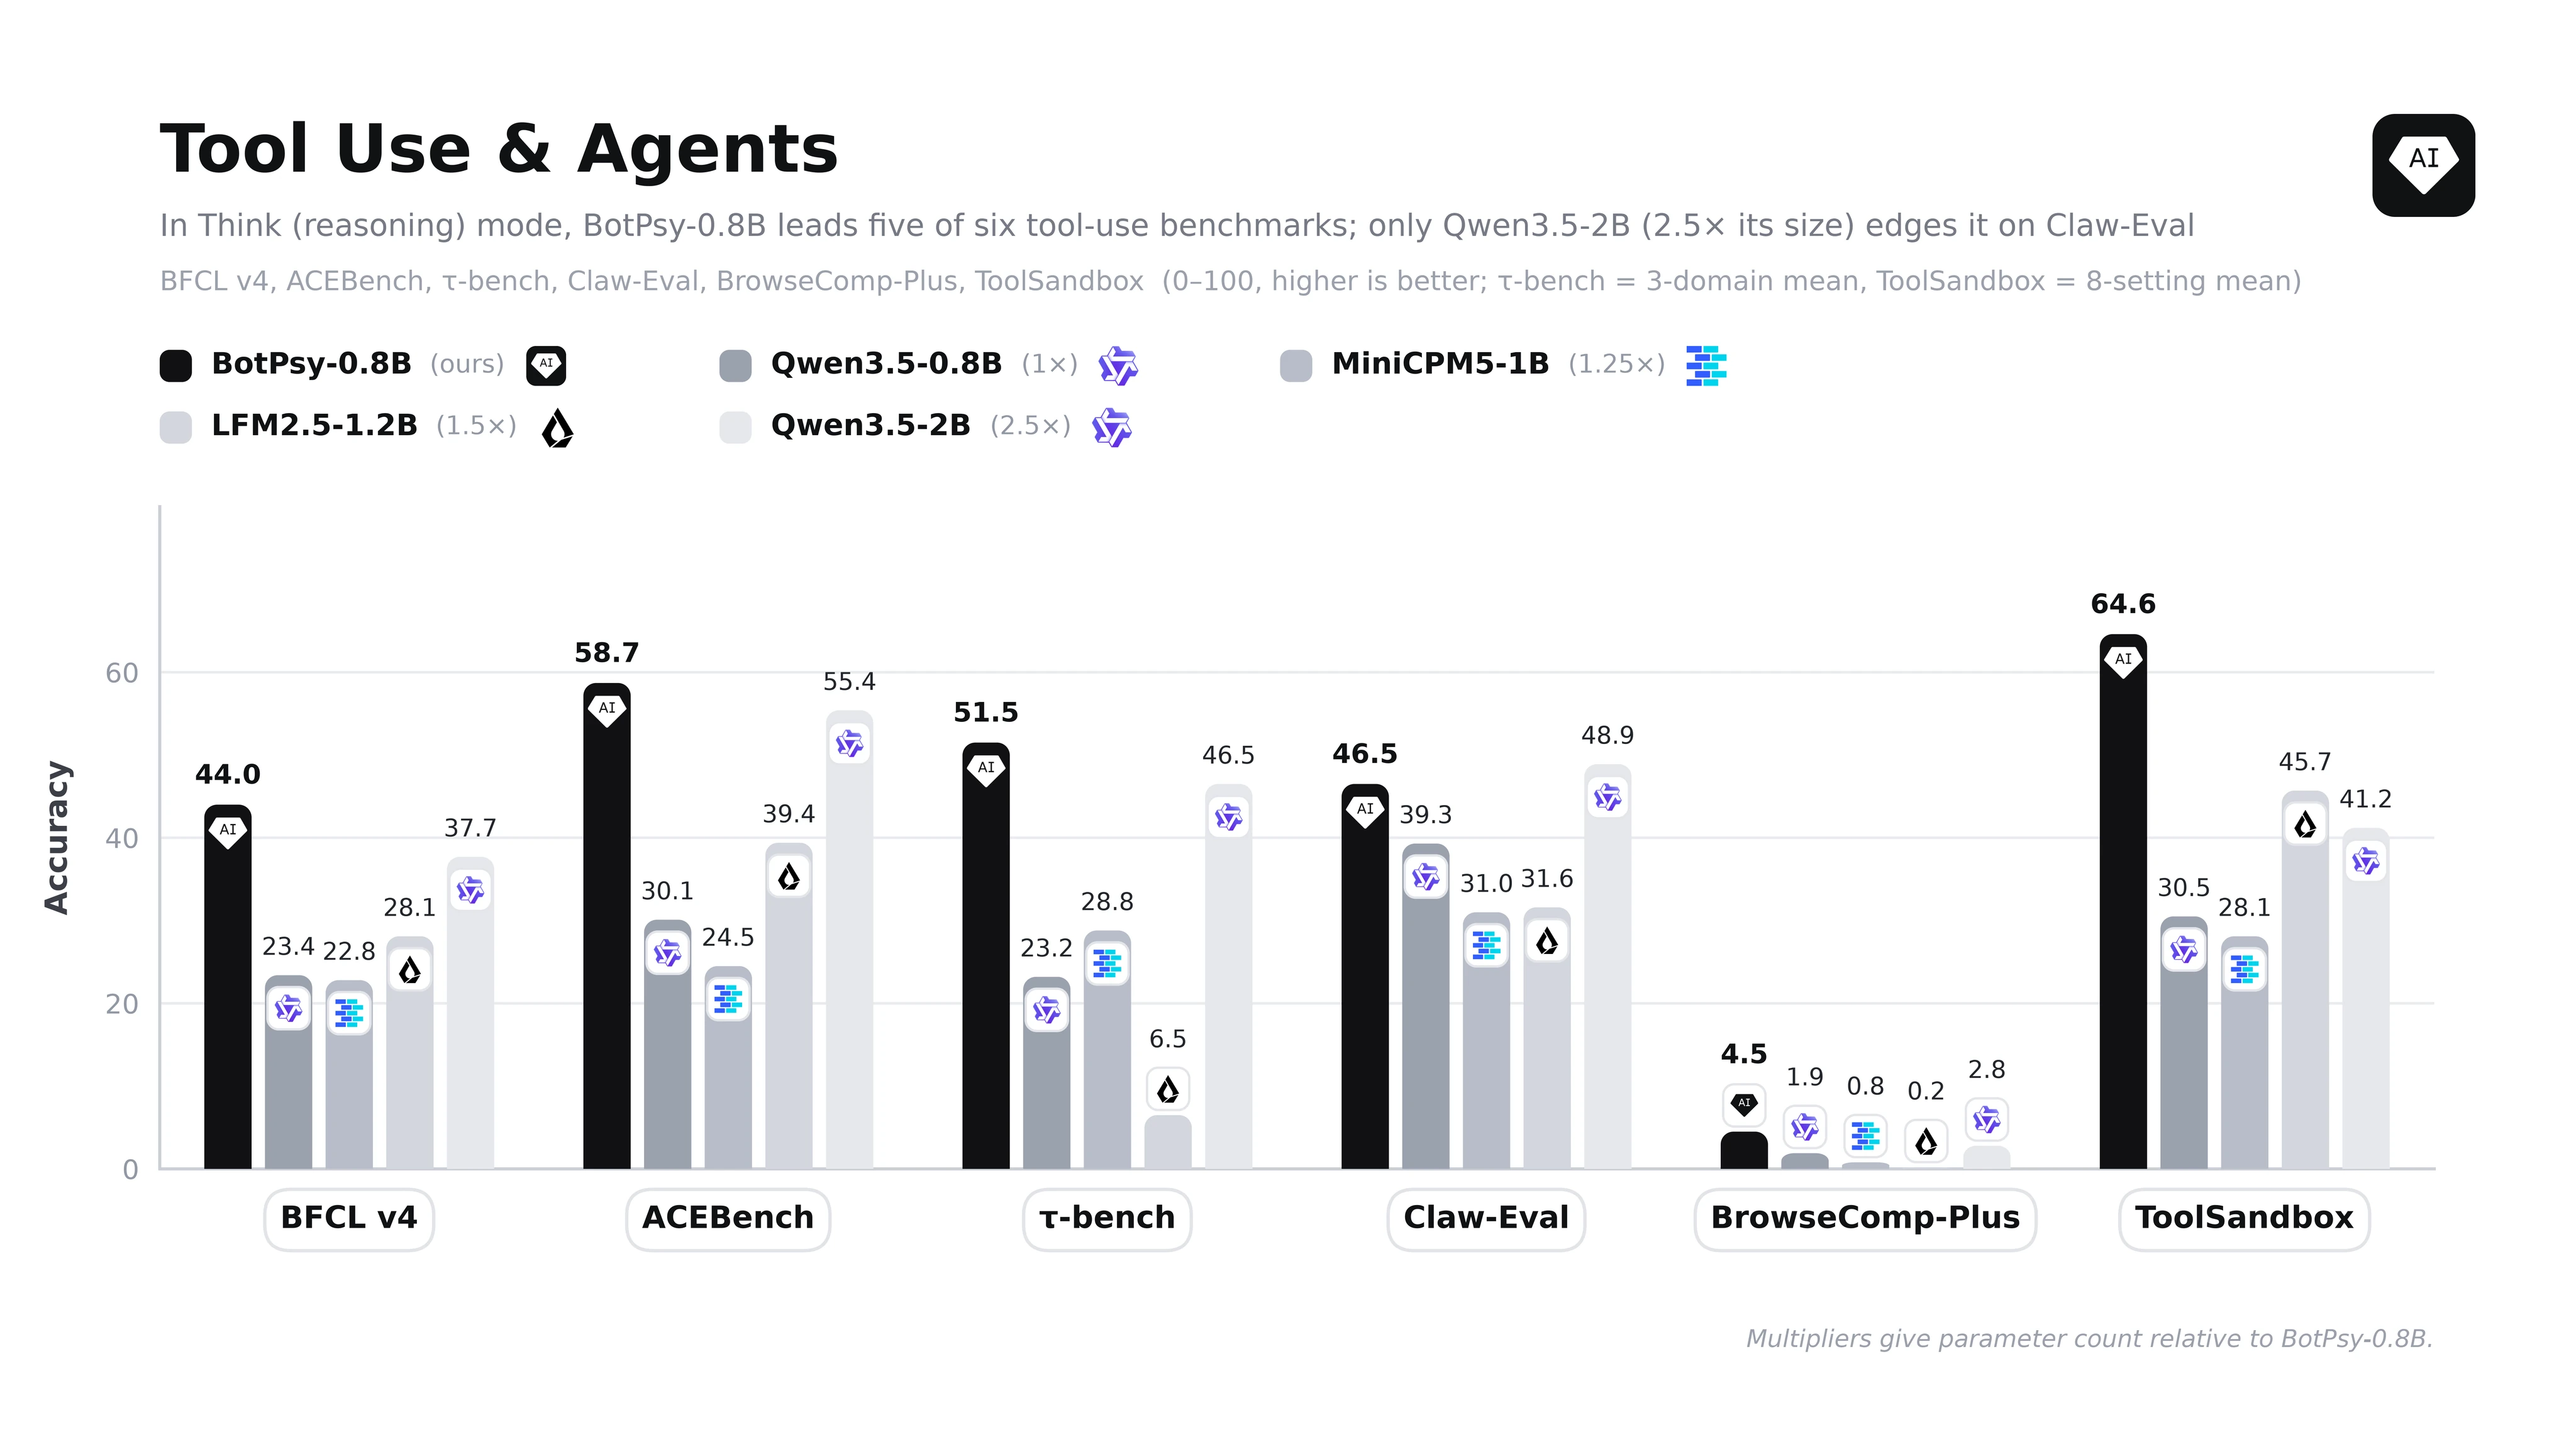
这些数字实际说明了什么
文中所有对比分数都来自作者自己。他们在思考模式下评测了五个模型,并把使用外部接口的评测日期标为 2026 年 11 月 3 日。文章里没有独立榜单的复核。
在六项工具使用与智能体基准上,BotPsy 的未加权平均分是 45.0,基座模型 Qwen3.5-0.8B-Think 是 24.7,参数量为 2.5 倍的 Qwen3.5-2B-Think 是 38.8。另外两个小模型 LFM2.5-1.2B-Think 和 MiniCPM5-1B-Think 分别是 25.3 和 22.7。
领先幅度最大的地方,是助手必须在多轮对话里调用工具。BFCL v4 是一项工具调用基准,官方加权包含智能体、多轮、在线、离线和幻觉测试。BotPsy 在这项上得 44.0,基座是 23.4,2B 模型是 37.7。其中多轮部分从基座的 7.5 升到 46.1,几乎是 2B 模型 23.8 的两倍。ACEBench 是 58.7 对 55.4。τ-bench 按作者口径,是 τ²-bench 零售与电信,再加上 τ³-bench 银行的平均,为 51.5 对 46.5。ToolSandbox 是 64.6 对 41.2。
2B 模型仍在 Claw-Eval 上领先,48.9 对 46.5;也在 ACEBench 的特殊案例上领先,这类请求不完整、参数有误,或现有工具无法满足,分数是 58.0 对 BotPsy 的 51.3。BotPsy 在这里已经远高于自己的基座,基座只有 13.7。
工具使用训练并没有把知识能力打垮,也没有追上更大的模型。GPQA Diamond 从基座的 33.2 升到 38.1,Qwen3.5-2B-Think 则是 59.9。MMLU-Pro 从 41.6 升到 48.9,对方面是 65.5。作者把这一点写得很直白。知识能力仍主要随参数量上升,BotPsy 的设计是对它不知道的事实去调用工具。
指令遵循是这项较小模型在通用技能上领先的一项。IFEval 是 90.8,2B 模型是 80.0。IFBench 是 55.9 对 40.9。在 Multi-IF 上,BotPsy 第一轮最强,为 84.3,到第三轮降到 51.0,低于 2B 模型的 56.5。
[1]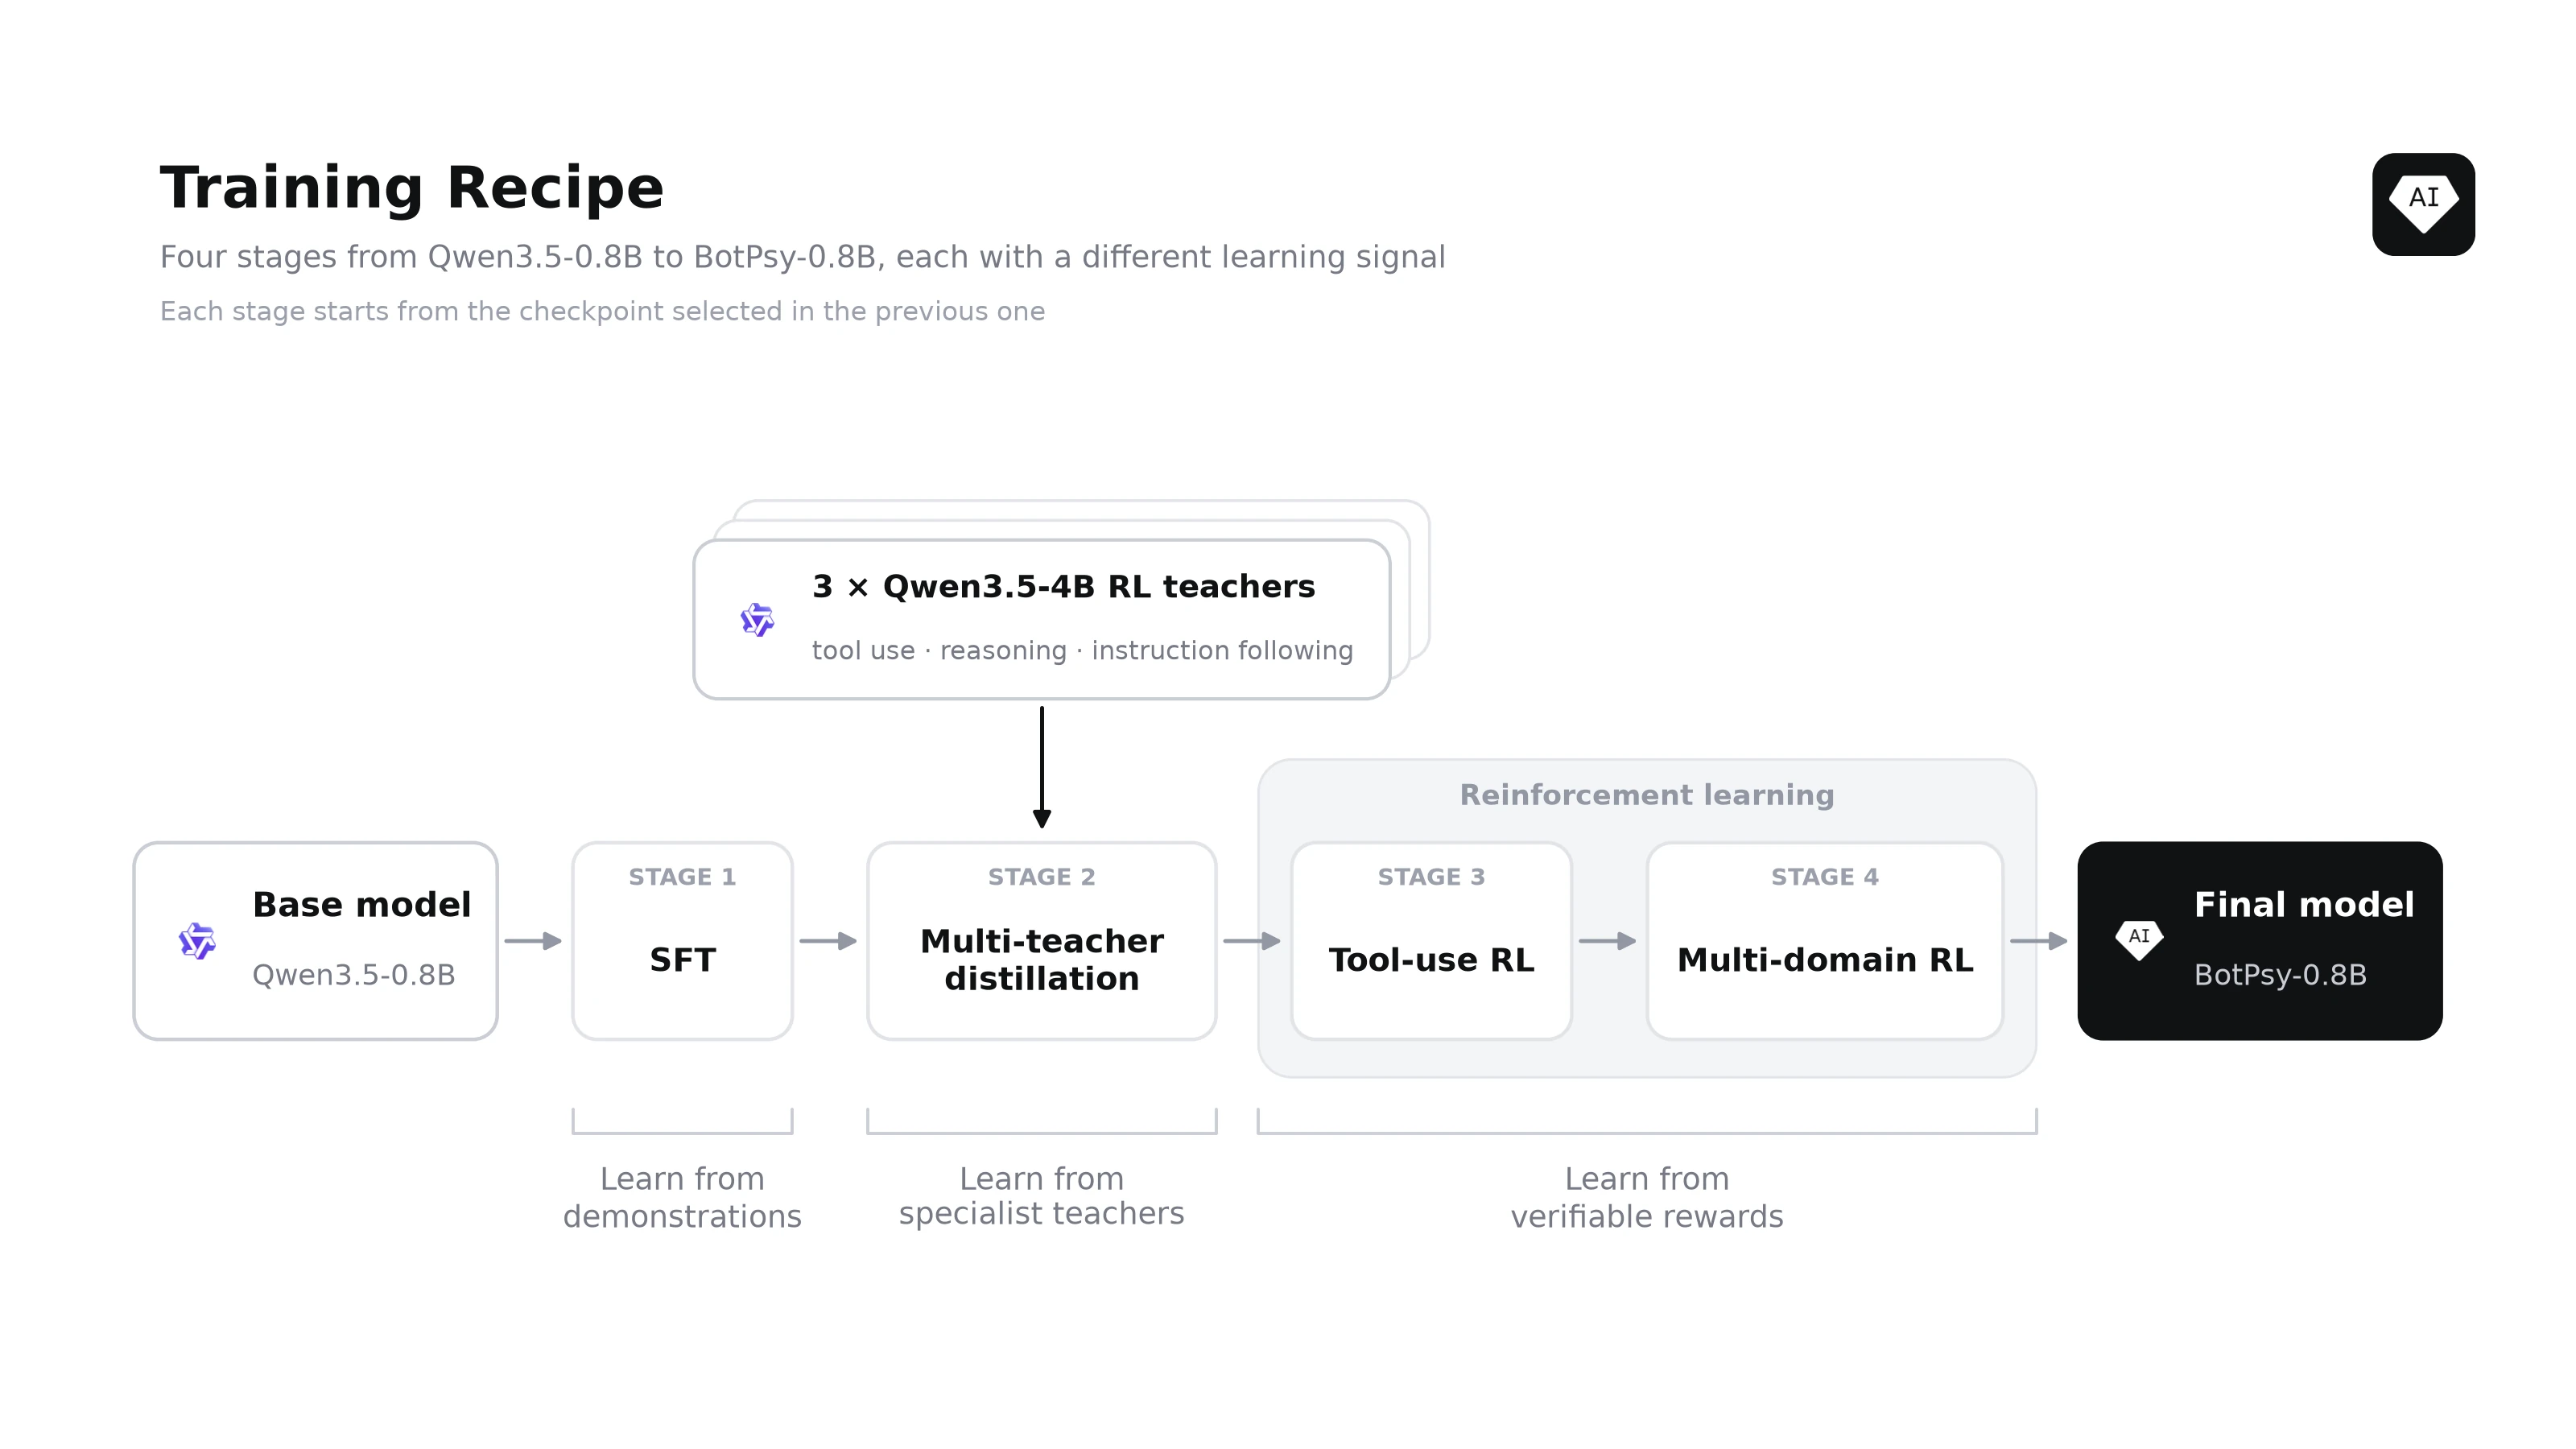
它是怎样训练的
如果后来有一个头条数字发生了变动,仍然站得住的是训练方法。学生模型经过四个阶段,每一阶段都从上阶段最好的保存版本接着训练。
第一阶段是在工具使用对话上,对全部权重做监督微调,其中也包括不应调用任何工具的例子。作者自己的训练曲线写出了这一步的代价。工具使用分数上升,知识能力和指令遵循却掉到了基座模型以下。
第二阶段是多教师在线蒸馏,作者简称为 MOPD。学生模型先自己生成回答。三个专长各异的 Qwen3.5-4B 教师里,会有一个对每个词元给出反馈,训练信号是反向 KL 散度。这三个教师事先分别用强化学习专攻工具使用、一般推理和指令遵循。文章说,这一阶段的主要目的,是把监督微调里丢掉的知识和指令遵循找回来。工具使用分数也继续上升。
随后是两轮强化学习,方法是 DAPO。奖励来自规则和校验器,而不是一个学来的偏好模型。第一轮以工具调用为主,并对工具名称、参数名称和参数取值给部分分数,而不是只给对或错。第二轮加入数学、代码、知识问答、指令遵循、结构化输出,以及模拟职场中的多步工具使用。作者注明,第二轮的数据里没有多轮对话,但多轮函数调用仍然提高了。
这套流程主张的是专长化,而不是一个新的基座模型。如果后来的独立评测仍能保持工具使用上的领先,也仍能看到知识能力上的差距,真正值得看的就是这套训练后配方。
[1]小模型仍然失败的地方
最清楚的警告来自 BrowseComp-Plus。这是一项开放式、多步的搜索测试,步数上限是 30。BotPsy 得 4.5,是五个模型里最好的,但仍接近零。2B 模型是 2.8,基座是 1.9。在 BFCL 的网页搜索和记忆分项上,2B 模型领先,分别是 19.8 和 26.1,BotPsy 是 14.0 和 16.3。复杂的信息检索场景得 15 分,同一组里简单、单次调用的场景则是 79。
τ³-bench 的银行任务是第二处停顿。参与对比的模型没有一个超过 5 分。BotPsy 是 4.1,与基座相同。2B 模型是 4.8。在更难的客服场景里消失的增益,说明不了通用智能体。
安全数字也应当和产品主张放在一起看,因为这是一个会阅读工具输出的端侧智能体。作者在六个伤害类别上做了自动红队测试,BotPsy 给出不安全回答的比例是 21%,低于基座的 36%,也是不超过 1.2B 参数的受测模型里最低的。在提示注入攻击下,也就是把指令藏进模型被要求阅读的输入里,不安全比例是 31%,低于基座的 46%。这是改进。如果一个智能体被允许接触邮件、文件或支付,这个比例仍难以接受,这也是限制说明把这些用途排除在外的原因。
效率数字对手机更有说服力。在五个模型都答对的问题上,BotPsy 在 GPQA Diamond 上用的推理词元大约只有基座的三分之一,是 3,690 对 11,563;在 MMLU-Pro 上约少 2.7 倍,是 1,912 对 5,105。在全部 IFBench 尝试里,陷入重复推理循环的比例从 22.9% 降到 1.4%,撞上 32,000 词元上限的比例从 28.3% 降到 0.2%。在五个模型都完成的 τ²-telecom 任务上,它平均用 13.1 个助手回合,基座是 17.6。
[1]更公允的读法
更公允的读法是:手机和电脑上的助手不必记下每一条事实,只要它能调用工具,能在没有合适工具时拒绝调用,并能在多轮任务里做完而不陷入循环。BotPsy 在 BFCL v4 的幻觉测试上得 86.1,是五个模型里最高的。这项测试检查的是,在没有合适工具时,模型会不会拒绝调用。再加上比基座短约 3 倍的推理轨迹,这才是把一个专攻工具调用的 0.8B 模型放到设备上的实际理由,而不是再等一个在 GPQA 上仍然知道得更多的 2B 模型。对改日历或改设备设置这类工作,这个理由站得住。
它对开放式研究站不住,对作者已经排除的高利害工作也站不住。一个在 BrowseComp-Plus 上只有 4.5 分的模型,不能被说成私人搜索的替代品。一旦工具输出不可信,31% 的提示注入不安全比例就不能被忽略;助手一开始浏览网页,输出就会变得不可信。
文末关于更广阔前景的段落,应当当作路线图来读,而不是当作已经得到的结果。Tether 描述了后续工作,包括名为 Hypersearch 的私密点对点查询、QVAC Fabric 的本地微调,以及把重活从手机交到家用电脑。这些系统都没有出现在分数表里。
[1]谁该在意,接下来看什么
正在 1B 量级的工具调用模型和稍大一些的通用模型之间做选择的端侧与边缘团队应当关心,尤其是他们能在本地运行 Q4 GGUF,并能把高利害动作留在人工或硬性规则之后。比较训练后配方的实验室也应当关心。监督微调之后分阶段把能力找回来,就是这里的机制,而且写得足够清楚,可以拿到别的基座模型上试。
未来六个月要看的事情很具体。第一,用已发布的权重做独立的 BFCL v4 和 ACEBench 评测,是否还能对 Qwen3.5-2B-Think 保持领先。第二,在真实手机上的 Q4 GGUF,能否保住多轮分数和更短的推理轨迹,还是只有 bf16 数字才成立。第三,BrowseComp-Plus 或类似的搜索测试,分数会不会离开接近零的位置。如果工具使用上的领先还在,而搜索仍停在 4.5 附近,诚实的产品定位就是本地的工具调用专长模型,而不是通用的私人助手。
[1][2]收束
BotPsy 是一项写得很克制的主张:在 0.8B 参数上,训练后配方可以买到工具使用能力,同时不必把基座模型的知识抹掉。同一条证据也表明,知识能力仍随规模上升,而这一重量级里的开放式搜索,分数仍接近不及格。对想在设备上运行助手的人来说,这是有用的结果。若把它夸大成小模型取代大模型的故事,证据就撑不住。
[1]