
Artificial Analysis 在协调世界时 2026 年 11 月 9 日 19 时 45 分发帖,北京时间是 11 月 10 日 03 时 45 分。帖子称 Anthropic 已经发布 Claude Fable 5.2,并在该机构 Intelligence Index v5 上以 65 分排到第一。帖子把上涨主要记在科学推理、知识和 FrontierCode 2.0。
[1]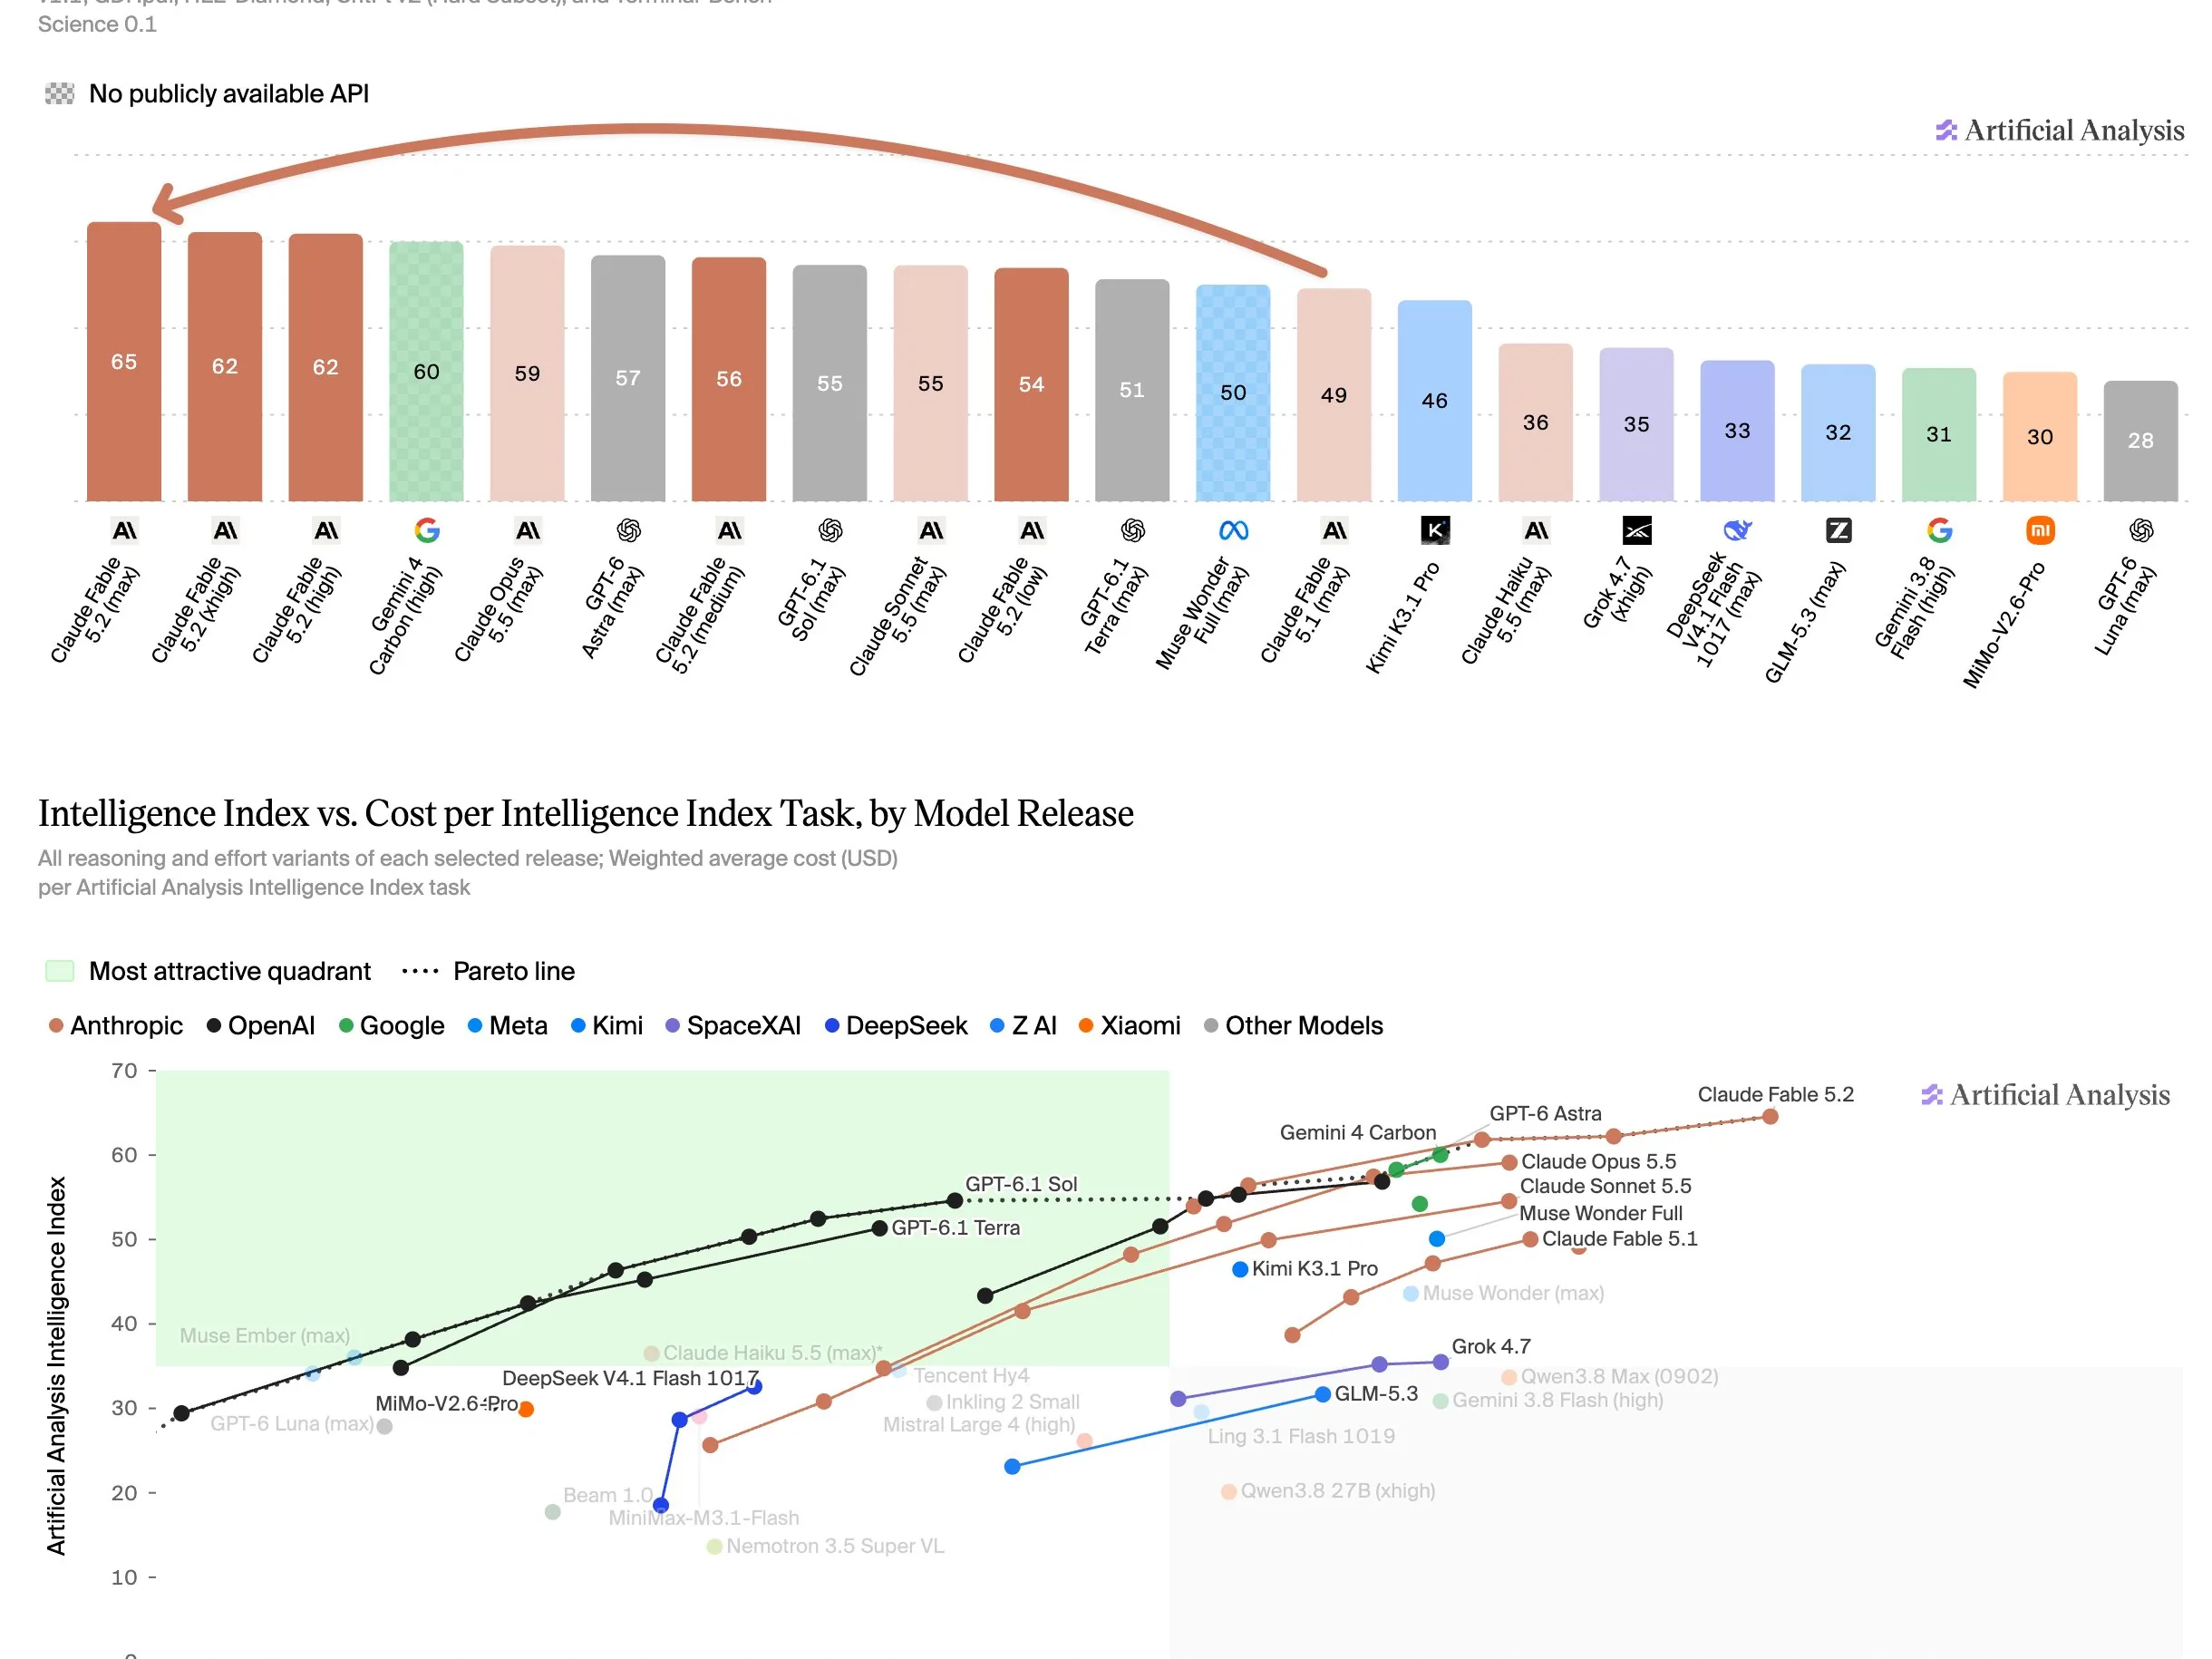
最高努力档的分数是 65,比 Gemini 4 Carbon 的 high 档 60 分高 5 分,比 Claude Opus 5.5 的 max 档 59 分高 6 分,也高于 GPT-6 Astra 的 max 档 57 分,并比 Claude Fable 5.1 的 max 档 49 分大约高出 15 分。帖子写,指数包含的 9 项评测里,Fable 5.2 在 5 项上取得现有最高分:HLE-Diamond 80%,此前最高是 Gemini 4 Carbon 的 69%;AA-Omniscience v1.1 为 67,此前最高是 54,同样来自 Gemini 4 Carbon;Terminal-Bench-Science 73%,此前最高 65%;CritPt v2 困难子集 77%,此前最高是 GPT-6 Astra 的 72%;FrontierCode 2.0 为 49%,此前最高是 Claude Opus 5.5 的 46%。
[1]同一条帖子写了没有拉开的项目。AA-Briefcase 是 1785 Elo,落在 Opus 5.5 的 1800 的置信区间内,并略低于 Claude Sonnet 5.5 的 1813。GDP.pdf 全通过率 24%,Opus 5.5 是 26%。Terminal-Bench 4.0 是 60%,与 Opus 5.5 持平,低于 Kimi K3.1 Pro 的 67%、Gemini 4 Carbon 的 65% 和 Sonnet 5.5 的 64%。AutomationBench-AA 是例外,76% 对上 Opus 5.5 的 70%,仍略低于 Gemini 4 Carbon 的 78%。
[1]标价是每百万输入 token 8 美元、每百万输出 token 40 美元,比 Fable 5.1 低 20%。最高努力档的单任务成本是 26.5 美元,大约是 Opus 5.5 最高档 10.0 美元的 2.6 倍,大约是 Fable 5.1 最高档 12.99 美元的 2 倍。high 与 xhigh 两档的指数分是 62。帖子称,这已经高于其他模型任一努力档的分数,单任务输出 token 约 9.8 万,Opus 5.5 最高档是 17.3 万。帖子同时写,把努力档降下来之后,可以在更低的单任务成本上超过 Opus 5.5。上下文窗口是 100 万 token,输入包含图像和文本。缓存写入按 5 分钟生存期每百万 10 美元、1 小时生存期 16 美元计,缓存读取 0.20 美元。努力档共五档:low、medium、high、xhigh、max。指数在五档上都跑过,并打开了 Anthropic 的默认回退。
[1]帖子没有写这些分数是否经过独立复现,也没有区分正式版和预览版。Anthropic 的发布页只标了 11 月 9 日,没有钟点,这篇只采用这条带钟点的评测帖,不把发布页的其他说法并进来。
[1]要点
- 指数 v5 最高档 65 分,九项里五项被写成现有最高
- 公文和终端类评测大体停在 Opus 5.5 附近
- 最高档单任务 26.5 美元,约为 Opus 5.5 最高档的 2.6 倍