
Figma 这篇文章标着 2026 年 10 月 29 日,作者是软件工程副总裁 Josh Clemm。页面的结构化时间写成当天 21:00(UTC),分和秒都是零,不宜当成量过的钟点。主题板上另有一条 20:40:40(UTC)的时间,那是卡片出现的时刻,不是文章正文里的钟点。
[1]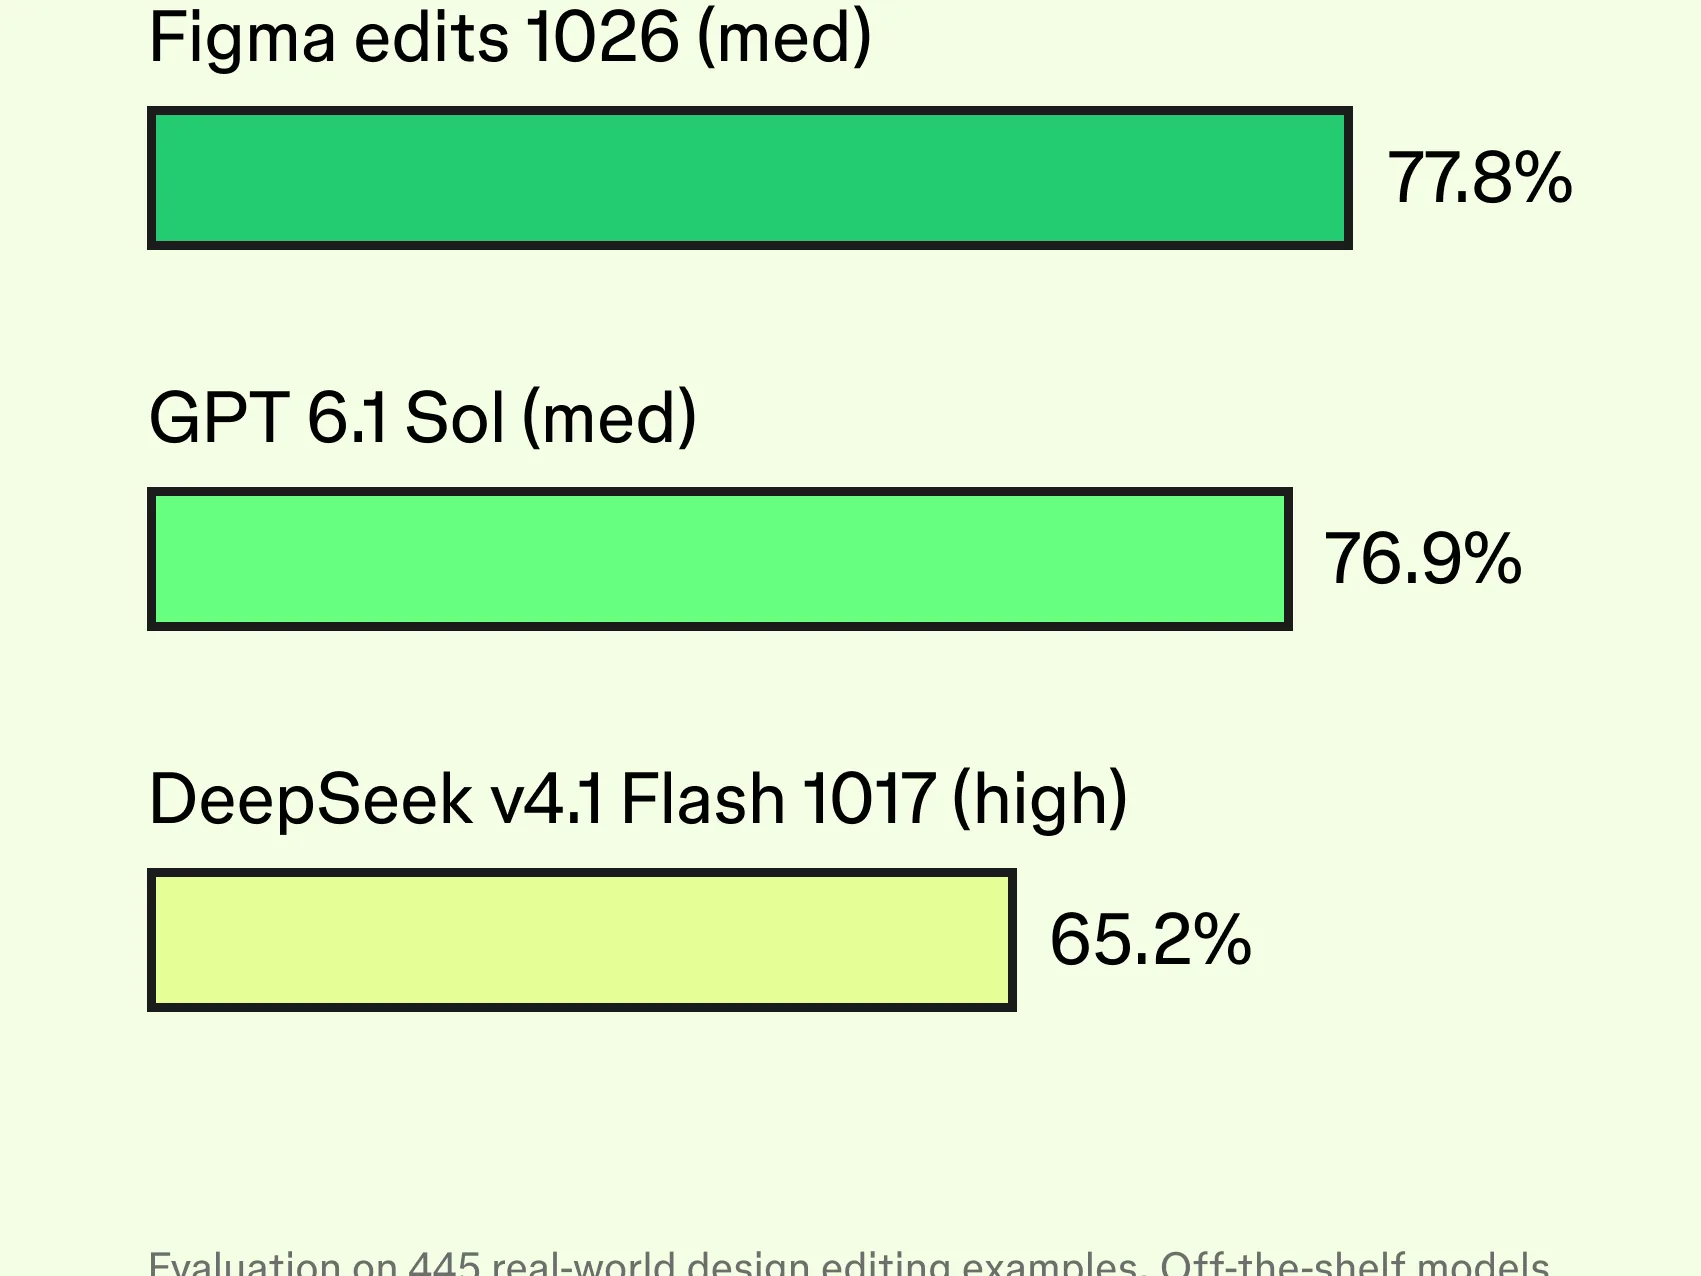
文章写,专门的后训练可以在这类任务上和前沿模型竞争。他们要做的具体事情,是改已经放在画布上的设计,而不是从空白开始画一张新的。文中说,动手时前沿模型读不懂 Figma 的语法,若靠大量系统提示,标记消耗会很高,于是改走监督微调。每条训练样本把一份起始设计、一条合成的修改请求,以及一次成功的修改配在一起。设计用的是 Figma 自己的文件格式,这样模型产出的改动可以再应用到画布上。
[1]更大的教师模型先尝试这些修改,再用确定性的校验和视觉模型来检查,包括输出是否有效、请求有没有被完成。生成流程可以根据评估反馈自己修订。文章写,较早的一个 Llama 3.3 70B,在超过 25 万条样本上训练之后,编辑任务上曾经和当时的顶尖模型接近。后来基座换成了更新的 Qwen 模型、Muse Spark Open、Inkling 等。监督微调单独使用会碰到限度:模仿学习让产出靠近训练里见过的设计,泛化变差,而且样本效率更低。文章说,最新的训练配方也在投入强化学习。
[1]正文里有一句,拿来比较的是尚未发布的 Figma 编辑模型,后训练基座是 Qwen 3.8 27B。同一页的图上,第一行印着 “Figma edits 1026 (med)”,77.8%;第二行是 “GPT 6.1 Sol (med)”,76.9%;第三行是 “DeepSeek v4.1 Flash 1017 (high)”,65.2%。图注写,评估用了 445 个真实设计修改例子,现成模型用默认力度,由一个自动设计评判打分,而这个评判另经人工校验过可靠性。替代文本却写成 “Figma design edits v3” 对 “Sol 6.1”,没有点出第三行。三处名称对不齐。这篇不把图上的 77.8% 说成已经上线的那个模型的分数。
[1]产品侧是另一组数字。文章写,本月较早时候,Figma 代理已经向全部用户开放,其中包含第一方编辑模型。代理同时跑这个专门模型和领先的第三方模型,按任务分开用。图像生成、矢量,或全新的设计探索,用当时最好的第三方模型。专门模型做得好的精确修改和迭代,用自己的模型。从测试到正式可用,常规任务大约快了 20%。在和专业设计师的对照里,新代理有 62% 的次数打平或胜过先前的正式代理。用户评分高了 33%,用户撤销代理结果的次数少了 60%。自有后训练设计模型承担的工作份额增加了一倍以上,每条消息的平均成本下降。文章写明,这些变化来自模型、工具和 harness 一起改,编辑模型只是其中一部分。
[1]因此,20%、62%、33% 和 60% 说的是整个代理从测试到正式的变化,不是图上那一个未发布模型单独的分数。图上的 77.8% 对 76.9% 也只是公司内部评估的一次对照,替代文本和图形标签还没有用同一个名字。页面没有给出 62% 对照的场次,也没有给出评分升高的样本数。
[1]