
要点
- LeagueLabs(HF Community,2026-10-29)优化 DiffusionGemma 26B-A4B BF16 在 vLLM CPU 上的决策服务:合格 structured read 从两个 engine step 收成一个。
- C4(24 vCPU)上:并发1延迟 −18.8%;并发2–20 吞吐 +5.5–15%;单决策成本 −5–13%。相对 C3 月费 −44%,相对 A100 部署 −79%(常开副本)。
- 动机:决策模型输出固定选项概率(Jev 式),需自托管 Apache-2.0 权重与低延迟;A100 常开约 $4754/月,C4 约 $996/月(文中 2026-10 us-east4)。
- JevBench 准确率变化不显著,但单条决策会变;同构建从 C3 迁到 C4 改变的决策数多于该优化。相关 CPU structured-read 修复已合入 vLLM,优化 PR 评审中。
医疗等场景里的决策模型不写长文,而是给固定选项打概率——快、可审计。League(LeagueLabs)在 Hugging Face 的 Part I(2026-10-29)问的是更窄的工程问题:DiffusionGemma 26B-A4B 以 BF16 跑在 Intel CPU 上时,vLLM 是否把每次合格 structured read 多走了一步引擎循环。
中心判断:账单与延迟首先卡在「两步变一步」的执行路径,而不是先买更大的 GPU;并且换机器可能比优化本身更剧烈地改写单条决策。
[1]发生了什么
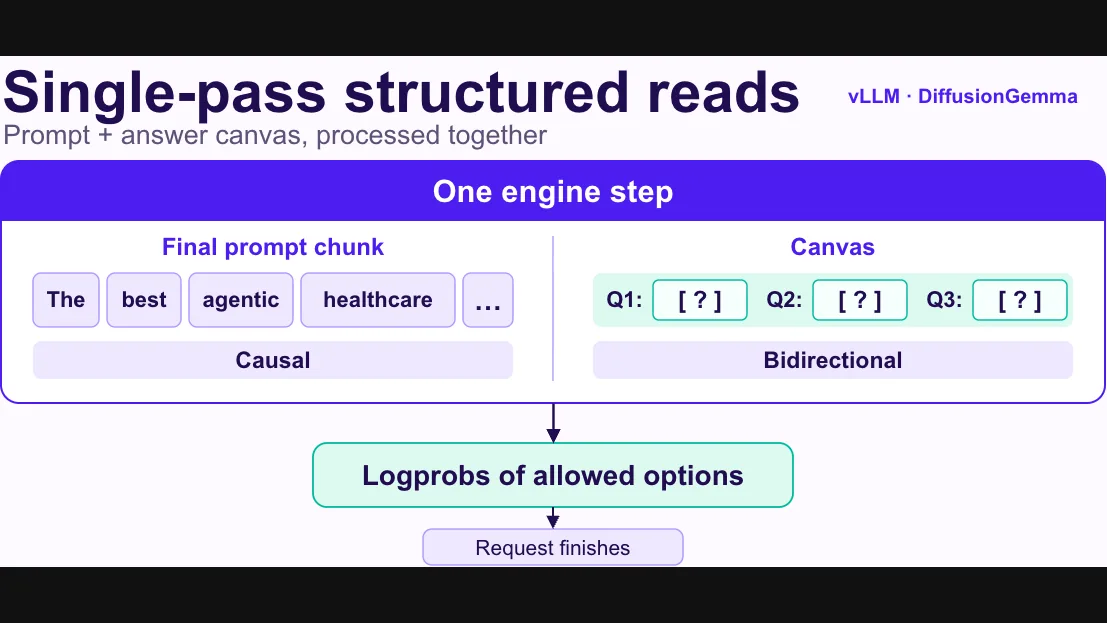
DiffusionGemma 用并行去噪填一块 canvas,而不是自回归逐 token。配合 structured read,请求可以钉住答案模板、限制选项、并在单次去噪后停住。作者定义「合格读」:单步去噪且不要求 prompt logprobs——其生产流量全是这类读。
基线 vLLM(含 v0.32.0)把编码器模式(写 KV)与解码器模式(双向去噪读 KV)拆成两个 engine step。优化让合格读在一步完成。落地前他们先把 CPU 上 structured read 的三处阻塞修进上游(窄 canvas 同步调度、int32 causal mask、异步快照缓冲),并随 v0.32.0 发布;一步路径本身仍在评审。
[1]证据有多硬
主结果在两台机器上给出:24-vCPU C4 与 44-vCPU C3。C4 上优化使并发 1 延迟降 18.8%,并发 2–20 吞吐升 5.5–15%,单决策成本降 5–13%。选型层面,C4 常开副本月费相对 C3 −44%、相对 A100 部署 −79%——这对「偶发决策、长空窗」的服务比峰值吞吐更重要。
行为侧:JevBench 准确率变化在两台机器上都不显著,但个别决策会变;同构建从 C3 迁到 C4,改变的决策数多于应用该优化。作者把这一点升格为方法要求:性能与成本只是一半,还要量「实现/硬件是否改写了决策」。
[1]钢人与缺口
钢人:把「决策模型」从生成模型账单逻辑里拆出来是对的;AMX BF16 + 同 API 的 CPU 后端降低迁移摩擦;把修复送回 vLLM 让证据可复核。
缺口:Part I 不展开 Part II 的决策一致性机制;JevBench「不显著」未在文摘层给出区间与样本量;A100/C3/C4 价格是时点报价;优化尚未合入主线时,外部复现依赖 PR。一步路径只覆盖合格读,带更多去噪步或 logprobs 的请求不在红利内。
[1]谁付钱、谁该改问题清单
对平台与采购:低流量决策服务应先问 engine 是否多走无用步、机器世代是否改写决策分布,而不是默认升 GPU 档。对合规医疗代理:准确率均值不变不等于逐案不变——变更管理要覆盖硬件与运行时。对推理引擎:structured read 的 CPU 路径应有与 GPU 对等的测试矩阵。
[1]六个月看什么
可证伪下一跳:一步优化合入后,独立复现是否仍见约 19% 的 c=1 延迟降幅;在固定硬件上,决策翻转率能否被压到业务可接受阈值;若换非 AMX 或非 BF16,成本曲线是否坍塌。主张不是 CPU 全面取代 GPU,而是:对结构化决策负载,先修执行路径与量决策漂移,往往比先加一块 A100 更接近可运维。
[1]