
要点
- Databricks 现场工程师博客(2026-11-04):“The Enterprise Case for Open-Weight Models on Databricks”;作者 Jay Palaniappan、Elise Gonzales、Tanner Waggoner、Toby Messinger、Will Middlebrook。
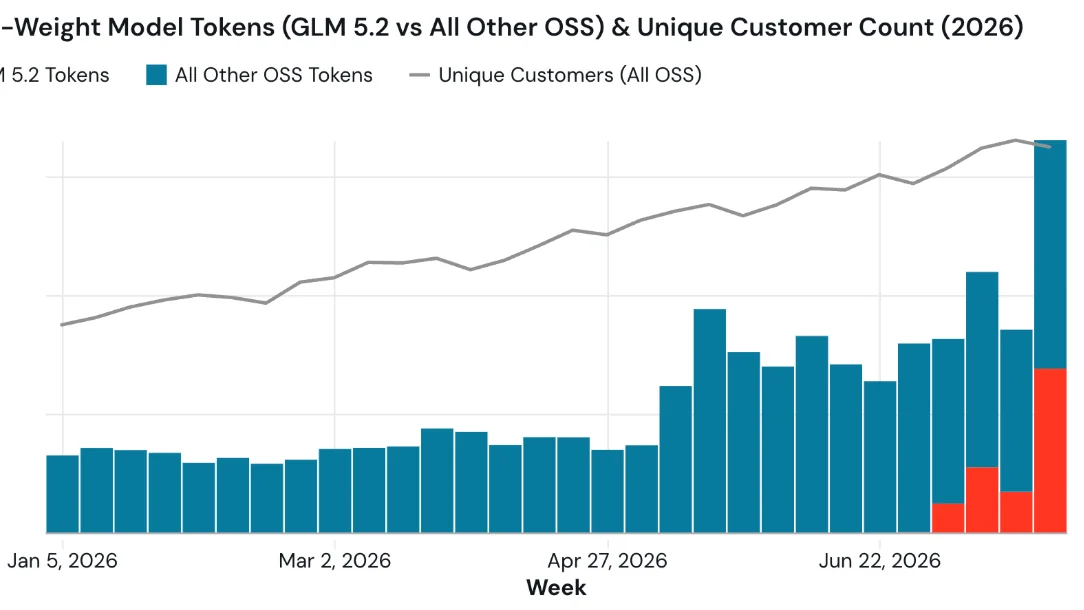
- 内部用量(截至 2026-01-05 周 → 2026-07-27 周):客户平均唯一模型 4.2→7.1;其中约 40% 为开源权重;7 月中旬 GLM 5.2 上线后约一个月占开源权重 token 约 40%。
- Databricks 自有基准中同一模型的 harness 分差:61.7% / 48.1% / 38.4%(harness A / harness B / 裸模型)。
- 援引 Artificial Analysis:GLM 5.3(max)在 Databricks 端到端响应 9.1 秒;以 Hugging Face 2026 年 7 月事件为例,前沿护栏拒绝恶意软件分析后,响应方改用开源权重 GLM 5.2。
2026 年 11 月 4 日,Databricks 发布现场工程师文章,主张企业不应再把单一前沿 API 当作默认架构。比标题更窄、也更可检验的句子是:企业 AI 正收敛到可治理的多模型网关,因为开源权重已在更低成本下逼近前沿基准表现,而 harness 选择对测得分的拉动不亚于模型名。单一供应商锁定因此是错误的战略单元。 若客户继续把支出与流量集中到一家前沿供应商,同时 Unity Gateway 上开源权重份额停滞或回落,该主张即失败。
[1]用量数字说了什么
Databricks 称,从截至 2026 年 1 月 5 日的一周到截至 7 月 27 日的一周,Unity AI Gateway 客户平均唯一模型数从 4.2 升至 7.1,其中约 40% 为开源权重。GLM 5.2 于 7 月中旬可用后,约一个月内即占网关上开源权重 token 约 40%,而网关客户增长相对平稳,更像存量流量迁移,而不只是新客户涌入。CEO Ali Ghodsi 对 CNBC 表示,7 月融资部分是为托管开源模型锁定 GPU,并提到日本、韩国、美国与印度的算力短缺。
这些是厂商遥测,不是行业普查。它们仍与许多 CIO 在 2024 年写下的「选定一家实验室并标准化」手册相冲突。
[1]七种压力,一个架构赌注
作者列举七种压力:AI 支出跑赢回报;榜单换手(BenchLM 追踪自 2023 年 5 月起榜首易主 20 次以上);前沿护栏挡住合法安全工作;留存策略偏离「零数据留存」假设;需要可检索的输入/输出/代理审计;harness 效应盖过模型品牌;开源权重以更低成本达到前沿级基准。
Hugging Face 2026 年 7 月事件是护栏的具体例子:响应方向托管前沿模型投喂真实攻击日志遭拒,随后用开源权重 GLM 5.2 完成分析。留存例子指向 Anthropic 前沿档 30 天最低留存,对假定提示永不落盘的合规政策形成冲击。
Unity AI Gateway 的产品答卷是:用同一套治理 API 覆盖开源权重、Databricks 托管前沿与外部提供方(Bedrock、Azure AI Foundry),并带智能路由、回退、预算,以及 Unity Catalog 下的 MCP/技能注册。Omnigent 被定位为可移植 harness 层,使 Codex、OpenCode 等编码代理通过配置指向网关托管的开源权重,而无需改写。
[1]钢人与缺口
钢人。 在任务上明显更强时,前沿 API 仍会赢;「自有 VPC 跑开源权重」仍要买 GPU、运维与补丁纪律。Databricks 有充分动机卖网关席位与 GPU 容量。内部「约 40% 开源权重」混杂大量小模型与少数大模型;GLM 5.2 的 token 份额不能证明每项受监管工作负载的质量对等。Artificial Analysis 延迟与 DeepSWE 按成本图是筛选后的对比,不是随机化的企业对照实验。
这一反驳成立。它抹不掉可核对的核心:多模型数量上升,竞争性开源检查点落地后开源权重流量发生迁移,且 Databricks 自有 harness 研究显示同一模型有 23 个百分点的摆动(61.7% 对 38.4%)。在这些事实下仍站得住的战略单元,是带路由与审计的组合,而不是单一模型 SKU。
文中未闭合之处:4.2→7.1 与 GLM token 份额序列缺乏独立复现;编码代理之外的「成功任务单位成本」;质量 SLA 收紧时智能路由实际选开源权重的频率;Omnigent 是降低锁定,还是把锁定迁到 Databricks 网关。
[1]谁该在意,下一步看什么
仍标准化在单一前沿的平台与 FinOps 团队,应测量生产中唯一模型数,以及在同一评测 harness 下可迁到开源权重的 token 份额。安全与合规团队应把护栏拒答与留存政策变更当作一等架构风险,而不是提示工程琐事。代理构建者应停止在不点名 harness 的情况下发布模型分数。
接下来观察:主要网关上开源权重 token 份额在下一轮前沿降价后是否继续上升;第三方是否复现量级相近的 harness 分差;受监管买方是否发布能在上游留存变更后仍成立的 ZDR 兼容开源权重运行手册。
[1]收束
Databricks 可辩护的句子不是开源权重总是打败前沿 API。而是:当同一模型跨 harness 可摆动约 23 个百分点、客户平均已跑七个模型时,耐久的控制面是可治理的组合,而开源权重已便宜到足以放进这个组合。 六个月后,要么网关遥测与独立 harness 研究继续确认这一组合,要么单一前沿标准化会以运维简单性悄然取胜。
[1]