
要点
- 2026 年 11 月 9 日,Amin Vahdat 宣布推出 TPU 8tx 和 TPU 8i Max,把 Google 第八代 TPU 产品线在同一年里扩到四套系统。文章称这是第一次。
- Google 在文中自己做了区分:新芯片是以年计的硅片项目;新系统则是在已有芯片周围,重新组合计算、网络和存储。
- TPU 8tx 面向机密推理和小规模训练。它让数据和模型权重在使用中也被隔离,搭配第 5 代 AMD EPYC CPU 主机,并称延迟最高可比 TPU 8t 低 2 倍,性能损失接近于零。
- TPU 8i Max 把两颗 TPU 8i 放进同一封装,在原有机柜占地内,把算力、片上 SRAM 和高带宽内存(紧挨芯片的那类高速内存)带宽加倍。
- 同一篇文章还公布了软件:开源的 TorchTPU、TPU Sync(称可把 KV 传输延迟和首 token 等待时间降低 90% 以上)、现已正式可用的 Cloud Pathways,以及 GKE 动态切片(任务启动最多加快 5 倍,故障恢复最多加快 4.5 倍)。
2026 年 11 月 9 日,Amin Vahdat 在 Google 博客上宣布,公司第八代 TPU 产品线将增加两个成员:面向机密推理的 TPU 8tx,以及面向超长上下文、并在同一机柜里堆出更多算力的 TPU 8i Max。文章说,这是 Google 第一次在同一年里推出四套 TPU 系统。真正应该管住读法的,是 Google 自己写的那句话。新芯片意味着重新做一块硅片,周期以年计。新系统则是在已经到手的芯片周围,改封装、改内存、改网络、改软件。8tx 和 8i Max 被写成第二种。
[1]芯片与系统
Google 在 4 月的 Cloud Next 上第一次介绍了 TPU 8t 和 TPU 8i。8t 是训练系统。8i 是推理系统,此前的说法是,它最高能把芯片之间的通信延迟减半。按 4 月给出的数字,这两款芯片相对上一代,训练性能最高可提高 2.7 倍,推理性价比可提高 80%。今天这篇文章,是在同一代上再加两种配置。
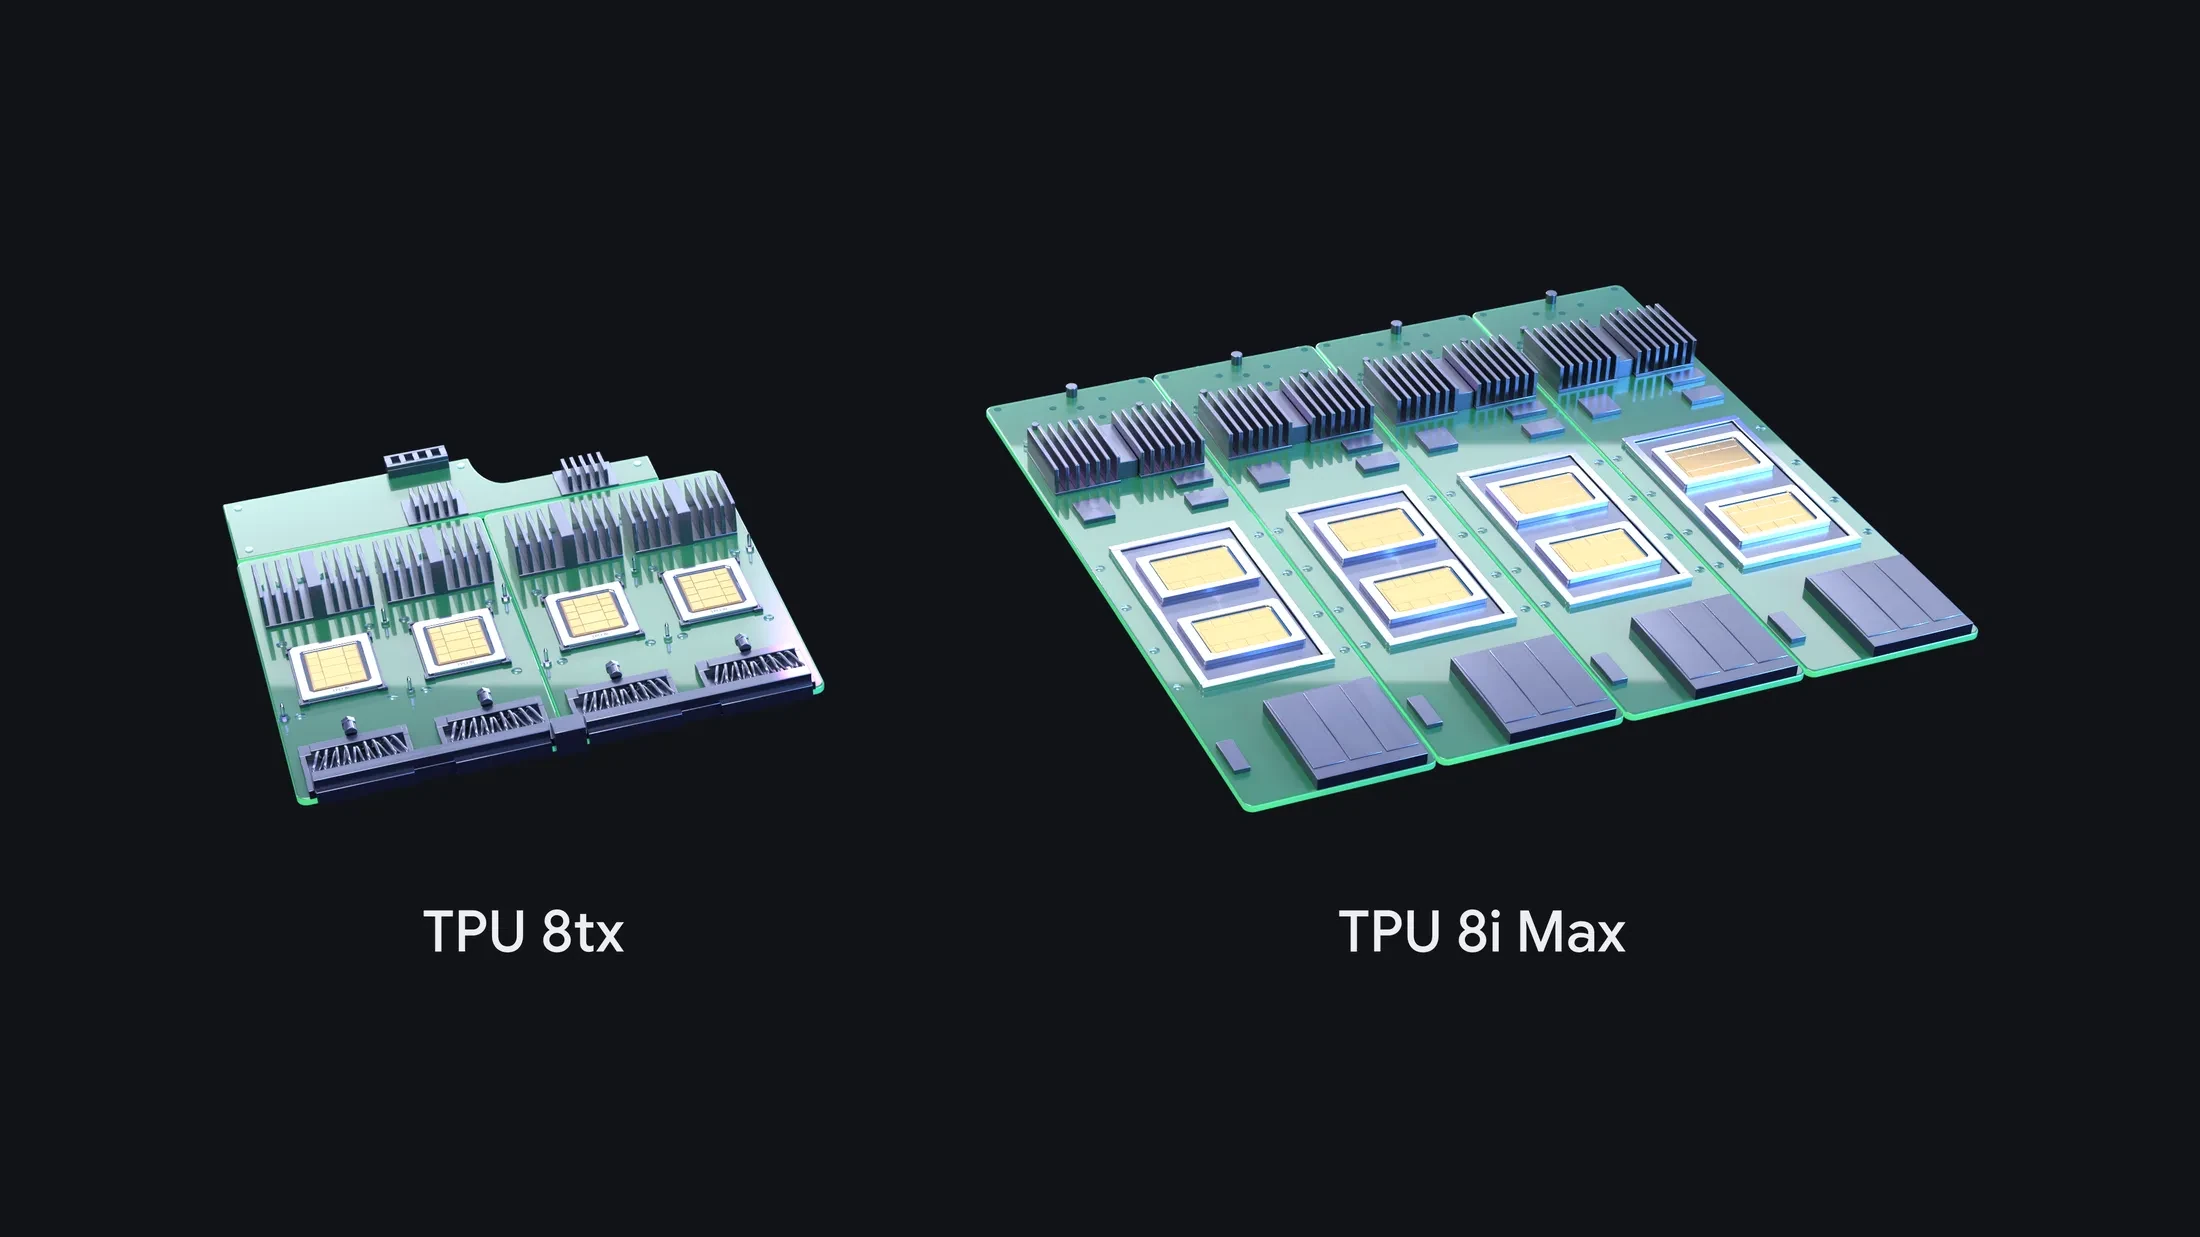
TPU 8tx 使用与 TPU 8t 相同的硅片,并搭配第 5 代 AMD EPYC CPU 主机。它要卖的是机密计算:数据在存储和网络传输时通常是加密的,但计算机在处理时,内存里往往要先解开。Google 说,8tx 能让敏感数据和模型权重在使用中也保持保护和隔离。它还采用了为实时推理做的低延迟 Boardfly 网络,并称延迟最高可比 TPU 8t 低 2 倍,性能损失接近于零。文章还说,因为它把训练级算力和快速推理网络放在一起,团队可以在私有数据上微调模型,把大模型蒸馏成小模型,并用强化学习训练智能体,而不必把这些数据在不同集群之间搬来搬去。
TPU 8i Max 是另一种封装变化。Google 把两颗低延迟的 TPU 8i 放进同一封装。它说,结果是算力、SRAM 和高带宽内存带宽都比 TPU 8i 翻倍,当许多智能体同时处理一整份代码库或数小时视频时,大任务更不容易卡住。由于两倍的硅片仍装在原有机柜占地里,文章认为数据中心能在同样的面积和功耗预算下放下更多算力。
四套系统随后被分配了角色:8t 负责大规模训练,8i 负责低延迟推理,8tx 负责机密计算,8i Max 负责超长上下文和单机柜最高算力密度。Google 还说,TPU 现在服务近 100 家客户,包括前沿实验室、交易公司、零售商和大学,而且部分客户可以把 TPU 部署到自己的数据中心。
[1]和硬件一起到来的软件
这篇文章很大一部分并不是在讲这两套新系统,而是在讲怎样让 TPU 更好用,以及怎样避免昂贵的芯片闲着。
上个月,Google 开源了 TorchTPU,使 PyTorch 代码和 Hugging Face 模型可以不用改写就在 TPU 上运行,并给 vLLM 和 SGLang 提供了 TPU 后端。一套尚在预览的 TPU 智能体工具,计划接入 Claude Code、Cursor 和 Google Antigravity 这类编程工具,用日常语言帮助完成接入、诊断瓶颈和调内核。开源的 XLA Serving Engine 被写成一种办法:用 Python 训练,再用低延迟的 C++ 运行时,在 TPU、GPU 和 CPU 上提供服务。
在生产基准上,文章指向 SemiAnalysis 发布的 InferenceX 和 AgentX 结果,并称在 TPU 上用原生的 vLLM-TorchTPU 软件栈,在这些针对智能体编程和长上下文的测试中达到了当时最好的性价比。这些引用是第三方在具名基准上的性价比结果。就正文而言,它们并不是在一般意义上声称 TPU 在所有任务上都胜过所有对手加速器。
其他软件说法更偏运行层面。Agent Compute Engine 被写成可以挂起并恢复空闲的智能体会话,这样任务在等数据库、外部工具或人的时候,芯片不必空转。正在开源的模型状态层 TPU Sync,被写成能在毫秒级把大型 KV 缓存(模型对已处理内容的工作记忆)移出芯片,并把 KV 传输延迟和首 token 等待时间(出现第一段输出之前的等待)降低 90% 以上。支撑 Gemini 的 DeepMind 运行时 Cloud Pathways,现已在 Google Kubernetes Engine 上正式可用,用单一控制器来调度大型 TPU 系统。同样正式可用的 GKE 动态切片,则用光电路交换随时拼装或拆分 TPU 立方,并称可把任务启动时间最多缩短到五分之一,把故障恢复最多加快 4.5 倍。
[1]更宽容的读法,以及缺口
更宽容的读法,正是 Google 在邀请的那种:当软件需求的变化快过新芯片的设计周期时,有用的做法是重新封装已经有的硅片。为受监管客户提供机密计算,以及在同一机柜里给长上下文智能体提供更高的内存带宽,都不必等到第九代。文章把这一区分写得很直白。
这些数字仍应读成供应商的"最高可达",除非第三方已经另外测过。2 倍延迟、接近于零的性能损失、加倍的带宽、首 token 等待时间降低 90%,以及 5 倍和 4.5 倍的集群数字,都来自 Google。SemiAnalysis 的引用可以去核对,但这篇文章没有重印完整方法和对照配置。文中也没有 8tx 和 8i Max 的时钟频率、内存容量或标价。"近 100 家客户"是业务数字,不是利用率或性能结果。
[1]谁该在意,接下来看什么
一直在等 TPU 上机密推理的云客户,以及智能体因上下文太长而卡住的团队,都应该关心。把"新 TPU"标题拿去和 NVIDIA 或 AMD 的新芯片发布直接对标的人,也应该关心。这不是同一类发布。
未来六个月,可以核对的是:8tx 是否真被用在受监管场景里的私有微调,8i Max 的密度说法是否出现在已部署的机柜里,以及 PyTorch 在 TPU 上的表现、还有 SemiAnalysis 的性价比结果,在更多外部团队复跑同样基准之后是否仍然成立。
[1]收束
Google 自己的框架是对的。8tx 和 8i Max 是围绕第八代芯片搭建的系统,用来满足 4 月那两台机器没有完全覆盖的两类需求:使用中也必须受保护的数据,以及在同样占地里更高的内存带宽。硬件上的说法,要靠实际部署和那些第三方基准来裁定,而不是靠"智能体时代"这几个字。
[1]