
要点
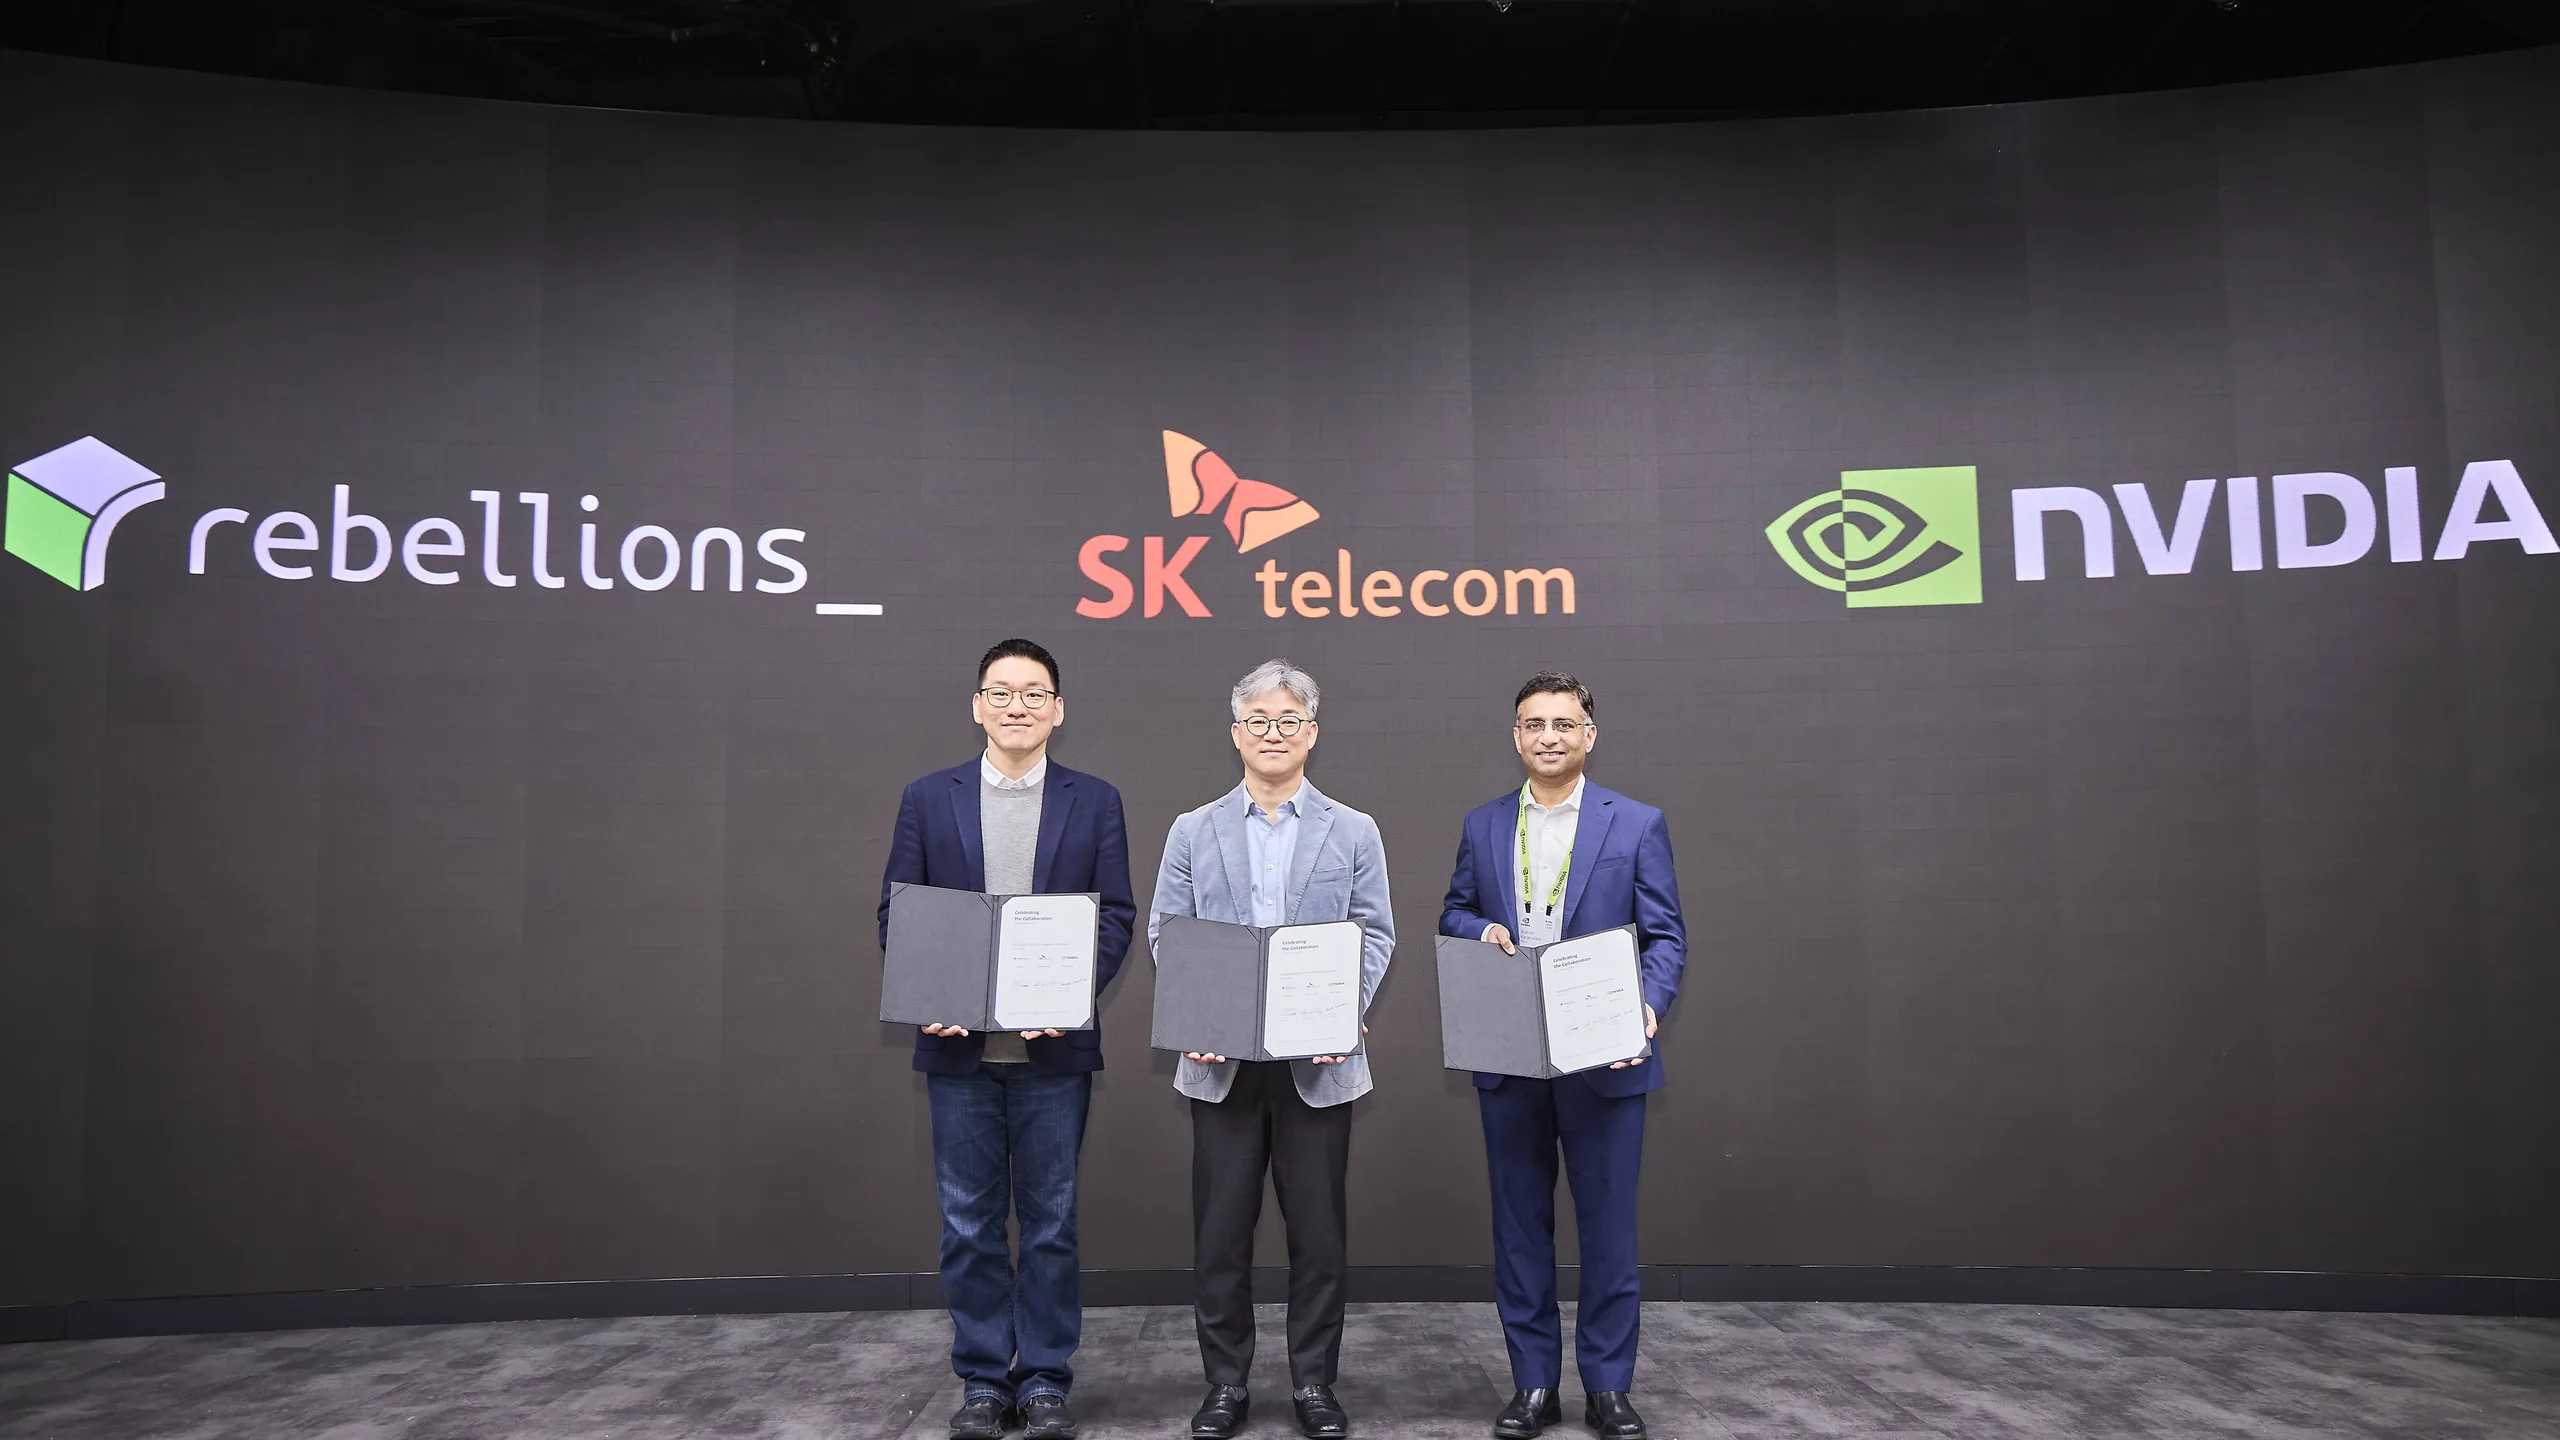
- SK Telecom 说,三家公司于 2026 年 11 月 9 日在首尔 COEX 的 NVIDIA AI Day Seoul 签署谅解备忘录,开发和验证一套 GPU 与 NPU 组合系统。
- NVIDIA 说,Rebellions 将用 NVLink Fusion 把它正在开发的下一代 Rebel R200 神经网络处理器接到 NVIDIA 平台,并采用 MGX 机架设计。
- 计划里,NVIDIA GPU 负责预填充,也就是生成回答时计算更重的第一阶段;Rebellions 的 NPU 负责解码,也就是逐个词元写出回答的第二阶段。
- NVIDIA 的新闻稿写明,R200 系统预计 2028 年才能投入部署。
- 韩国科学与信息通信技术部支持此项合作。科学部长的说法是,韩国 NPU 通过 NVLink Fusion 与 NVIDIA 一起进入计算基础设施市场,他也提到要保障 GPU 供应。
SK Telecom 说,它在 2026 年 11 月 9 日于首尔 COEX 举行的 NVIDIA AI Day Seoul 上,与 NVIDIA 以及韩国芯片公司 Rebellions 签署了谅解备忘录。目标是开发和测试一套同时运行 NVIDIA 图形处理器与 Rebellions 神经网络处理器的服务器系统。神经网络处理器,也叫 NPU,是为运行 AI 模型而设计的芯片。NVIDIA 英文新闻室把同一份宣布的日期写成 11 月 8 日,并补上了采购和监管都用得上的时间点。Rebellions 的 R200 系统预计 2028 年才能投入部署。当天的用语是主权 AI。稿子里的机制却是接口。韩国芯片被邀请接到 NVIDIA 的高速互联和机架设计上,而不是去替换它们。
[1][2]宣布了什么
三家公司说,Rebellions 将使用 NVIDIA NVLink Fusion,把它正在开发的下一代 Rebel R200 芯片接到 NVIDIA 平台上。NVLink 是 NVIDIA 的高速连接,让多块加速器能快速交换数据,从而像一套更大的系统那样工作。NVLink Fusion 是这一连接面向其他公司芯片的版本。服务器计划遵循 NVIDIA MGX,也就是机架如何摆放、供电和散热的标准做法,好让 GPU 机器和 NPU 机器共用同一套数据中心设计。
NVIDIA 在 2025 年 5 月的 Computex 上推出了 NVLink Fusion。当时的说法和今天一样。其他公司可以设计自己的加速器,同时仍插入 NVIDIA 的高速机架互联和 MGX 机械标准。韩国这份宣布,是给已有产品加上国家政策的框。它带来的是一款点名的新芯片和一家新的运营方,而不是一种新的互联。
合作有官方背景。NVIDIA 的新闻稿说,韩国科学与信息通信技术部支持此项协作。副总理兼科学部长 Bae Kyung-hoon 说,这一步让韩国开发的 NPU 可以通过 NVLink Fusion,与 NVIDIA 一起进入计算基础设施市场。他也表示,政府将推进与 NVIDIA 在物理 AI 以及保障 GPU 供应方面的合作。
NVIDIA 介绍 Rebellions 时,把 SK Telecom 列为这家创业公司的既有出资方之一。该说明里点名的现有旗舰芯片是 Rebel100。R200 是下一颗芯片,仍在开发中。SK Telecom 把文件称作谅解备忘录,也就是一份同意共事的签署文件,而不是已经完成的采购单。
NVIDIA 当天还发了一篇较短的博客,把读者指向这份新闻稿。点出产品、结构和日期的,是这份新闻稿,以及 SK Telecom 相对应的韩文声明。
[1][2]他们打算怎样分工
两份声明都描述了一种计划中的分工,对应模型回答问题时的两个阶段。预填充是第一阶段。模型读入用户的提问,并建立起内部状态。这一阶段的计算量很大,所以 GPU 很合适。解码是第二阶段。模型一次写出一小段文本,也就是一个词元,词元常常是一个词的一部分。解码的每一步都要从存储器里取出保存的权重和先前状态,所以存储器带宽往往比峰值运算更要紧。
三家公司说,他们会让 NVIDIA GPU 负责预填充,让 Rebel R200 负责解码,希望提高吞吐并改善功耗。NVIDIA 说,R200 正按低延迟、高能效推理来设计,对象也包括很大的混合专家模型。混合专家模型在每个词元上只启动一部分专门的子网络。这些是设计目标。两份稿件都没有公布芯片规格、测得的每秒词元数,也没有拿它和纯 GPU 方案做对比。
SK Telecom 说,它会把这套组合系统引入自己的 AI 数据中心,检查性能和稳定性,再考虑能否支撑实际服务。这些服务包括它自己的模型,例如 A.X K2,以及政府"AI for All"计划下的对公众服务,韩文称为 모두의 AI。
[1][2]为什么这是接入,不是退出
政府现在所说的主权 AI,听起来常常像是希望独自拥有全部环节,包括芯片、模型、数据和放置它们的建筑。这份协议按设计只拥有其中一部分。Rebellions 负责设计 NPU。SK Telecom 负责运营数据中心,并接上自己的部分模型和公共服务。科学部提供政策支持。把多块芯片连成一套系统的高速网络、机架蓝图,以及负责预填充的 GPU,仍然是 NVIDIA 的。
NVIDIA 创始人兼首席执行官黄仁勋把这种耦合说得很直白。"借助 NVLink Fusion,韩国的芯片公司可以把定制 ASIC 接到 NVIDIA 的 AI factory 平台上,让自己的处理器与 NVIDIA 的算力紧密耦合,一起运行 AI 工作负载。"这里的 ASIC 是为特定任务设计的芯片,也就是 Rebellions 正在做的定制加速器。"AI factory"是 NVIDIA 对自己那套端到端 AI 计算平台的叫法。
如果要问韩国模型能否在韩国数据中心里用韩国芯片运行,而且机架上没有外国加速器,那么这份宣布没有达到这个标准。如果要问韩国芯片公司能否卖进运营方已经知道如何供电和散热的机架,那么这份协议给出的路径要清楚得多。
[1][2]对这项合作更宽容的读法,以及缺口
更有利于这项合作的读法认为,自给自足并不是正确的检验标准。一颗无法与主流机架互联对话的国产 NPU,可能永远走不到量产。MGX 的存在,就是为了让数据中心在 GPU 系统和 NPU 系统之间复用占地、供电和散热。预填充和解码对硬件的需求不同,所以把它们分开,在芯片之间的连接足够快、软件又能让两边都忙起来的前提下,有可能省钱也省电。
稿件里没有测量最难的部分。在 GPU 和 NPU 之间搬运中间状态,可能增加延迟,把专用芯片的好处抵消掉。三家公司没有说明由哪一套推理服务软件来调度这种分工,也没有说明它将如何对待 SK Telecom 的模型。他们没有说明多少颗 R200 会共享一个 NVLink 域,R200 会用什么样的存储器,以及"高能效"用每词元功耗来看究竟是多少。SK Telecom 自己的用词很谨慎。它把文件写成一份用于开发、验证并评估商用可能的谅解备忘录。NVIDIA 把就绪时间写在 2028 年,所以这不是一张今天的照片里就能下单的机器。
[1][2]谁该在意,接下来看什么
韩国模型的开发者和 "AI for All" 算力的采购方,应当看 SK Telecom 是否真的把 GPU 加 R200 的系统装进机架,并公布它与纯 GPU 推理栈在同一批模型上的对比。芯片投资者应当看 R200 出现时,NVLink Fusion 是否成为必需的配套,那样 NVIDIA 就既是合作方,也是这条链路的必要供应商。把"主权"当作供应链控制标签的政策制定者应当注意到,这条路径仍然依赖 NVIDIA 的互联、机架合作方,以及回答每一个问题的第一阶段所用的 GPU。
[1][2]收束
未来六个月里,能够核对的是文件和原型,而不是国家独立。需要看到的是一份详细的 R200 规格、一套被点名的预填充-解码分工软件,以及 SK Telecom 是否拿出测试,报告每秒词元数和每词元能耗,并与纯 GPU 基线对比。在这些出现之前,更准确的说法是一份把韩国推理芯片接到 NVIDIA 互联上的谅解备忘录,目标时间是 2028 年。
[1][2]