
要点
- LFM3 把文本、视觉、音频、omni 与决策模型放到约 2B 参数共享骨干上,强调单卡微调与端侧部署。
- 架构为三混合(短卷积 + 滑窗注意力 + 全局注意力);LFM3-1.7B 以更少参数在代理任务上显著强于 LFM2.5-2.6B(WebArena-Verified 38.42 vs 3.02)。
- 视觉编码器自称算力约为前代 SigLIP2 路线的 1/3;VL 在 62 项基准均分从 57.6 升至 71.4,并给出机器人操控实时数字。
端侧多模态叙事常在两个极端摇摆:要么塞进一个巨大通用模型,要么为语音、视觉、工具调用各养一套系统。Liquid AI 的 LFM3 选择第三条路——用约 1.7B–2B 的共享骨干分出六个专用变体,并宣称都能在单卡上微调。
可证伪的主张是:在代理与端侧约束下,单位参数能力与可微调性,比继续堆通用参数更能决定产品形态。
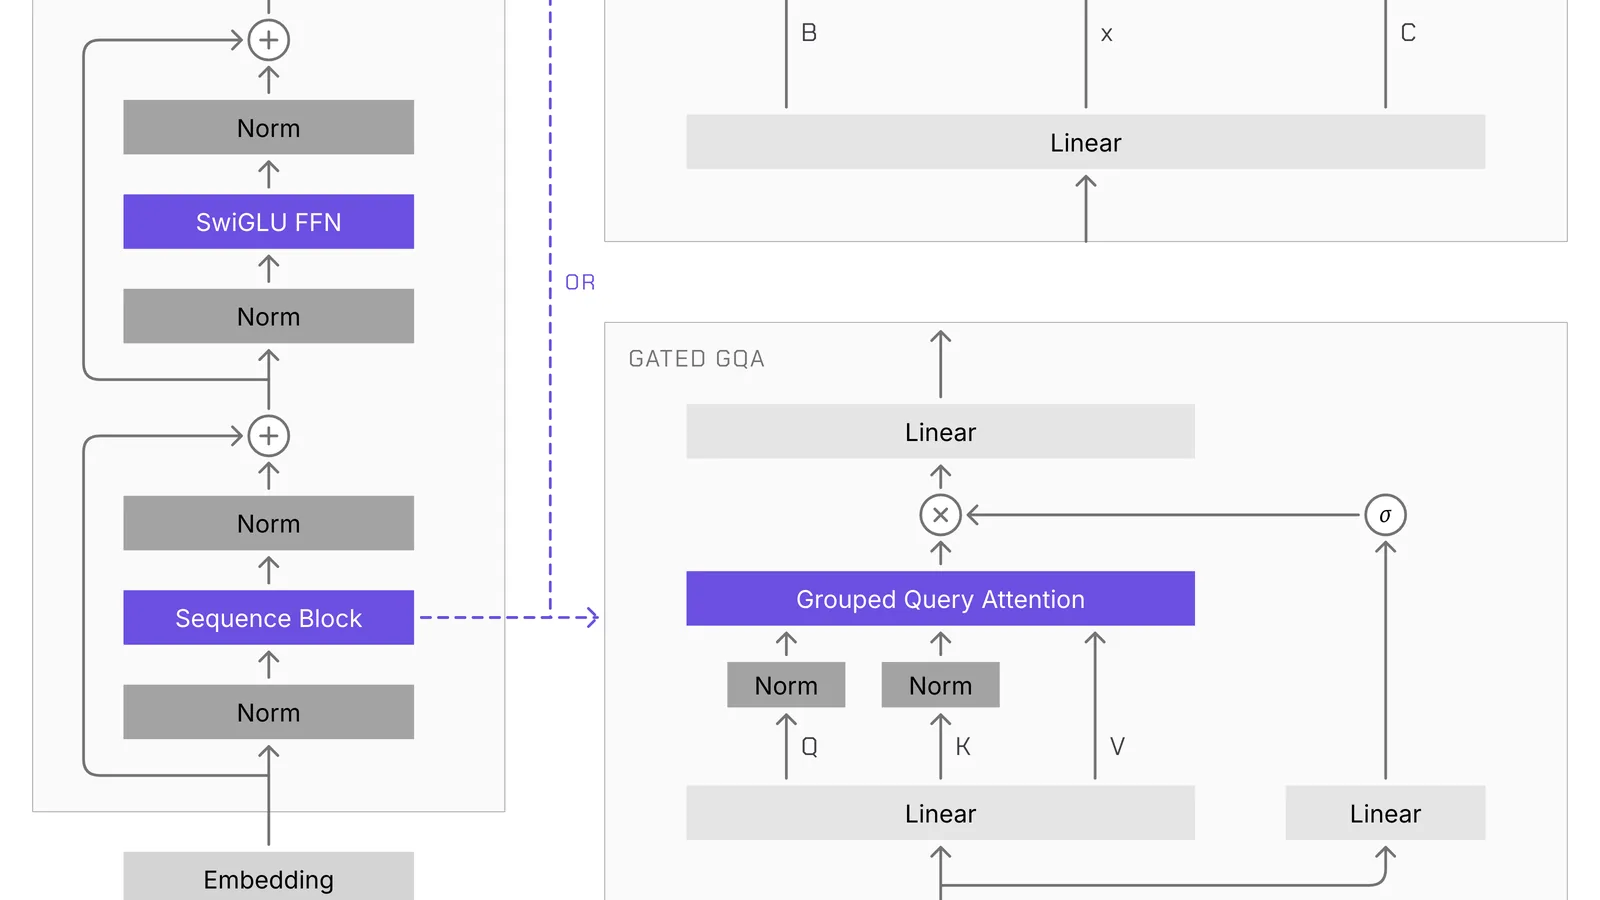
[1]骨干 LFM3-1.7B-Base:24 层,13 个门控短卷积(核 7)、5 个 256-token 滑窗注意力、6 个全局注意力;并引入 head-wise gated attention、部分 RoPE 与 sandwich norm。预训练约 22T token,末段 3.5T 提高代理轨迹与工具调用占比,上下文扩至 256K。
分支包括 LFM3-1.7B、LFM3-VL-2B(含视频)、LFM3-Audio-2B、首个 omni、以及一次前向给出校准概率的 d1 决策模型。权重开源,transformers 可跑。
[1]厂商报告:LFM3-1.7B 参数比 LFM2.5-2.6B 少约 35%,却在 WebArena-Verified 上 38.42 对 3.02,并声称在长任务上超过 Qwen3.5-9B。VL:62 项均分 71.4(前代 57.6),对标更大很多的 Gemma 4 12B。机器人示例:跨 15 具身联合训练的操作 VLA 在四套 LIBERO 上平均成功率 96.2%,Jetson AGX Orin TensorRT FP16 下动作块生成 <50ms。
音频侧给出 LiquidCodec 在 M4 Max 单线程约 87× 实时、首包延迟可低至 50ms 等工程数字。
[1]钢人反驳:WebArena 等代理分对提示与脚手架极度敏感;与 Qwen/Gemma 的对比可能未严格对齐解码与工具协议。机器人数字来自厂商选定套件,野外泛化未知。
缺独立复现、完整训练成本与失败模式;omni “击败至 10.7B 模型”需核对具体榜单设置。置信度:架构披露高,跨模型 SOTA 声明中等。
[1]若小骨干+专用头+单卡微调成为默认,端侧与私有化部署会从“蒸馏巨模型”转向“选模态分支再 SFT/GRPO”。应用商应重新评估是否还需要把 ASR、VLM、LLM、TTS 串成四段式流水线。
[1]关注第三方在相同 agent harness 下的复现,以及 d1 决策模型在真实工单/质检上的校准是否扛得住分布偏移。数字站得住,LFM3 会成为“专用小模型”路线的重要样板;站不住,它仍是一次完整的开源产品化练习。
[1]