
要点
- MIT CSAIL 博文(2026-11-02):前沿模型可在约束工具链下直接读、改、写小到中等规模权重;日志与 Hugging Face 产物已公开。
- Qwen3.5-0.8B:编辑约 0.016% 权重后,MATH-500 从 7.9% 升至 48.1%,IFEval 约升至 3 倍;作者称主因是切断推理循环,而非新学数学。
- 对照:几乎不循环的 Gemma 3 270M 上同类编辑未能稳定抬高 MATH-500。可证伪点是「受限 harness 下的读写能力」,不是「LLM 取代训练」。
MIT CSAIL 的 Takehi、Teoh、Zhang、Khattab 在 2026 年 11 月 2 日的博文里提出「权重空间编程」:不把大模型当成只写训练脚本的助手,而是让它直接读权重、改权重,有时甚至从零写出可跑的小网络。
可证伪读法很窄。若在公开日志与复现产物里,前沿模型无法在约定 harness(文本权重、Python 沙箱、有限次前向)下稳定完成小到中等张量的读与写,或「修好障碍」被误读成「新增能力」,则应下调这篇博文的外推权重。博文自己也用 Gemma 数学编辑失败说明:去掉障碍不等于补上能力。
[1]硬事实(作者博文与公开日志,2026-11-02):
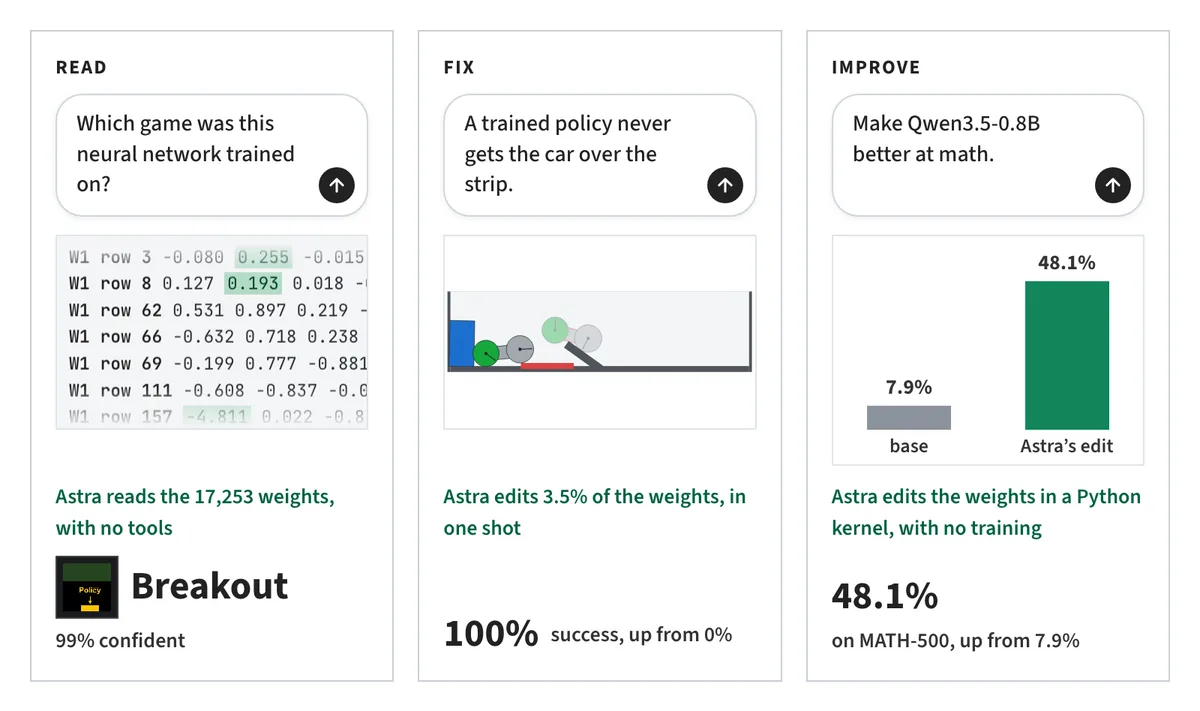
- 读权重:同结构 PPO 策略(约 1.7 万权重)被问「训练了哪款游戏」时,Astra 能点名 Breakout 等;扩散模型可从权重推断目标形状轮廓;去掉输入输出层后,约 720 万参数字符级 Transformer 的中间块仍可被用来判断训练语料是 Python、罗马字日语还是英语,并标出复制头,与实测一致。
- 改权重:Kinetix 上卡住斜坡的车控策略,一次性改约 3.5% 权重后,在 1,024 局中全部成功。
- 从零写权重:MinAtar 三款游戏中,零训练、零环境试玩写出的网络,分数超过训练 1 亿步的 PPO;对训练 5 亿步的 PPO,Breakout 分数约为其 20 倍量级,Asterix 接近,Seaquest 约六成。
- 更大尺度:约 148 万参数的 9×9 围棋网,在 Python 沙箱与有限前向预算下可写出可对弈网络;50 次前向预算时,能赢过同规模、训练约 2,000 万盘的 PPO。
- 语言模型:Qwen3.5-0.8B 在 50 次前向预算下,作者把循环痕迹定位到第 15、19 层 MLP 的某个方向,对每层 64 个输出列做减法,共改 131,072 个权重(约 0.016%)。MATH-500 7.9%→48.1%,GSM8K 13.8%→67.1%,IFEval 21.0%→62.3%;触达 token 上限的比例从 93% 降到约 33%。Gemma 3 270M 几乎不循环,同类小编辑未能把 MATH-500 抬过约 1 个百分点的噪声带。
证据强度:一手研究博文 + 完整交互日志仓库 + 编辑后的 Qwen 权重在 Hugging Face。数字来自作者给定采样设置下的评测表,不是第三方盲测。
机制上,作者把成功案例写成「用自然语言规格在权重里实现程序」:Breakout 里先算球落点再移板;围棋里按气与危险群分层编码。失败案例同样具体:谄媚检测在只看权重时失败,放开注意力模式后才稳定分开;Gemma 的错是普通推理错误,没有单一可关掉的组件。
钢人论证:若 frontier 模型真能在不写训练循环的前提下,对中小网络做定向手术,那么解释性与优化会多一条路径。审计可不先跑基准,修复可不先重训全量数据。公开日志降低了「演示不可复核」的指控门槛。
[1][2]最强钢人:Qwen 结果说明,障碍型失败(死循环)可能被极小比例权重编辑解除,并外溢到指令遵循;这与「只刷数学微调」不是同一类干预。
钢人风险:多数高光发生在权重可进上下文、或沙箱加有限前向前的受限设置;博文也承认上下文与 harness 效率仍是瓶颈。把「去掉循环」读成「模型学会了数学」会被 Gemma 对照打脸。Astra 是作者实验中的前沿模型名,读者不应外推到任意开源 checkpoint。尚未看到独立实验室按同一协议复现全表。
[1]对解释性研究者,观察点是:无前向、仅权重的审计能否在更大开源模型上重复「复制头定位」这类命中。对训练与安全团队,则是定向编辑是否可被滥用为植入后门或擦除对齐,以及 harness 权限(能否写训练循环、能否无限前向)如何划界。对产品读者,六个月内可核对的是日志复现率与第三方是否跑通 Qwen 编辑表,而不是标题里的「火花」修辞。
[1]短期不要把这篇博文读成「训练已被大模型取代」。可证伪焦点应放在:在公开 harness 与日志约束下,模型能否稳定读写小到中等权重;以及「移除障碍」与「增加能力」是否被分开报告。若复现撑住 Qwen 表且 Gemma 失败仍在,权重空间编程更像一种受限但真实的新操作面;若只剩演示片段,它仍停留在研究火花。
【No.2】
[1]