
要点
- Amazon Science 与 Booking.com:知识蒸馏(KD)加 Medusa-2,使 1.1B TinyLlama 学生在质量上逼近 70B Llama-3.1 教师,推理快 10–20 倍。
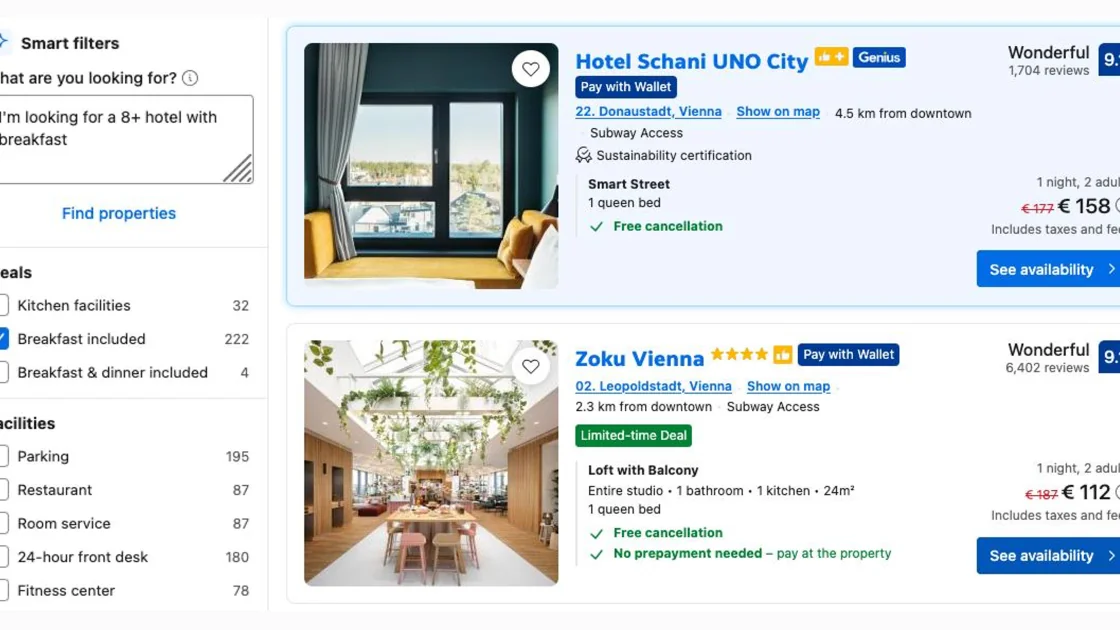
- Smart Filters:99% 查询响应快约 15 倍;单 KD 已弥合超 90% 师生质量差距并约 6× 加速,Medusa 头再加 2–3.6×。
- AI Trip Planner 相对 GPT-3.5 用户参与 +2.9%;住宿描述「有帮助」评分 +1.4%,成本低于对照模型;ACL Industry Track 最佳论文。
Amazon Science 在 2026年10月29日撰文,总结与 Booking.com 合作的一套推理加速管线:知识蒸馏把大教师压成小学生,Medusa 把逐 token 串行解码变成多 token 并行。三个产品面——对话式行程规划、自然语言转结构化筛选、海量房源描述生成——分别卡在延迟或成本上。
主张很窄:面向旅行的实时体验,瓶颈是「过大模型 + 串行解码」的组合;只做蒸馏或只加 Medusa 都不够,二者同训才能在质量近教师的同时拿到数量级加速。若线上只是基准好看、或任一技术单独已够,主张过强。
[1]方法上先微调 70B 级教师,再在人工标注与教师伪标混合语料上训练带 Medusa 头的 1.1B TinyLlama 学生。Medusa-1 先冻主干再训头;Medusa-2 单阶段同训,文中称速度相当而工程更简单,故生产更倾向 Medusa-2。GPU 擅长并行,多头预测额外开销有限,文献常见 2–4× 加速且质量可保持。
实验递进:仅任务微调的小模型已优于少样本 GPT-4o,但仍落后教师;KD 弥合超 90% 差距并约 6× 加速;再加 Medusa 头 2–3.6×。合并后相对教师 10–20×,视用例而定。
[1]产品数字:Smart Filters 对 99% 查询约 15×;Trip Planner 相对 GPT-3.5 参与度 +2.9%;描述生成「有帮助」+1.4%,成本低于其他模型(文称不到 GPT-4 三分之一量级叙述见于成本有效性讨论)。工作获 ACL Industry Track 最佳论文,增加同行可见性,但不等同于外部复现。
证据边界:参与度与「有帮助」是平台内指标;教师为 Llama-3.1-70B,对照含 GPT-3.5/4 叙述,跨模型代际需谨慎。未公开完整延迟分布与失败案例。置信度:方法描述与加速倍数高;业务指标外推中等。
[1]钢人:旅行查询分布偏短、结构化输出多,Medusa 的并行解码收益可能高于开放域长文;换成长旅行攻略生成,头数与验收标准要重做。另一钢人:持续用 GPT-4o 级 API + 缓存可能在工程小时上更便宜,直到 QPS 与尾延迟强制自托管。文中承认百毫秒级延迟会损失客户与收入——这是商业前提,不是普适物理定律。
[1]对 OTA 与任何高 QPS 对话产品,这篇把优化菜单从「换更大模型」改成「教师质量如何机械地进学生,同时把串行解码打掉」。对推理基础设施团队,Medusa-2 与 KD 同管线意味着模型目录里每个任务一个紧凑检查点,而不是共享一个万能 70B。对评测桌,应同时要质量差距闭合率与分位延迟,而不是只报平均 tokens/s。
[1]未来六个月看:Booking.com 类指标能否在其他垂直复现;Medusa-2 在工具调用/JSON 约束解码下是否仍稳定;以及只上 KD 或只上投机解码的对照是否公开。若双技术栈在 99 分位延迟与质量上同时必要,主张成立;若单一技术已达产品 SLO,需改写。
[1]