
要点
- Mission Control 2.5 把原先仅服务 Slurm/HPC 的自主恢复引擎,接到由 NVIDIA Run:ai 调度的 Kubernetes 负载。
- 可移植模型是三层环:Run:ai 放置、自主作业恢复(按作业上下文分类)、自主硬件恢复(隔离与诊断)。
- 硬件故障时,作业重启与节点隔离并行;瞬时软件故障则重试作业而不收缩调度池。
NVIDIA 开发者博客谈 Mission Control 2.5,用运维语言重述 AI 工厂的老问题:跨节点训练要跑数天,不能每次 GPU 报 ECC、worker 挂死或 NCCL 超时都靠人工分诊。产品主张并不是「自主」这个词新鲜——而是原先已在 Slurm 侧存在的恢复引擎,现在经 Run:ai 接到了 Kubernetes。
这个区分很重要。营销可以卖自愈口号;平台团队买的是把「作业下一步该做什么」和「硬件需要什么」拆开的控制环。两者黏在一起时,软件毛刺都像坏节点,坏节点又会拖住作业等根因。
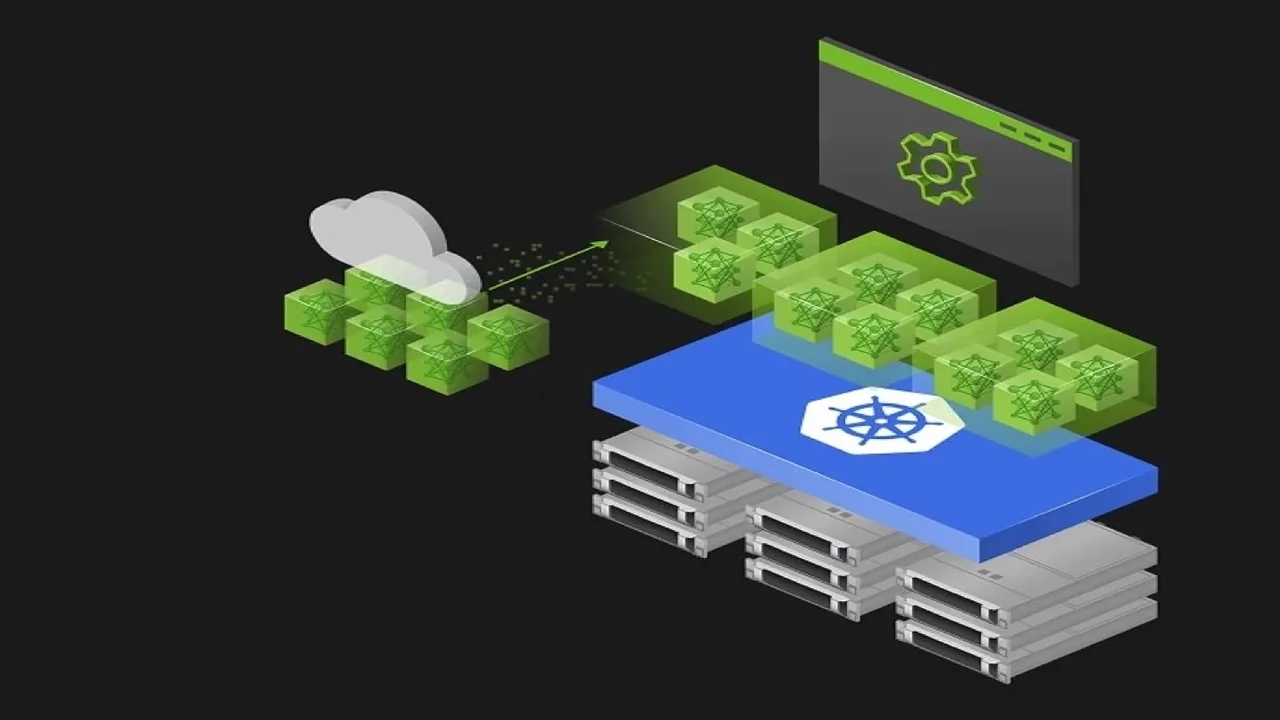
[1]自主恢复引擎被描述为嵌在三角色环里的两项服务。NVIDIA Run:ai 把 Kubernetes AI 作业放到可用容量上。自主作业恢复服务监视运行中作业、追踪拓扑与失败历史,并分类下一步该重启、重试、重新入队还是改调度。自主硬件恢复服务监视节点与 GPU,必要时把异常踢出调度,并跑诊断,以免故障容量继续传染新作业。
可移植性是架构赌注:作业恢复不必修硅片;硬件恢复不必懂每一种训练框架;调度器不必等完整事后分析就能把负载导向就绪容量。同一套分离,也是叙事能从 Slurm allocation 走到 Kubernetes pod 的原因。
[1]文章用场景论证,而不是第三方 MTTR 数字。训练中遇硬件故障时,恢复分叉:作业恢复抓住上下文并挪动负载,硬件恢复同时封锁可疑节点并启动诊断——作业不等 RCA,下一份作业也不会继承坏 GPU。瞬时软件故障时,作业恢复依据失败历史按调度策略重试,而不隔离健康节点。早期劣化——硬故障前反复出现健康告警——硬件恢复可在训练作业落上之前把节点移出资格。
这是连贯的运维模型。公开内容仍是 NVIDIA 自家走读:没有独立集群研究、没有前后 MTTR、也没有与原生 Kubernetes restartPolicy 加 NVSentinel 式 cordon/drain 的对照。读者应把它当学说文档,而非基准测试。
对 Mission Control 2.5 的强反对意见是:Kubernetes 本就会重启失败 pod,GPU operator 本就会 drain 不健康节点。若分类不准,两边最糟的情况会叠在一起:真硬件故障上反复重试,或应用 bug 上不必要地收缩池子。2.5 的专栏价值因此不在「发明重启」——而在坚持瞬时软件与硬件劣化是两类信号,不能共用一条钝修复路径。
文中同样薄弱的是:分类器误判频率、Run:ai 表达恢复与 Slurm 在边界情形上的差异,以及 beta「AI 网络异常检测」如何切入作业/硬件两条路径。发行说明还列了 Keycloak 认证体验、K8s 加固与 Vera Rubin NVL72 早期访问——是包装,不是论点。
[1]对同时跑着Slurm与 Kubernetes 机群的平台团队,近期决策是统一的恢复词汇——隔离、标注、诊断、就绪才回池——而不是偏好「自主」这个品牌词。对使用者,作业应在已用的调度器里重启或重新入队,同时用上下文避免在待修基础设施上反复失败。
NVIDIA 强调的业务收益是利用率:少在含糊中空转,多出有效加速器小时。方向对 AI 工厂成立;此处仍未量化。
[1]未来半年要看的是:生产侧是否写出在 Run:ai 下的误隔离率与作业恢复成功率,而不是只剩架构图。若 Mission Control 的分类器能在规模上干净切开软件与硅片,自愈就会成为可移植的运维模型;若不能,「Kubernetes 自主恢复」会塌回运维已有的工具,只是多了一层更厚的控制面。
[1]