
要点
- 2026 年 11 月 10 日,Amazon Science 发表了由 Chris (Luyang) Kong 署名的博客,介绍 Mitra-v2,并同时指向 2026 年 9 月 3 日发布于 arXiv、编号 2609.04540 的技术报告《Mitra-v2 Technical Report》。两处不一致时,我们以报告为准。
- Mitra-v2 是一个表格基础模型:一个预训练好的模型读取此前未见过的表中带标签的行,并预测其余行。它只在合成表上预训练,不使用真实数据,尤其不使用客户数据。12 层 Transformer 架构与 v1 相同。权重和代码以 Apache-2.0 许可证在 Hugging Face 上发布。
- TabArena 是由独立学术团队维护的公开基准,包含 51 个真实世界数据集,并在固定的一小时预算下,用对战胜场计算 Elo 来给方法排名。在报告冻结的榜单上,Mitra-v2 得到 1,774.6 Elo,处在单模型前列,与 TabFM 在统计上持平。它在双方都能原生跑完的 33 个数据集中,有 32 个误差低于 v1,并在一小时内完成全部 51 个数据集。
- 默认情况下,模型会在每张新表上做一次短暂的自动微调,并对八个副本取平均,这种方法称为 bagging,因此它并不是零样本系统。博客称,微调后的 Mitra-v2 在 ScoringBench 上排第一。ScoringBench 是面向回归模型的公开基准,考查的是预测一个可能结果的区间,而不是单个数字。在约 300 个数据集的 TALENT 套件上,报告把它排在超过 10 类的分类任务第一。
- Amazon Connect Customer 正在把 Mitra-v2 用于结构化业务和客户体验数据上的预测。这是一项采用声明,不是经过测量的生产收益。梯度提升树仍是许多表格问题的默认选择,自动微调加上八副本 bagging 在部署时也是真实的计算成本。
2026 年 11 月 10 日,Amazon Science 发表了由 Chris (Luyang) Kong 署名的博客,介绍 Mitra-v2,这是一个只在合成表上预训练的表格基础模型。配套技术报告《Mitra-v2 Technical Report》于 2026 年 9 月 3 日发布在 arXiv 上。两处不一致时,我们以报告为准。可核对的主张,并不是一个模型从此取代了每张业务表上的每一次训练。它是:Mitra-v2 之所以处在 TabArena 单模型前列,是因为扩大了合成预训练表的组合和规模,而不是因为网络更深;而且这一结果仍然依赖于一次短暂的自动微调,以及对模型八个副本的预测取平均。
[1][2]Mitra-v2 实际是什么
企业运转所依赖的数据,很多都在表格里。通常的工具,包括梯度提升决策树,会为单张表拟合出一个模型。换一张表,就要再跑一次训练。表格基础模型的设想,是打断这个循环:一个预训练好的模型,读取它未见过的表中带标签的行,并预测未标注的行。
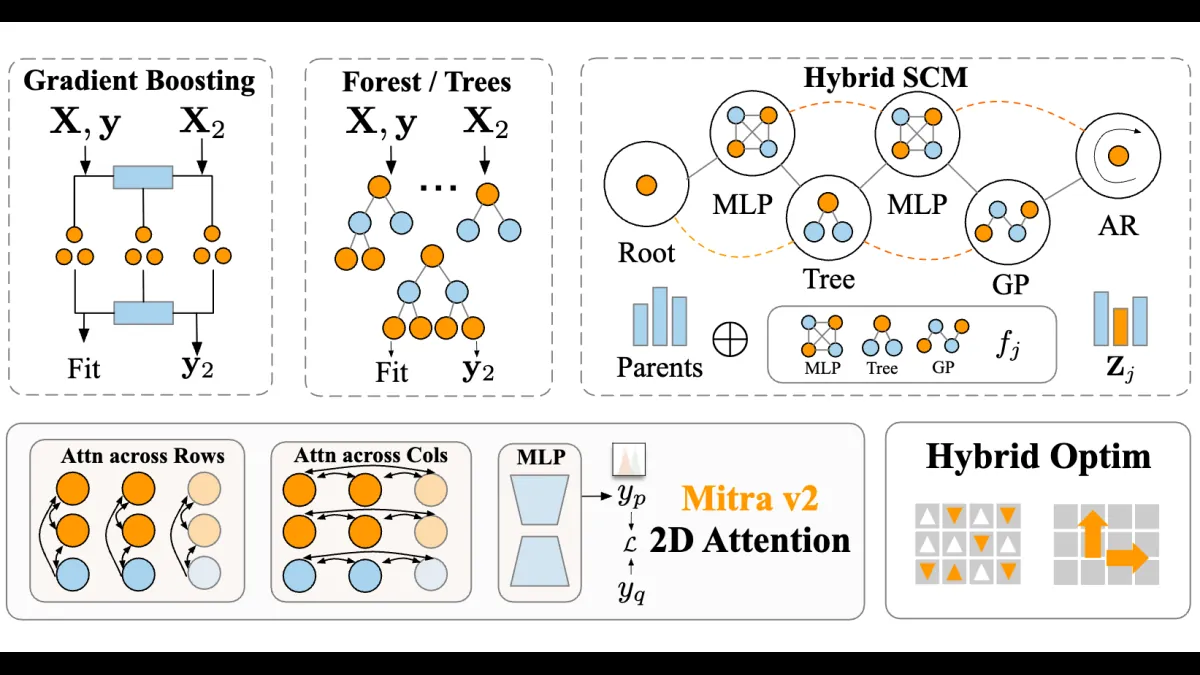
Mitra-v2 是 Amazon 这一设想的第二代,同时覆盖分类和回归。博客称,去年的 Mitra 在中小表上表现不错,但在大表、宽表和类别很多的问题上空间不够。新模型完全在合成表上预训练,不使用真实数据,尤其不使用客户数据。架构仍是与 v1 相同的 12 层 Transformer,既在行之间做注意力,也在列之间做注意力。报告称,发布的权重约有 7,700 万参数。权重和微调代码以 Apache-2.0 许可证在 Hugging Face 上发布。
"基础模型"这个标签需要一个限定。默认情况下,Mitra-v2 会在每张新表上做一次短暂的自动微调,并生成八个副本,对其预测取平均,这种方法称为 bagging。博客写得很明确:它并不完全是零样本模型。这里的零样本,指的是对一张新表只做一次前向计算,不再额外拟合。Amazon Connect Customer 领导了这项工作。博客把它描述为面向核心业务功能的智能体系统,并称其正在把 Mitra-v2 用于结构化业务和客户体验数据上的预测。这是一项采用声明,不是经过测量的生产收益。
[1][2]TabArena 和 ScoringBench 的结果
TabArena 是包含 51 个真实世界数据集的公开基准,由独立学术团队维护。它在固定的一小时预算下,用对战胜场计算 Elo 来给方法排名。Elo 是国际象棋使用的等级分系统。博客称 Mitra-v2 领跑单模型。报告写得更精确,我们采用报告中的数字,这些数字钉在 2026 年 9 月 3 日的一小时榜单上。
在全部 51 个数据集的总榜上,Mitra-v2 得到 1,774.6 Elo,处在单模型前列。报告把这读成与 TabFM 在统计上持平,点估计大约高出 1 个 Elo,比 EXAONE Tabular 大约高出 25 个 Elo,比 TabPFN-3 大约高出 137 个 Elo。由于领先方法的 95% 自助法区间相互重叠,作者认为接近的分差应读成平局。一个四小时的 AutoGluon AutoML 组合在 Elo 上排在 Mitra-v2 前面,但那套系统会在每个数据集上派出许多模型,并不是在一小时限额内运行的单个冻结模型。报告还指出,TabFM 的榜单产物里包含超出一小时预算的拟合。
与 Mitra-v1 的比较更清楚。只看 v1 真正跑完、而不是超时后被补上分数的数据集,v2 在全部 26 个分类数据集,以及 7 个回归数据集中的 6 个上,平均误差更低。这就是博客所说的 32 比 33。Mitra-v2 原生跑完了全部 51 个数据集。Mitra-v1 在 38 个分类数据集中的 12 个、13 个回归数据集中的 6 个上被补上了分数,超过了整张榜的三分之一,因为它没能在一小时内完成。
在 ScoringBench 上,博客称微调后的 Mitra-v2 排第一。ScoringBench 是面向回归模型的公开基准,考查的是预测一个可能结果的区间,而不是单个数字。我们没有在技术报告里找到 ScoringBench 的结果,因此这一排名是博客中的主张。在独立的 TALENT 套件上,约有 300 个数据集,报告把 Mitra-v2 列在领先方法之中,并在超过 10 类的分类任务上排第一,这一分项包含 12 个数据集,尽管预训练最多只用到 10 类。TabFM 无法运行这些任务。
[1][2]变的是合成先验,不是更深的网络
设计上的论点是:网络不必加深。报告称,Mitra-v2 保留了 v1 的 12 层主干。TabFM 有 16 亿参数,大约是它的 21 倍。改变的是预训练的组合。博客称,v2 见到的表,行数是 v1 的 10 倍,列数大约是 3 倍。报告给出的新范围是:预训练时用作例子的表有 160 到 5,120 行,特征有 1 到 50 个。
作者还增加了一类新的合成表。最初的 Mitra 用结构因果模型生成的表来训练,也就是列与列之间因果关系的图,再加上基于树的模型。Mitra-v2 新的混合 SCM 先验,会在同一张因果图里组合不同机制:每一段关系可以是一个小神经网络、一棵决策树、从高斯过程抽出的平滑函数,或一个随时间变化的自回归过程。经典的 SCM、梯度提升和森林生成器仍留在组合里。作者称,新的混合优化器让训练在这一更宽的范围内保持稳定。对于非常宽的表,只用训练集做截断奇异值分解,把列数降到可容纳的预算内。输出层只有 10 个类别节点,因此类别更多的任务会被拆成一棵较浅的树,变成若干个较小的分类问题。
报告对实验未能分离的部分是坦白的。作者同时改了上下文长度、特征范围、先验组合、优化器、分布式训练和检查点,而现有实验并没有把每一项的贡献分开。"不是更深的网络"站得住。如果说新的合成组合单独造成了这次提升,则还不能成立。
[1][2]并不是零样本,以及其他限定
榜单上的默认系统,是 AutoGluon 带 bagging 的微调方案,而不是一次前向计算。报告描述的默认设置大约是 50 步微调,在一小时限额下,每个 bagging 子模型最多 250 秒,并做八折 bagging。作者警告,这一成本远高于零样本、只做前向计算的基础模型,也不应把该系统说成零样本。Elo 还是相对分数:增加或去掉方法,每个评分都可能改变,未来的公开排名也可能不同于 2026 年 9 月 3 日的冻结结果。在分类上,报告已经把 Mitra-v2、TabFM 和 EXAONE Tabular 读成统计上的平局。Connect Customer 的部署,不应被读成收益证据。博客描述的是预定用途,而不是生产环境里前后对比的指标。
[1][2]更公允的读法
更公允的读法,要从榜单说起,而不是从"基础模型"这句口号说起。若那份冻结快照仍能描述公开榜,那么在 33 个重叠数据集中的 32 个上胜过 v1,并在独立托管的一小时预算内完成全部 51 个 TabArena 数据集,仍然是一项过硬的结果。若平局成立,用一个 7,700 万参数、12 层的网络跟上一个大得多的模型,才是设计上的发现:扩大预训练分布,不必加深网络,也可以推动分数。
诚实的界限就在这项发现旁边。头条系统是经过微调并做了 bagging 的,因此这里的"基础模型"并不意味着对一张新表可以免费、立刻给出猜测。单模型的顶端是统计上的平局,不是干净的拉开。梯度提升树,以及四小时的 AutoML 组合,对许多表格来说仍是更稳妥的默认选择。报告指出,Mitra-v2 在约 51 个数据集中的 9 个上排第一,比那些组合更常拿到第一,这是另一种剖面,并不是淘汰树模型的理由。
[1][2]谁该在意,接下来看什么
今天仍在为每张新的业务表训练一个新模型的人应当关心,那些会读到"表格基础模型已经让那次训练变得不再必要"这类说法的读者也应当关心。分类器、回归器和微调代码已在 Hugging Face 上开放。未来六个月里,真正的检验是:当比较池变动之后,后续的 TabArena 修订是否仍把 Mitra-v2 放在单模型前列;独立用户是否认为默认的微调加 bagging 方案,在自己的表上值得这笔计算;以及 Amazon Connect Customer 的采用之后,是否出现任何公开、经过测量的收益,而不是停留在部署声明上。
[1][2]收束
Mitra-v2 表明,表格基础模型可以通过扩大合成预训练,在不必加深网络的情况下,在一块独立榜单上往前走。它并没有表明,"基础模型"这个标签现在就意味着对一张新表可以免费、立刻给出预测。接下来的榜单修订,以及第一批经过测量的部署,将说明这一区分是否仍然成立。
[1][2]