
要点
- Minerva 把 GPU、Spectrum-X/NVLink、存储、NCCL、调度器与作业映射进动态知识图谱,让运维从共享因果上下文起步,而不是各自清点。
- 灰故障——同侪更热、仅在负载下的 NVMe 劣化、pause-frame 风暴——常常从不越过绝对值阈值;同侪对比与稀有日志 NLP 才是检测主张。
- NVIDIA 引用内部案例:约 40 万条 NVLink 接口中的一条数分钟定位;SuperNIC APEI 在作业落地前捕获;NVMe 掉电故障约 5530 作业小时;81 条告警折叠为一次 pause-frame 事件(约 54 集群小时)。
AI 工厂把数十万 GPU、Spectrum-X 网络、NVLink 域与持续数周的训练作业当成一套生产系统来跑——即便网络、计算与 ML 团队各自守着遥测。同步训练里,作业以最慢 rank 的节奏前进。比同侪略热几度的 GPU、只在持续负载下劣化的 NVMe,或交换机 pause-frame 风暴,可以在从不越过静态阈值的情况下浪费健康算力。
NVIDIA 开发者博客谈 Minerva,把这个缺口写成真正的产出问题:仪表盘孤岛各自看到准确局部信号,却仍错过依赖链。产品主张是围绕工厂拓扑与负载构建的 AIOps 平台——不是又一套阈值包。
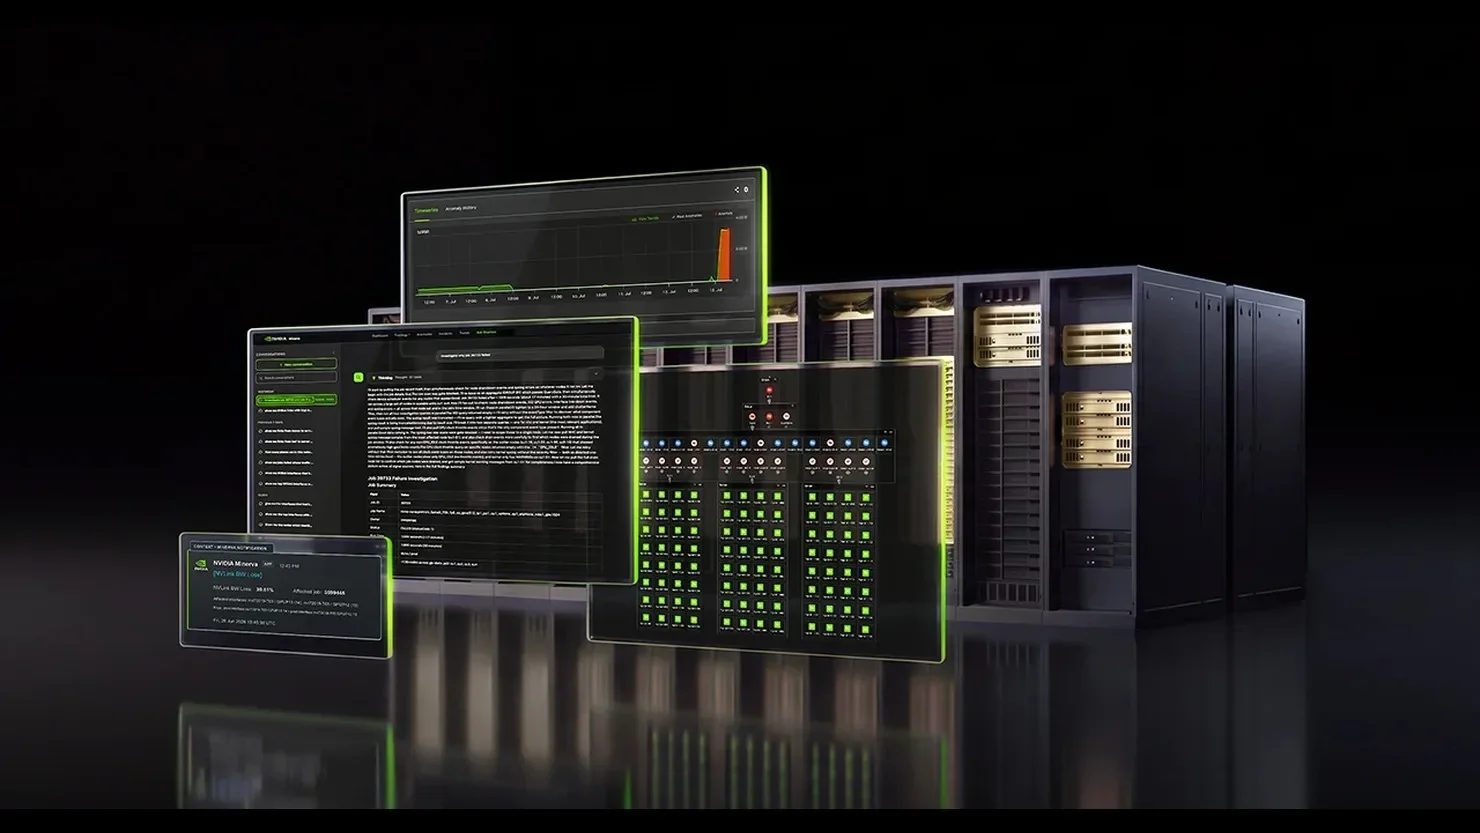
[1]Minerva 从 GPU、Spectrum-X 与 NVLink 交换机、SuperNIC、DPU、存储、NCCL、调度器与作业摄取指标、日志与拓扑。自动发现构建随作业启停、节点排空与回池而更新的知识图谱。从异常接口可走到节点、织物路径与作业放置;从作业 ID 可走 GPU→主机→NIC→交换机→日志。
检测混合监督签名、无监督同侪对比与多变量模型(温度、功耗、时钟、利用率、负载状态)。日志用 NLP 异常检测捕捉未见模式。拓扑感知关联再把依赖症状折叠成一条附带拓扑与负载的事件。原生智能体 Sherlock 与 MCP 服务器把同一套现场证据以对话或外部工具方式暴露。
[1]文中最硬的证据是 NVIDIA 自家工厂案例。SRE 看到 step time 变差却无硬告警,用 Minerva 在约 40 万条 NVLink 接口中定位一条并排空受影响节点,避免慢化扩散。一条稀有的 SuperNIC PCIe/APEI 内核行——对静态规则过稀——触发 Slack 修复指引,在客户作业落地前移出节点。全栈作业 RCA 把掉队追溯到无法从低功耗唤醒的 NVMe,估计挽回约 5530 作业运行小时。页故障导致的交换机重启引发 RX pause frame 与多达 81 条嘈杂事件;关联把它们合成一条事件,估计节省约 54 集群小时。
这些是厂商走读与内部估算,不是第三方 MTTR 研究。它们仍给出连贯学说:从作业或链路起步,而不是从八十个仪表盘起步。
[1]对 Minerva 的强反对意见是:成熟 AIOps 栈本就会做拓扑图、同侪基线与事件聚类。若价值只是在 NVIDIA 中心遥测上更漂亮的关联,拥有强开源可观测性的运维收益可能小于文中暗示——尤其当 DSX OS 开源部分采集与健康组件之后。
同样薄弱的是:无监督模型误报率、Sherlock 建议错误频率、Spectrum-X/NVLink 参考路径之外的多厂商织物覆盖,以及「显著降低通知事件」在支持场景外能否站住。应把案例当灰故障可救回的存在证明,而非可迁移 SLO。
[1]对平台团队,近期问题是调查是否从作业与织物的共享因果图起步,还是在网络与计算之间工单乒乓。对 ML 负责人,真正单位是有效 GPU 小时与 token 产出——不是 GPU 是否仍显示「up」。
NVIDIA 把 Minerva 放在与 DSX OS 收敛的路径上,采集器计划成为开放模块。若客户想要参考架构遥测、又不想把分析永久锁在单一专有控制台,这一点重要。
[1]未来半年要看的是公开的误报率、定位时间分布,以及 NVIDIA 自有工厂之外的部署。若同侪对比加拓扑折叠能在阈值触发前稳定抓住灰故障,AI 工厂监控就得把仪表盘孤岛本身当成故障模式。若不能,Minerva 仍是强的 NVIDIA 栈 AIOps 叙事,行业却还会继续争论告警疲劳。
[1]