
要点
- 论文测量开权模型在更长上下文下的解码成本:256K 相对 16K,GLM 约 3.6×、Kimi 约 5.6×、Qwen 约 7×(按峰值吞吐与 H100 点价折算)。
- 对长程任务,频繁压缩(如 16K/12K 等档)下 Opus 4.5 / GPT 5.6 Sol 多数配置相对满历史基线损失不超过约 2 个百分点;长输入任务配合选择性读取时常持平或更好。
- 可证伪点是各基准在公开压缩阈值下的准确率与峰值上下文;不是把标题读成「长上下文研究应停止」。
NVIDIA 研究作者 Peter Belcak 等在 arXiv:2611.05306 发布《You don't need long context》(2026-11-03)。论文链接指向 Project Moonshot / Local Frontier Intelligence 实验室页。核心张力写得很直:零售按每百万 token 一口价,但服务侧后段 token 更贵、更慢、更吃显存。
新闻核不是「长上下文是骗局」。可证伪读法应盯三件事:把服务上下文从 256K 收到 16K,成本倍数是否落在文中 3.6-7× 区间;在 SWE-bench、Terminal-Bench、LongBench v2 等公开设定上,压缩后准确率是否大致守住满历史/满输入基线;以及「每步只保留一个动作的上下文」时,性能是否如 Table 2 所示不崩。
[1]硬事实(论文引言、结果与 Table 2):
- 成本图:在已有 KV cache 上生成 1M 输出 token 的美元成本随窗口增大;256K 相对 16K,GLM 5.2 约 3.6×、Kimi K2.6 约 5.6×、Qwen 3 Coder Next 约 7×(Nebius H100 点价 $3.85/GPU-hour,2026-09 测量设定)。
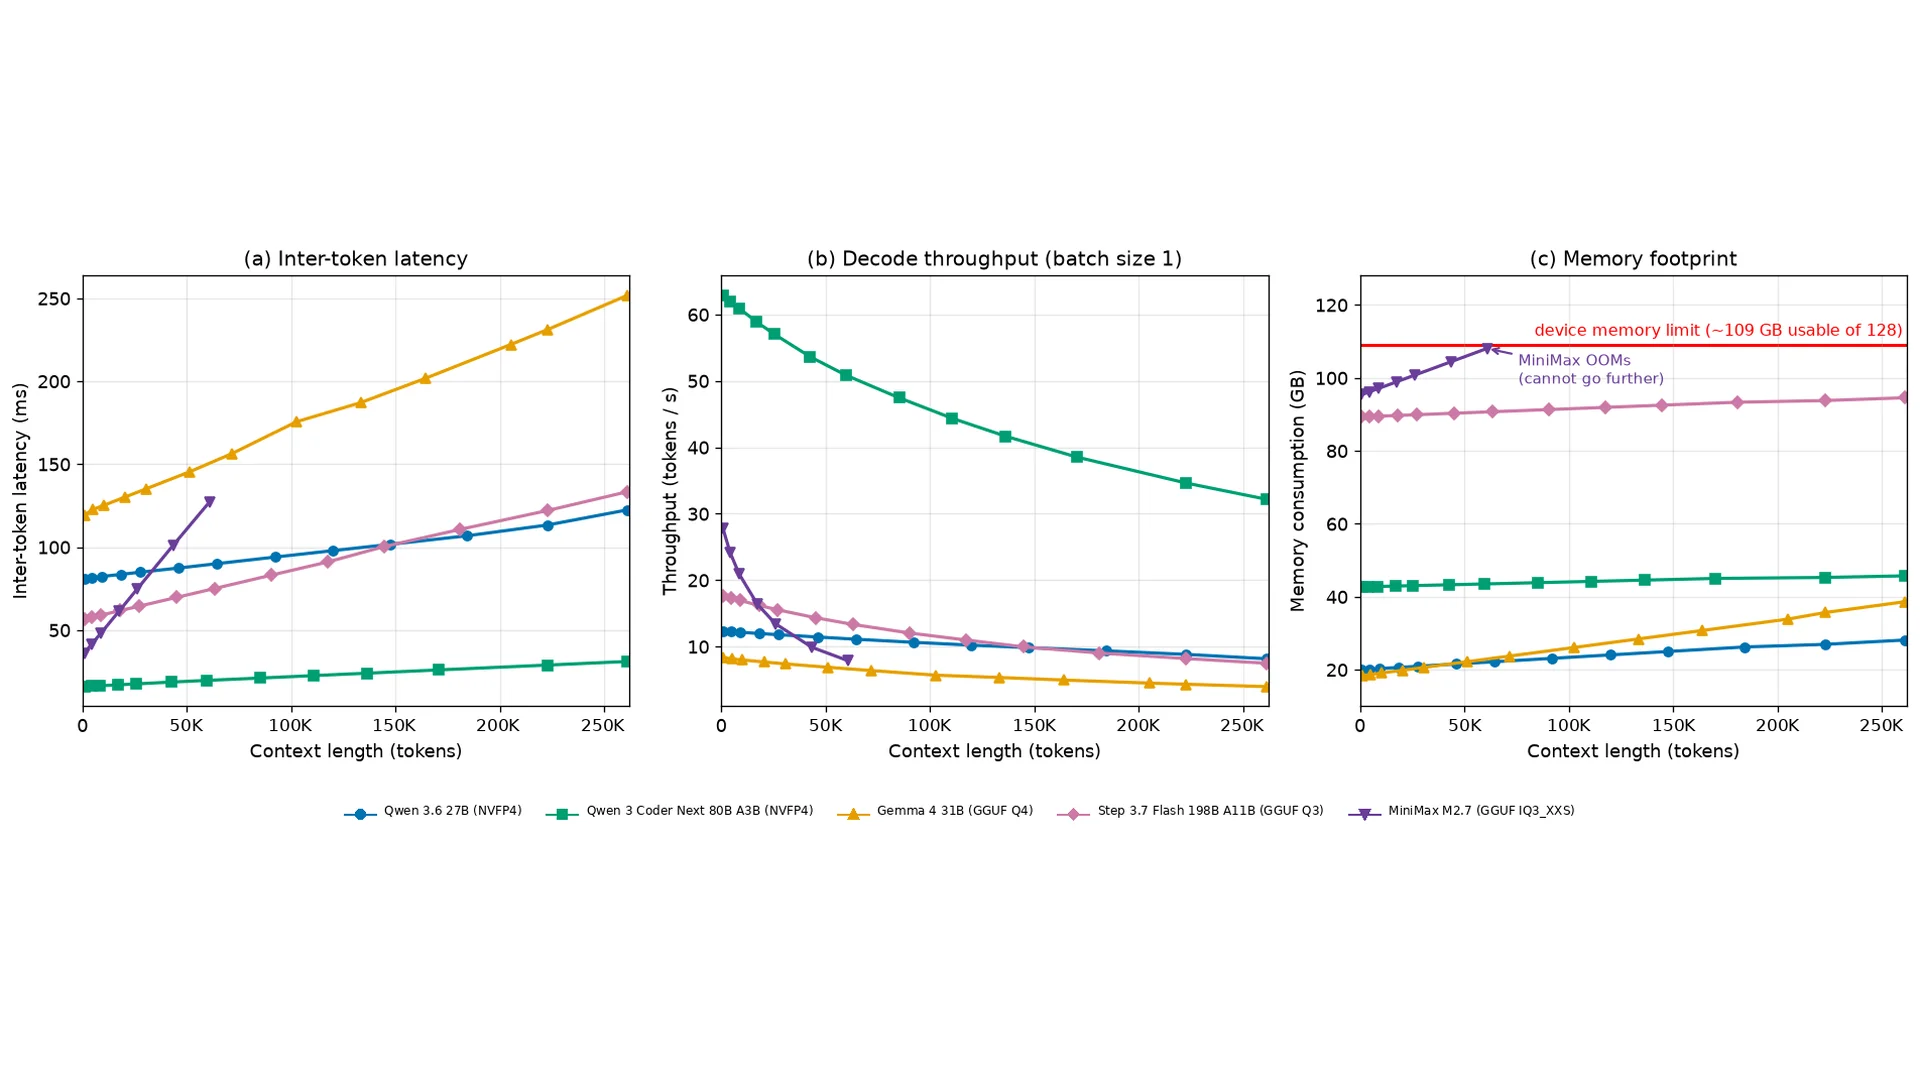
- 本地侧:多款模型在更长输入上,后续 token 延迟可约翻倍,吞吐与显存同步变差。
- RQ1 长程:对 agent 历史做频繁压缩;Opus 4.5 相对基线约 −3.7 到 +5.6 个百分点,且 22 档里多数损失不超过 2 点;估计成本节省约 2.2-8.8×。作者承认可构造「压缩必丢信息」的任务,但可用外置历史 + 选择性读取把需求转成长输入问题。
- RQ2 长输入:用 Bash 等工具选择性读文件,而不是一次塞进上下文;多基准上接近或超过满输入基线,估计节省可更高。
- RQ3 单动作压缩(SAC):Opus 4.5 在 SWE-bench Verified 上约 70.2%(mini 基线 70.0),Terminal-Bench 2.1 约 51.8%(基线 47.2);GPT 5.6 Sol 约 82.4% / 84.3%,略低于其 mini 基线。SAC 下中位峰值上下文约 7-9K,最大从约 130-200K 降到约 15-37K。
- 概念:提出 Semantic State Space Model(SSSM)。在自然语言里维护可解释的语义状态,供下一次独立推理接着干。
证据强度:NVIDIA 作者预印本;基准多为公开套件,压缩与 EoCC/SAC 是作者定义的 harness 改法。成本数字来自吞吐测量 × 云价格,不是某家零售账单。实验室页把该文列为 Local Frontier Intelligence 相关论文之一,但不是单独产品发布说明。
机制上,作者把「长上下文」拆成两类工作负载:长程交互历史累积,与长输入一次性灌入。前者不一定每步都需要全文;后者常可变成「当外部资源 + 按需读取」。标题的冲击来自结果图:短上下文档位上准确率大致持平,而服务成本与峰值上下文显著下降。
钢人论证:若独立团队用相近压缩阈值在 SWE-bench Verified / Terminal-Bench 2.1 / LongBench v2 上复现「基线近端准确率 + 更短峰值上下文」,则论文支持窄结论。至少在这些 agent/长输入设定里,默认维持数十万 token 会话历史并不是完成任务的必要条件,后训练与 harness 应认真考虑短上下文工况。
[1]钢人风险:作者写明证据不能排除「某些任务仍受益于长上下文」,也不能证明「任意任务都可用短上下文解决」。硬币序列一类例子说明:若关键信息只活在会被压缩掉的历史里,准确率必掉。除非外置存储。压缩是有损的;级联压缩会丢更多。闭源模型 API 行为与开权本地测量并不自动等同。标题是论辩句,正文 RQ 才是检验清单。
未找到独立的 NVIDIA 产品博文专页;二次来源用实验室 LFI 页。读者若把「不需要长上下文」读成「1M 窗口营销全假」,就超出了论文实际测量范围。
[1][2]对推理平台与 agent 框架,六个月内可观察的是:默认会话是否仍无上限堆积工具记录;压缩策略是否进入评测报表(准确率、总 token、峰值上下文并排)。对本地/小加速器路线(论文自身挂在 LFI moonshot 下),短上下文直接翻译成更可承受的显存与时延。对模型供应商,窗口规格战之外,需要回答:后训练是否针对「短上下文 + 外置状态」优化过。
[1][2]检验对象应是压缩配方下的准确率与峰值上下文,以及成本倍数是否可复测,而不是标题本身。若复测站住,「不需要长上下文」是对默认长会话的工程反击;若站不住,它仍是一篇有力的预印本论辩。
【No.2】
[1]