
要点
- IBM Research / HF(2026-11-03):Palette——约 20B + LoRA,designer/coder 分工生成服从 IBM Design Language 的甲板;页级并行约 6–7×。
- 数据:约 1000 甲板 / 1 万页教师合成;反事实推理;检查器修复坏页;参考甲板比加规则更能管住忠实性;12 类 [[directive]]。
- PresentBench:Economics/Education 第一,Talk 第三,三域均值第二(59.7 vs NotebookLM 60.8);131 甲板 harness 平均 +3.5。
- 作者承认尚无「是否服从特定设计语言」基准;下一步指向用检查信号做 RL、嵌图与少样本换肤。
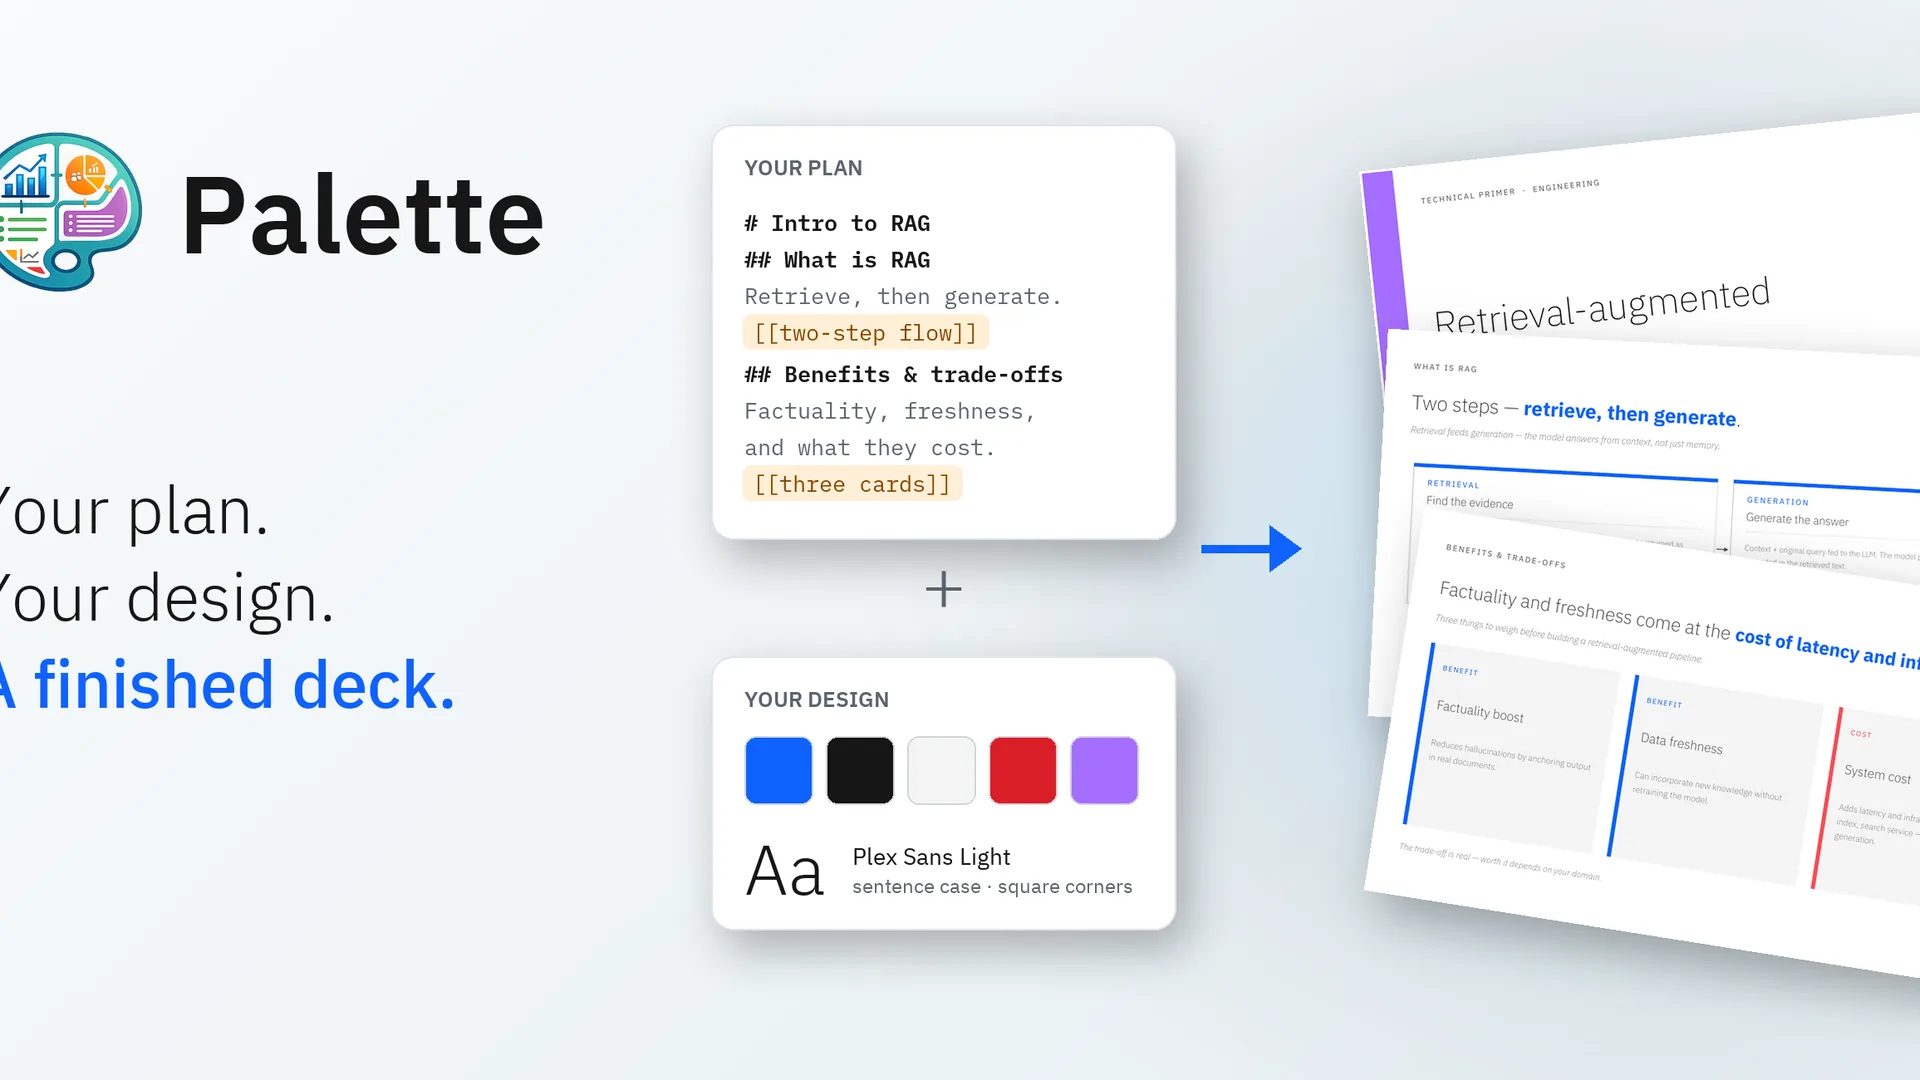
IBM Research 在 Hugging Face(2026-11-03)介绍 Palette:用约 20B 开源权重 + LoRA,在自有设计语言里做幻灯片,并与前沿系统在 PresentBench 上对照。
命题:企业「看起来像我们模板」的幻灯片不是提示词问题;拆成 designer/coder、用反事实合成数据、再加「只在变好时保留」的检修 harness 后,小模型可以在结构化领域追上甚至超过多数闭源系统——同时权重不出域。
[1]发生了什么
小模型常写出叠字、溢出、标题沉进背景。Palette 把人类流程拆成同一 LoRA 上的两个角色:designer 读计划、写出含调色板/字体/每页布局与短设计理由的 JSON brief;coder 按页写 pptxgenjs,并在代码前留下几何推理。页上下文在写码前固定,故可并行,编码阶段约 6–7×。Coder 样本约长 5×,故对 designer 样本 5× 过采样。
数据约 1000 副甲板 / 10,000 页,由大教师按体裁与布局配方合成;推理写成反事实(为何不选表而选柱;62 字符标题为何从 44pt 降到 36pt)。几何检查器与推理时同一套:坏页修复并重写理由。忠实性上,堆提示规则几乎无效,改参考甲板才能稳住教师;[[directive]] 覆盖布局/语气/受众等 12 类。
证据有多硬
PresentBench 评基本功、视觉、完整、正确、保真。源是文档而非计划,故评测时另用前沿模型起草计划,Palette 只负责从计划出甲板。结果:Economics、Education 第一,Talk 第三,三域均值 第二(59.7 vs NotebookLM 60.8),高于其余对照。131 副甲板:harness 平均 +3.5;修复仅在检查器确认变好时保留,因此可默认常开。
作者自承:PresentBench 不测是否服从某一设计语言——而这正是产品卖点,专门基准仍缺。数字来自官方对照表,非第三方复现。
[1]钢人与缺口
钢人:前沿默认审美会漂回「AI 甲板味」;机密内容也不能出域。把可检查的几何信号做成训练数据与 harness,是可迁移到图表与 UI 布局的方法,而不只是一次演示。
缺口:计划由另一前沿模型从文档起草,Palette 吃的是计划不是生文档;训练绑定 IBM Design Language,换品牌需重做数据或换肤流程;Talk 域落后说明叙事/演讲型甲板仍弱;教师合成可能带入风格偏置。把 PresentBench 第二读成「已解决企业设计系统」会过冲。
[1]谁付钱、下一步看什么
付钱的是企业设计系统与对内工具:与其逼 API 模型「像我们」,不如自训小适配器 + 可证伪检查器。下一步作者指向用同一信号做 GRPO 式 RL、Docling 嵌图、以及少样本换肤而不重训。
[1]收束
Palette 可辩护的句子是:在可程序检查的版式任务上,小开源模型 + 合成反事实数据 + 安全检修,足以在结构化 PresentBench 域争先,而不把设计语言交给提示词碰运气。 它尚未证明「任意品牌零样本」或「演讲型甲板已追平闭源」。
[1]