
要点
- FoundationWorlds 把受控仿真环境、自动任务与示范生成、以及随时间跟踪的指标放在一起。ToyBlocks 是第一个:桌上的一只手臂和一批积木,并接续 MolmoAct 2、MolmoBot 与 MolmoSpaces。
- 示范不必由人远程操控机器人来录。短技能在 Nvidia Isaac Lab 里用强化学习和运动规划训练,再由任务与运动规划器串联。单块 GPU 上可并行跑数百条规划,最高约 24 倍实时。
- 首批公开数据:85,336 条长程示范,每条约 6 到 12 个技能,近 1,600 小时、1.44 亿帧,并附训练与评估代码。
- 视觉-语言-动作模型(ManiFlow、π0.5、MolmoAct 2)在作者的初步结果里,对空间内插和外推泛化不佳,尽管它们经过大规模预训练。
- ManiFlow 原子技能在仿真中成功 80.0%,在带 Robotiq 夹爪的 Franka FR3 上为 81.1%。分层的 Molmo 2 加 ManiFlow 三积木拼字:仿真 55.5%(111/200),真机 50.0%(15/30),且用的是最容易的场景设定。Claude Opus 5.5 智能体在搜索并拼写任务上,成功完成或正确判断不可行的比例为 63%。
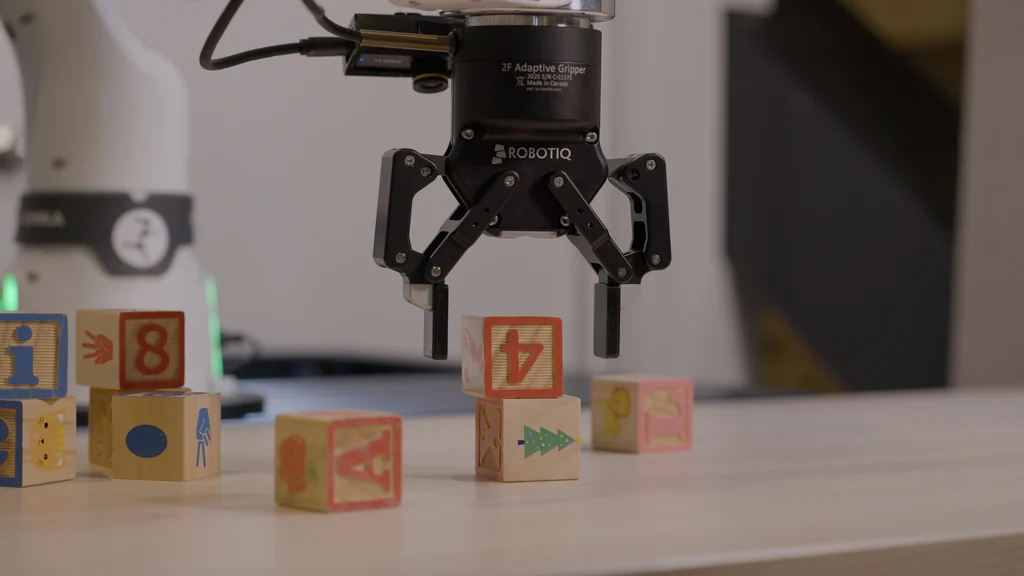
2026 年 11 月 6 日,Allen Institute for AI 发布 ToyBlocks:一个围绕机械臂和桌面积木的开源仿真。这篇博客不是在推销另一段叠衣服视频。它想说的是,机器人学习仍缺少生物学家会叫做培养皿的东西:一个你可以改训练数据或改模型、重新跑测试、并说清机器人为什么失败的小世界。
[1]实际发布了什么
Ai2 把这类环境叫做 FoundationWorlds。每一个都把受控仿真场景、自动生成任务与训练示范的工具、以及跟踪行为的指标配在一起。ToyBlocks 是第一个。桌面看起来简单,但机器人仍要推、翻、堆,还要读积木面上的图画和字母。有时得先把积木翻过来,才知道它该放在哪里。积木尺寸、桌面高度等属性可以逐场景变化,测试的就不是背下来的布局。
真正落地的,是数据流水线。短技能,包括把积木推过桌面、或不抓起来就把它翻到另一面,在 Isaac Lab 中训练。仿真器能直接给出真实机器人没有的信息,例如积木的精确位姿,于是那些在真机上往往要靠人遥操作才能录到的技能,在这里可以自动生成。任务与运动规划器再选择并串联这些技能。规划在仿真里跑一遍,就得到带标签的示范。Ai2 写道,这能在单块 GPU 上并行执行数百条规划,最高达到约 24 倍实时。
高层模型决定下一步做什么,底层动作模型驱动手臂。评估也不只看成功或失败。规划器用的同一套规格,还能报告执行速度、作用在物体上的力、以及任务进展。网页界面可以接上 Claude 或其他前沿模型,让没有机器人背景的人用自然语言下指令,并观看规划过程。
首批数据被写成一个证明点:85,336 条长程示范,每条约 6 到 12 个技能,近 1,600 小时,1.44 亿帧。仿真资产、生成器、基于 Molmo 2 和 ManiFlow 的两个训练好的模型、训练代码和评估集一并公开。作者还说,未来几周会有更大规模数据、更多技能、更完整的基准,以及当前包装里还没有的一体化强化学习训练。
[1]台面上的证据
作者用这个世界分别问了几件事。
在底层动作模型上,他们测试视觉-语言-动作系统如何把指令和相机图像映射成运动。他们引用了相互冲突的既有说法:有研究认为这类模型对布局和光照变化很脆,也有研究认为泛化很宽,而后者常常来自难以干净改变空间条件的真实数据集。在 ToyBlocks 里,他们改变技能顺序、字母与颜色、以及场景中的积木数量。他们区分内插(训练范围内的新布局)和外推(超出该范围的布局),例如训练堆叠高度为 2 和 5、测试 3 和 4,或只在桌子左侧生成物体、到右侧去测。基于 ManiFlow、π0.5 和 MolmoAct 2,他们报告这些常用动作模型在初步结果中泛化不佳,随后在包括低秩适配在内的额外适应后有所提高。他们的结论是:动作模型的泛化远未解决。
在长程规划上,他们让 Molmo 2 做高层规划,下层接 ManiFlow 或运动规划器。一个例子是把积木堆成「Ai2」。难度从字母一开始就正立并朝向相机,升到字母可能不正立,再升到开头时字母被挡住。
在前沿智能体上,他们用 Claude Opus 5.5 研究了三种设定,并通过 Model Context Protocol 暴露 ToyBlocks 技能。在经典堆叠任务中,智能体根据文本描述解决了全部 30 题;在边看相机图像、边选择下一步动作时,同样是 30 题全过。在「搜索并拼写」中,它要从最多八块积木里拼出三个字母的词;一半场景缺了所需字母,正确做法是宣布任务不可行。智能体成功完成或正确判断不可行的比例是 63%。错误主要是认成样子相近的字母(13%),或堆叠里字母朝向不对(15%)。有图案规律的积木可以让它推断被挡住的面,因此不用翻看那么多面。第三种设定里,智能体自己做实验并撰写技能说明。这些学来的说明把成功率从默认文本的 24% 提高到 63%,高于人类专家所写说明的 36%。
他们还把「按动作预测画面如何变化」的世界模型,当作物理仿真器的替代来测:拥有 50 亿参数的视频模型 Wan 2.2;会自己搭物理仿真去拟合示范的 Astra;以及潜变量世界模型 LeWM。每项技能(抓放、翻转、旋转,外加混合任务)有 900 条轨迹,一半成功一半失败,因此一个永远预测成功的模型也只有一半正确率。Wan 2.2 对积木运动和任务结局预测最准。Astra 跟踪夹爪较好,但在接触上吃力。LeWM 在短片段上更强,在完整轨迹上会漂移。从表现最好的视频模型里加入 100 条生成轨迹后,一项策略在未见过区域的成功率从 19% 升到 78%。
迁移数字是怀疑者会记住的部分。只在 ToyBlocks 仿真里训练的模型,被零样本放到带 Robotiq 夹爪的 Franka FR3 上,覆盖三十个场景、每场 4 到 10 块训练中见过的积木。成功标准是把相关积木移到目标位姿且不发生碰撞。操作员因不安全动作叫停,记为失败。ManiFlow 的原子技能(抓、放、翻、转)在仿真中成功 80.0%,在真机上 81.1%。分层的 Molmo 2 加 ManiFlow 系统,在仿真拼字回合中成功 55.5%(200 次里的 111 次),在真机上 50.0%(30 次里的 15 次)。真机分层测试用的是仿真评估里最容易的配置:字母可见且正立。作者写明,要在任务间建立统计把握,还需要更多试验。
[1]钢人与缺口
钢人。叠衣服视频可以让机器人看起来很能干,却说不清它到底学会了什么。如果不能改训练配比、不能留出未训练任务、不能把坏计划和坏抓取分开,收集到的只是轶事。一个狭窄、却同时要求推理和灵巧的世界,是合理的科学赌注,就像 Hodgkin 与 Huxley 从一根轴突开始。自动生成示范,也减轻了稀缺的人类遥操作。原子技能上接近的仿真与真机成功率说明,至少在这张桌子上,培养皿并不是空想。
缺口。视觉-语言-动作模型的空间结果被写成「初步泛化不佳」,但博客正文没有为每个模型和每个分割公布完整数字表。分层真机拼字是最容易设定下的 15/30,作者自己也要求更多试验。Claude Opus 5.5 的 63% 把「正确判断不可行」算进成功,评分规则是对的,头条也会因此比「只算拼成」更温和。世界模型比较只用了每种技能 900 条轨迹的一套微调数据。更大规模数据、更多技能、双臂、带力觉的灵巧手,以及在乱堆积木上的玩耍,都还在后续计划里。按照设计,ToyBlocks 也无法回答洗衣、厨房或街道上的问题。
[1]谁该在意,下一步看什么
训练视觉-语言-动作模型的实验室、出售「通才」机器人策略的团队,以及那些把更多无脚本演示当成学习曲线本身的资助方,都该看这篇。未来六个月看:其他组是否复现空间内插与外推的分割;承诺的更大数据集和一体化强化学习训练是否到来;在更难的隐藏字母场景上,分层拼字是否缩短与原子技能的差距;外部实验室是把 FoundationWorlds 当成一种方法,还是只把它当成 Ai2 的一个仓库。
[1]收束
耐看的句子不是「木积木就是家务的未来」。而是:在失败还能被追溯到训练配比、规划器或动作技能之前,在这些痕迹还没在真实手臂上站住之前,机器人学习就仍是演示集锦。六个月后,要么像 ToyBlocks 这样的受控世界成为讨论泛化的常规方式,要么这个领域还会继续比较那些说不清下一局布局为何失败的精彩视频。
[1]