
要点
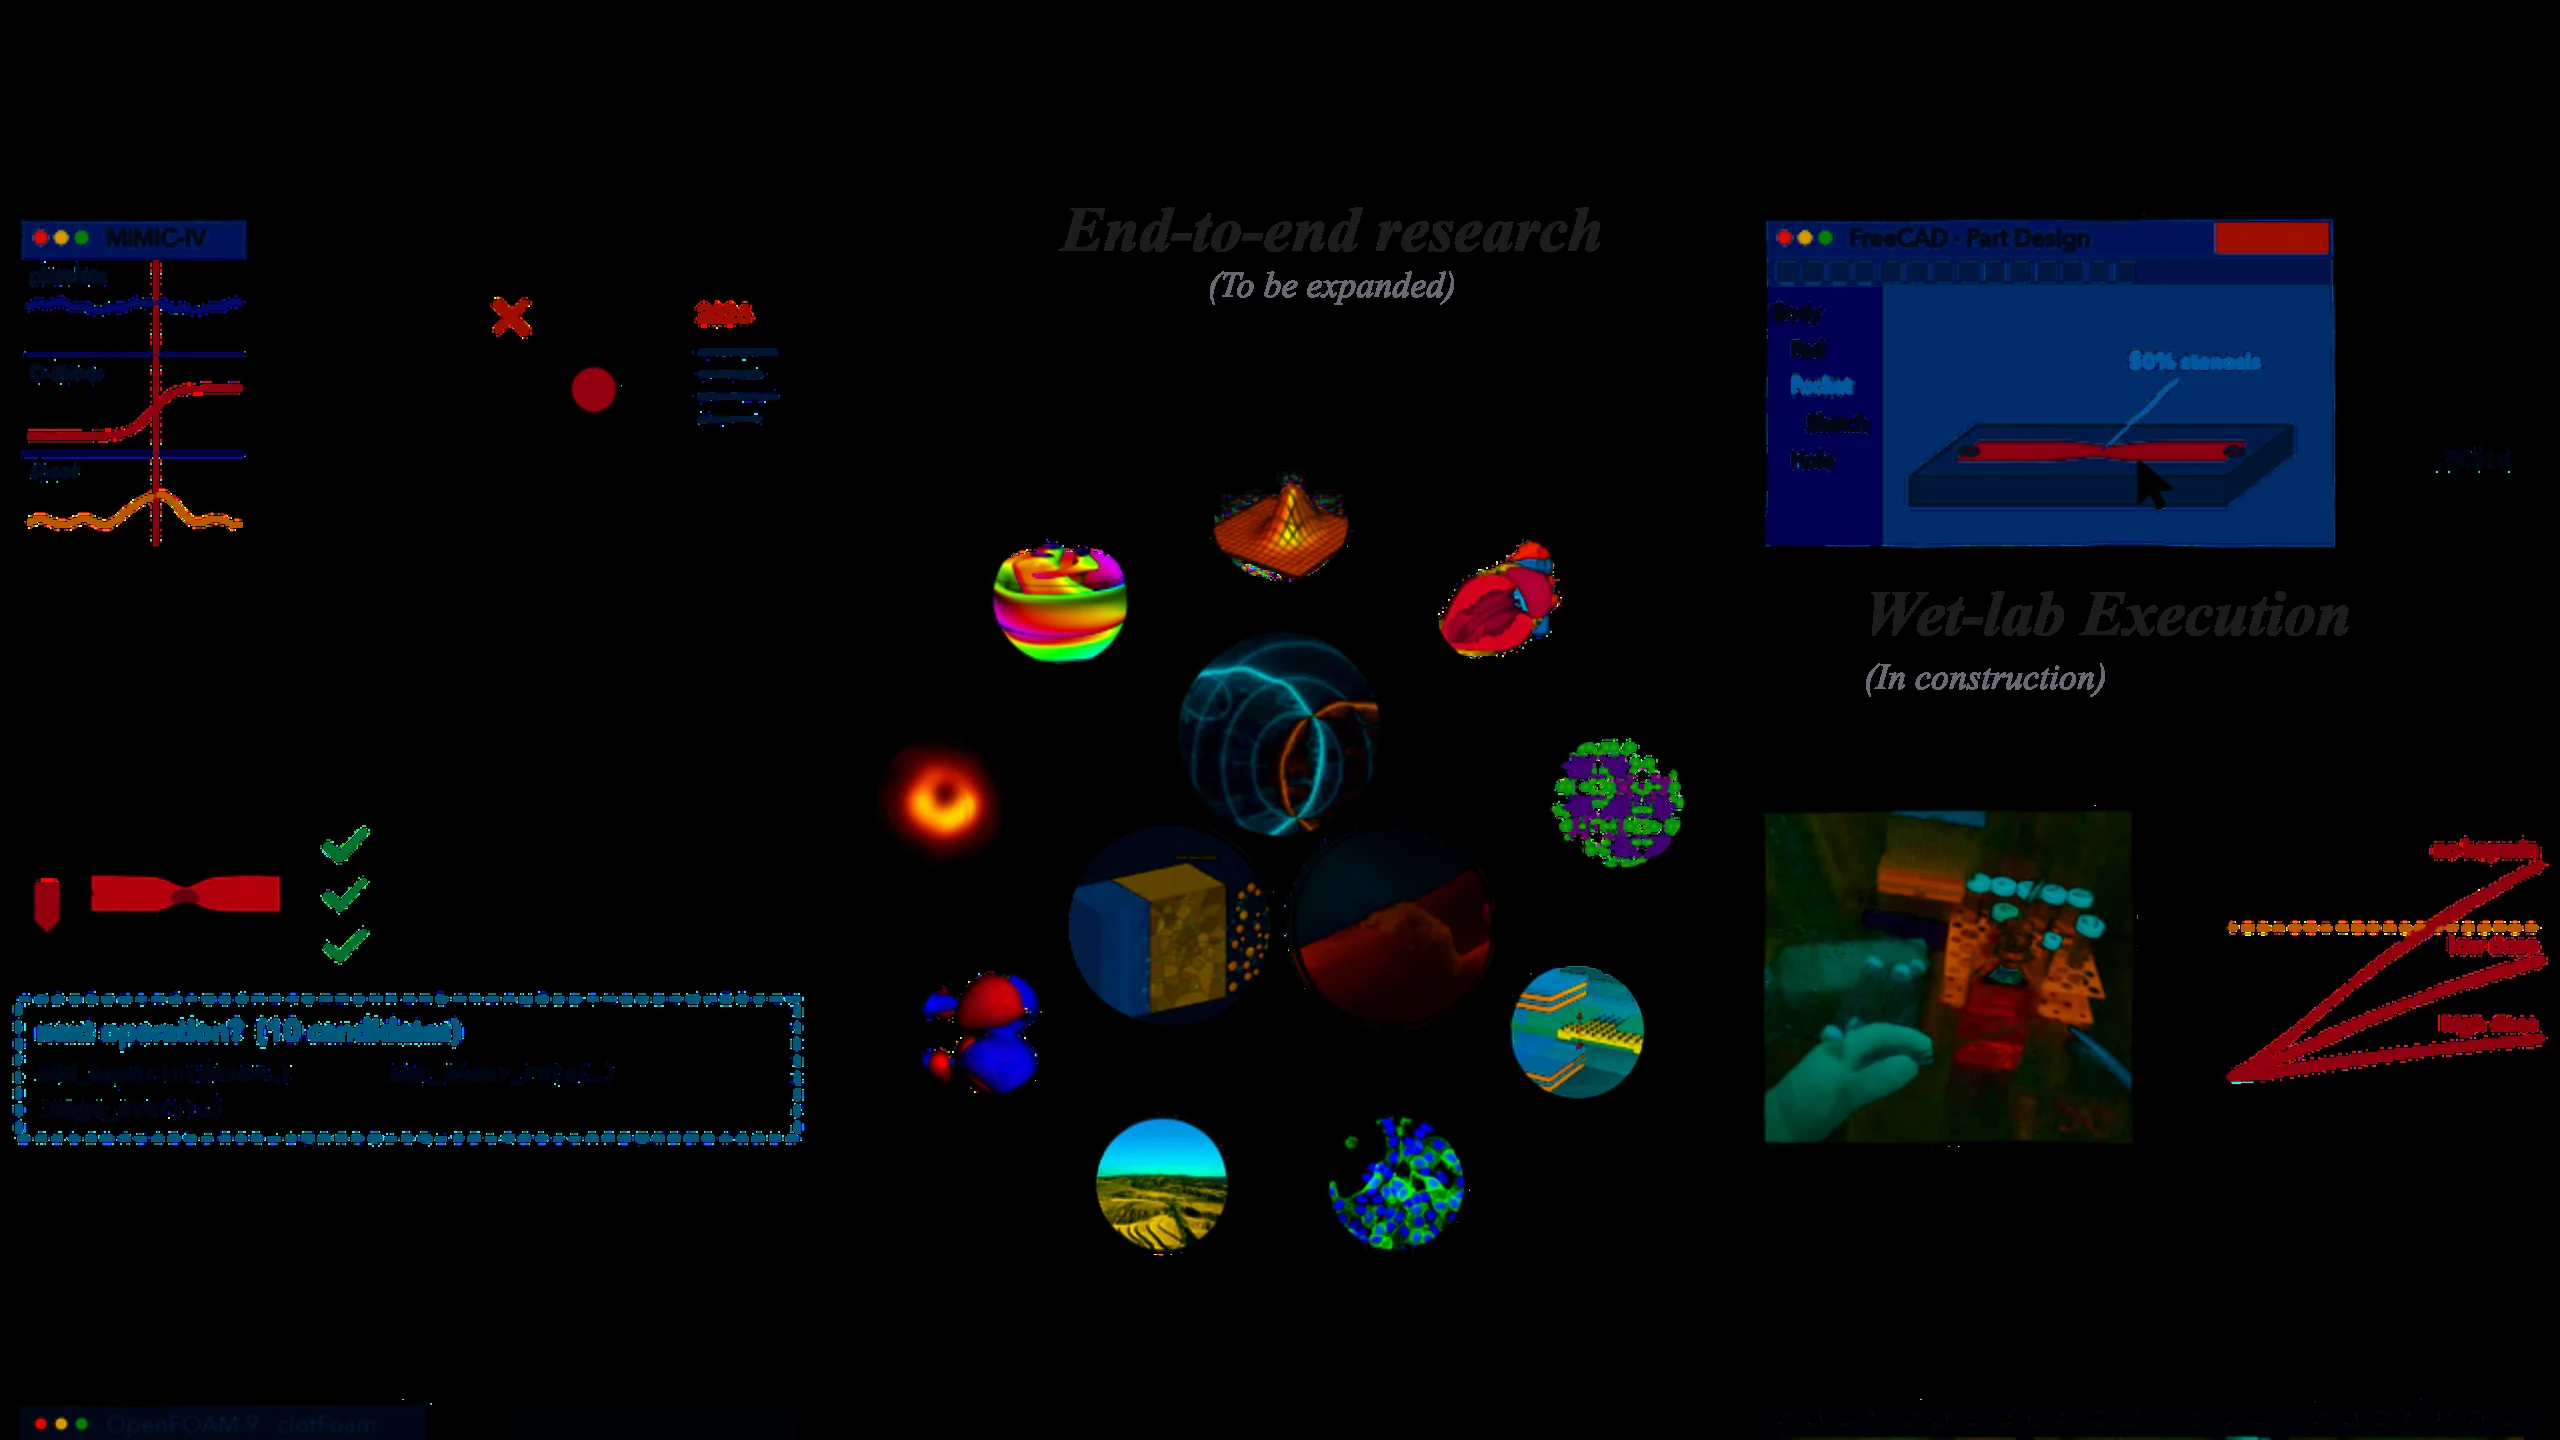
- 规模:113 个公开任务,九学科;六项能力评估加一项端到端科研(端到端标注 To be expanded;Wet-lab Execution 仍在建设、无已发布任务)。
- 榜单(2026-11-04):8 模型;Claude Opus 5 High 综合 37.50;端到端科研对所有已上榜模型为 0。Opus 5.5 与 GPT-6 Astra 因生物护栏显示 N/A。
- 可证伪点是综合分、端到端全 0 与任务计数能否对照公开榜;不是「AI 已经能独立完成科学研究」。
AItonomy Foundation 发起的 Science’s Last Exam(SLE)问的是:给定一个研究目标,AI agent 靠真实工具与材料能走多远。2026 年 11 月 4 日公布的能力榜列出 8 个模型。综合分最高是 Claude Opus 5(High)的 37.50;站点写明,综合分等权纳入六项评估,其中端到端科研对所有已上榜模型均为 0。
这把「会做科研」从口号拆成可核对的分数结构:能力项可以拿分,完整研究闭环目前公开结果是全员零分。Claude Opus 5.5 与 GPT-6 Astra 因提供方生物护栏限制生物学研究流程,榜上显示 N/A,尚未计入。检验应落在这些公开数字,而不是落在「AI 已会独立做研究」的外推。
[1]硬事实(https://sciences-last-exam.org/、/leaderboard、/blog、/docs;榜单标注 Published 4 November 2026;访问于 2026-11-06,上海时区):
- 组织:AItonomy Foundation(美国非营利);任务由 34 所机构的博士生与博士后以个人身份设计与审阅,提及 Stanford、Oxford、Princeton 等。
- 任务:113 个公开任务;九学科为统计、物理、天文、化学、地球科学、生物、工程、材料、医学。
- 框架:六项能力——Hypothesis Discovery、Protocol Planning、Scientific Computing、Scientific Software Operation、Wet-lab Execution、Experiment Observation——加一项 End-to-end research。文档写明 Wet-lab Execution 在建、无已发布任务与分数;End-to-end research 标注 To be expanded,但计入综合分。
- v1 数量拆分(docs):Hypothesis Discovery 5、Protocol Planning 40、Scientific Computing 23、Scientific Software Operation 14、Experiment Observation 30、End-to-end research 1。
- 榜首:Claude Opus 5 / Claude Code / High,综合 37.50,约每任务 19.70 美元、均时约 17 分 31 秒。其后 GPT-6.1 Sol 36.15,Kimi K3.1 Pro 28.92 等。
- 关键规则:综合分等权六项评估,含端到端科研;已公布结果里端到端对所有上榜模型为 0。
- 未评:Claude Opus 5.5、GPT-6 Astra 因生物护栏限制生物学研究工作流,结果显示 N/A;站点称获研究访问批准后补评。
示例任务(博文):在计算模型中为抗血栓药 ticagrelor 选择最低日总剂量与给药间隔,并在不同血管几何、血流与药代反应下站得住。
[1]证据强度:公开榜单、文档与博文构成一手基准说明。37.50 的榜首分、端到端全 0、113 任务与九学科,都可以对照 leaderboard 与 docs 复核。Opus 5.5 / Astra 的 N/A 也有站点自己的护栏说明,不是猜测。
可检验路径:打开 leaderboard 核对 8 模型分数;读 docs 中的任务计数与「端到端计入综合且当前为 0」;抽查一个公开任务包是否真有预留参考与独立校验。若端到端扩展后分数仍被写成「已会独立科研」,应下调外推。
钢人:把能力项与端到端拆开,能避免用文档问答或单点计算高分,冒充完整研究循环。公开写明全员端到端为 0,本身就是少见的诚实信号。
[1]最强钢人:真实研究要在证据与假说之间找缺口、决定下一步。SLE 用预留参考与独立校验器压住「看起来像论文」的空转,比再堆一个选择题基准更贴近实验室失败模式。
钢人风险:端到端目前只有 1 个任务且标注 To be expanded;Wet-lab 尚无分数。综合 37.50 是能力项与一个必为零的端到端槽位的等权平均,读榜时不要忽略分母结构。Opus 5.5 与 Astra 缺席,使「前沿模型」比较不完整。博文举出的 OpenAI 内部数学手稿发布,是动机叙述,不是 SLE 分数本身。
「0 分」指端到端科研槽位,不是所有能力项都为零。榜首 37.50 说明部分能力可得分,完整闭环仍未过线。
[1]对评测与资助方,未来六个月可观察的是:端到端任务是否从 1 个扩容;Wet-lab 是否开始出分;Opus 5.5 与 Astra 在获得研究访问后是否进入榜单;37.50 的榜首是否被打破。对实验室,这提供了一条「工具在手、目标给定、结果可独立核对」的压力测试。
对读者,验收应是公开分数、任务计数与端到端是否仍为 0,而不是「AI 科学家已经上岗」的口号。
[1]SLE 的检验对象应是公开榜上的综合分(目前最高 37.50)、端到端科研对所有已上榜模型为 0,以及 113 任务 / 九学科的框架是否仍按文档运行;不是「AI 已经能独立完成科学研究」。能力项可以得分,完整研究闭环在已公布结果里仍是零。数字结构对得上,它是一次可核对的科研 agent 基准;对不上,它仍是一个野心很大的排行榜。
【No.2】
[1]