
要点
- SuperCLUE 于 11 月 5 日发布 2026 年 11 月的中文取向评测。VIDRAFT_LAB、SeaWolf-AI 与 FINAL-Bench 在 11 月 6 日的 Hugging Face 文章里,抄录了这张 19 模型表,以及 SuperCLUE 给编号列定下的规则。
- 在全部 19 个模型里,总分最高的是 Gemini-4-Argon 的 73.62,其次是 GPT-6.1-Sol 的 71.76,再次是 Kimi-K3.1-Pro 的 61.46。SuperCLUE 的编号列给 Kimi 写了 1,给 Gemini 和 GPT 写的是横杠。
- SuperCLUE 自己的规则,在这篇文章里被复述,官网上也能看到:国际模型和部分国内模型不进入编号名次,只作为参考列出。这就是 Gemini、GPT、Grok 和 Darwin 显示横杠的原因。这是排名惯例,不是漏评。
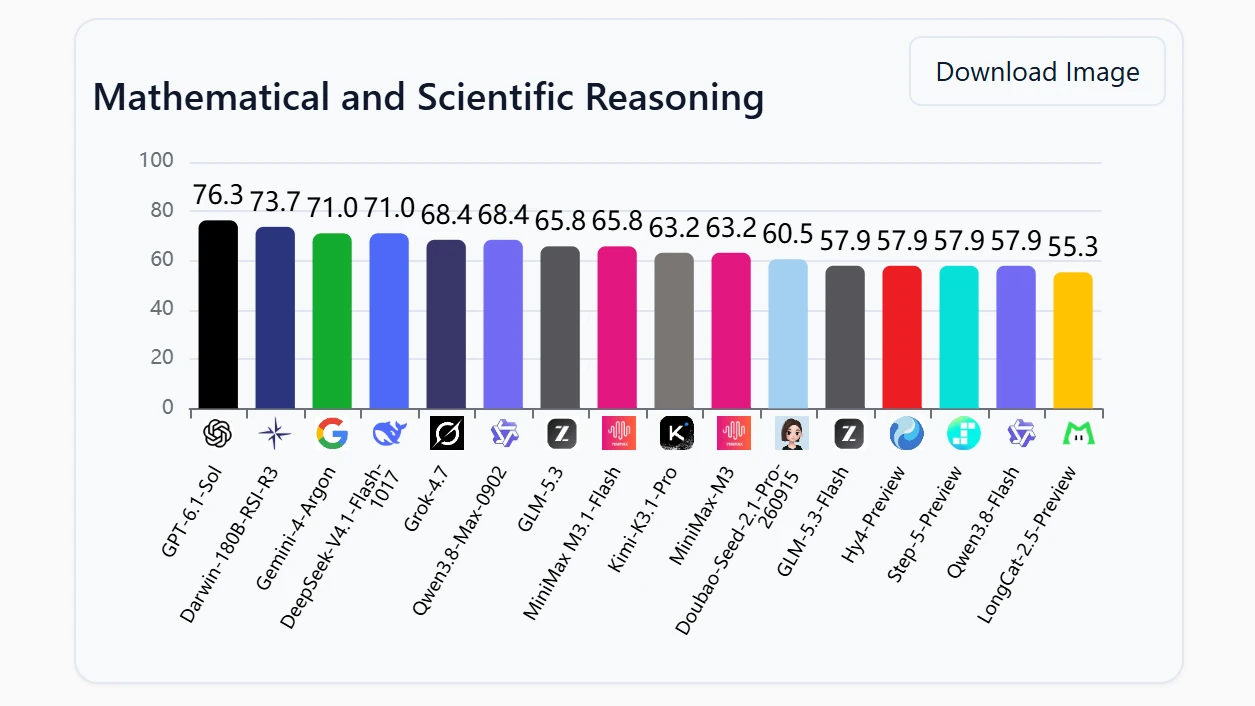
- 19 个模型的分项第一名,和总分顺序并不一致。GPT 在智能体式编程上以 69.23 领先,在数学与科学推理上以 76.32 领先。Gemini 在幻觉控制上以 83.19 领先,在超长上下文上以 95.63 领先,并在精确指令遵循上与 GPT 并列 68.97。
- 在 SuperCLUE 标注为开放的模型里,DeepSeek-V4.1-Flash-1017 在编程上以 65.38 领先,并与 Gemini 持平。Darwin-180B-RSI-R3 在数学与科学推理上以 73.68 领先,列 19 个模型第二。其余三个开放模型分项由 Kimi 领先;在 12 个被标为开放的模型里,Kimi 的总分也最高。
2026 年 11 月 5 日,SuperCLUE 公布了对 19 个模型的中文取向评测。次日,VIDRAFT_LAB、SeaWolf-AI 与 FINAL-Bench 在 Hugging Face 发文,把官方表格和旁边那一列编号名次逐项读了一遍。那一列的第一名是 Kimi-K3.1-Pro。同一张表上总分最高的是 Gemini-4-Argon 的 73.62,其次是 GPT-6.1-Sol 的 71.76。Kimi 的 61.46 按分数排在第三。这个错位来自 SuperCLUE 已经写明的排名规则,不是漏评,也不是某次跑分失败。国际模型,以及部分国内模型,不进入编号名次,只作为参考列出。
[1][2]这张表实际写了什么
公布的表里有 19 个模型,12 个被标为开放,7 个被标为闭源。这些标签是 SuperCLUE 自己的分类。它们不是对许可证、训练数据披露、代码是否公开、或模型能否商用的独立核查。要采购或上线,仍须去读每个模型自己的仓库、模型卡和使用条款。
只看分数,表头很清楚。Gemini 以 73.62 排第一。GPT 以 71.76 排第二。Kimi 以 61.46 排第三,也是 12 个被标为开放的模型里总分最高的,比 DeepSeek-V4.1-Flash-1017 的 58.95 高 2.51 分。Darwin-180B-RSI-R3 以 43.08 排在第 9,略低于 Qwen3.8-Max-0902 的 43.22,略高于 Hy4-Preview 的 42.96。Gemini、GPT、Grok 和 Darwin 在编号名次列里都是横杠。Kimi 是 1,DeepSeek 是 2。
Hugging Face 的作者写明,这道横杠是规则上的惯例,并不表示这些模型没被评,或弱到不够资格排名。SuperCLUE 官网写了同一条规则,并补充:分差在 1 分以内的模型视为并列。所以 Qwen3.8-Max-0902 和 Hy4-Preview 可以共享编号第 5,而分数夹在它们中间的 Darwin 反而没有数字。
[1][2]表上的证据
同一张表,按任务拆开看更有用。这篇文章比较了 SuperCLUE 的五个分项,并在每一项里分别标出 19 个模型中的最高分,以及 12 个被标为开放的模型中的最高分。
智能体式编程,指需要分多步、并调用工具来完成的编程任务。这一项 GPT 以 69.23 领先。开放模型里最高的是 DeepSeek 的 65.38,与 Gemini 公布的编程分相同,比 GPT 低 3.85 分。在开放模型内部,DeepSeek 也比该项次高的 Kimi(57.69)高 7.69 分。只看总分名次的买方,会看见 Kimi 排在 DeepSeek 前面,并错过这次对调。
数学与科学推理一项,GPT 以 76.32 领先。Darwin 以 73.68 排在全部 19 个模型的第二,比 GPT 低 2.64 分,比并列 71.05 的 Gemini 和 DeepSeek 高 2.63 分。这是 Darwin 在此次评测中最强的公布成绩。这篇 Hugging Face 文章的署名里有 VIDRAFT_LAB,而 VIDRAFT 开发 Darwin,因此这项领先应读成 SuperCLUE 表上的一个数字,而不是独立实验室的背书。
幻觉控制测的是模型有多能避免把没有依据的内容说成事实。这一项 Gemini 以 83.19 领先。开放模型里最高的是 Kimi 的 67.78,比 Gemini 低 15.41 分,比 GPT 高 4.17 分。这些数字是基准分数,不是幻觉率。不能把 83.19 换算成 83.19% 的幻觉率,也不能换算成 16.81% 的错误率。
精确指令遵循一项,Gemini 和 GPT 并列 68.97。开放模型里最高的是 Kimi 的 44.83。总体领先者与开放模型领先者之间相差 24.14 分,是五个分项里这类差距最大的一个。文章提醒,各分项的难度和计分方式可能不同,所以这并不自动等于现实能力差距最大。Kimi 和 DeepSeek 在这一项很接近,分别是 44.83 和 43.10。
超长上下文测的是模型处理很长输入文档的表现。这一项 Gemini 以 95.63 领先。GPT 是 88.14,Kimi 是 87.25,GPT 只比开放模型领先者高 0.89 分。长上下文分数也不等于模型支持的最大上下文窗口。能接受很长的输入,并不等于一定能在文章中间可靠地找到一个事实。
[1][2]为什么一个总分名次不是购物清单
合在一起看,开放模型的候选名单要按工作拆开。编程候选应包括 DeepSeek。数学与科学推理候选应包括 Darwin。在 SuperCLUE 标注为开放的模型里,幻觉控制、指令遵循和长文档的候选应包括 Kimi,而且 Kimi 仍是开放模型里总分最高的。如果采购页只抄 SuperCLUE 的编号列,并停在「Kimi 是第一」,上面这些都看不见。
总分应从公布的表格直接读取,不应把五个分项简单平均后再自己算一遍。Hugging Face 的作者写明,他们没有核实 SuperCLUE 的题目定义、评测设置、置信区间(也就是分数可能上下波动的范围),以及如何把分项结果合成总分的公式。本栏同样没有核实这些内容。
[1][2]钢人与缺口
钢人。SuperCLUE 是面向中文场景的基准。给它国内排名所关心的模型编号,并把国际条目放在旁边作参考,是已经写明的选择,不是暗箱。读了那条说明的人,都能看出 Gemini 和 GPT 为什么是横杠。在 SuperCLUE 选择编号的那一组里,Kimi 确实领先;在 12 个被标为开放的模型里,Kimi 的总分也最高。若读者只想在这个总分上找最强的开放模型,这一判断成立。
缺口。这张表只覆盖 19 个模型,不是世上所有模型。开放和闭源是 SuperCLUE 的标签。Darwin 被标为开放,却仍被排除在编号列之外,这与「国际模型不编号」的规则相符,也说明「开放」和「进入编号」不是同一套筛选规则。Hugging Face 这篇文章是对 SuperCLUE 表格和 Excel 导出文件的转述分析。作者里包括开发 Darwin 的实验室,文末一段也在强调该模型的韩国来源。分项数字可以对照 SuperCLUE 的公开首页核对。这些数字背后的方法,单凭这篇文章无法核对。
[1][2]谁该在意,接下来看什么
把 SuperCLUE 的「第一」当成唯一候选的编辑和研发团队,以及要在编程、推理或长文档上挑选开放模型的人,都应该去看分项列。未来六个月可以观察:SuperCLUE 是否继续同时公布按分数降序的表和按规则过滤的编号;其他中文取向的榜单是否采用同样的拆分;买方是否开始要与工作匹配的那一列,而不是标题上的名次。
[1][2]收束
11 月这张表值得当成两样东西一起读:一份 19 个已评模型的分数排序,以及一套按规则拿掉整整一类条目的编号排名。Kimi 可以是 SuperCLUE 编号里的第一,同时按分数排在第三。DeepSeek 可以在总分上落后于 Kimi,同时在编程上与 Gemini 持平。Darwin 可以总分排第 9,同时在数学与科学推理上列 19 个模型的第二。错误在于,把其中任何一件事当成购物清单。
[1][2]