
Artificial Analysis 把这篇文章的日期写成 October 26, 2026。标题说 GPT-6.1 Terra 把成本效率前沿往前推。正文第一句写,OpenAI 发布了 GPT-6.1 Terra,这是 GPT-5.6 以来的第一款 Terra 级模型,并且在不到三分之一的成本上更智能。页面只有这个日期,没有钟点。这句是评测网站自己的概括。后文把智力指数、编程指数和单价拆开,前沿也没有盖住每一个 effort 档位。
[1]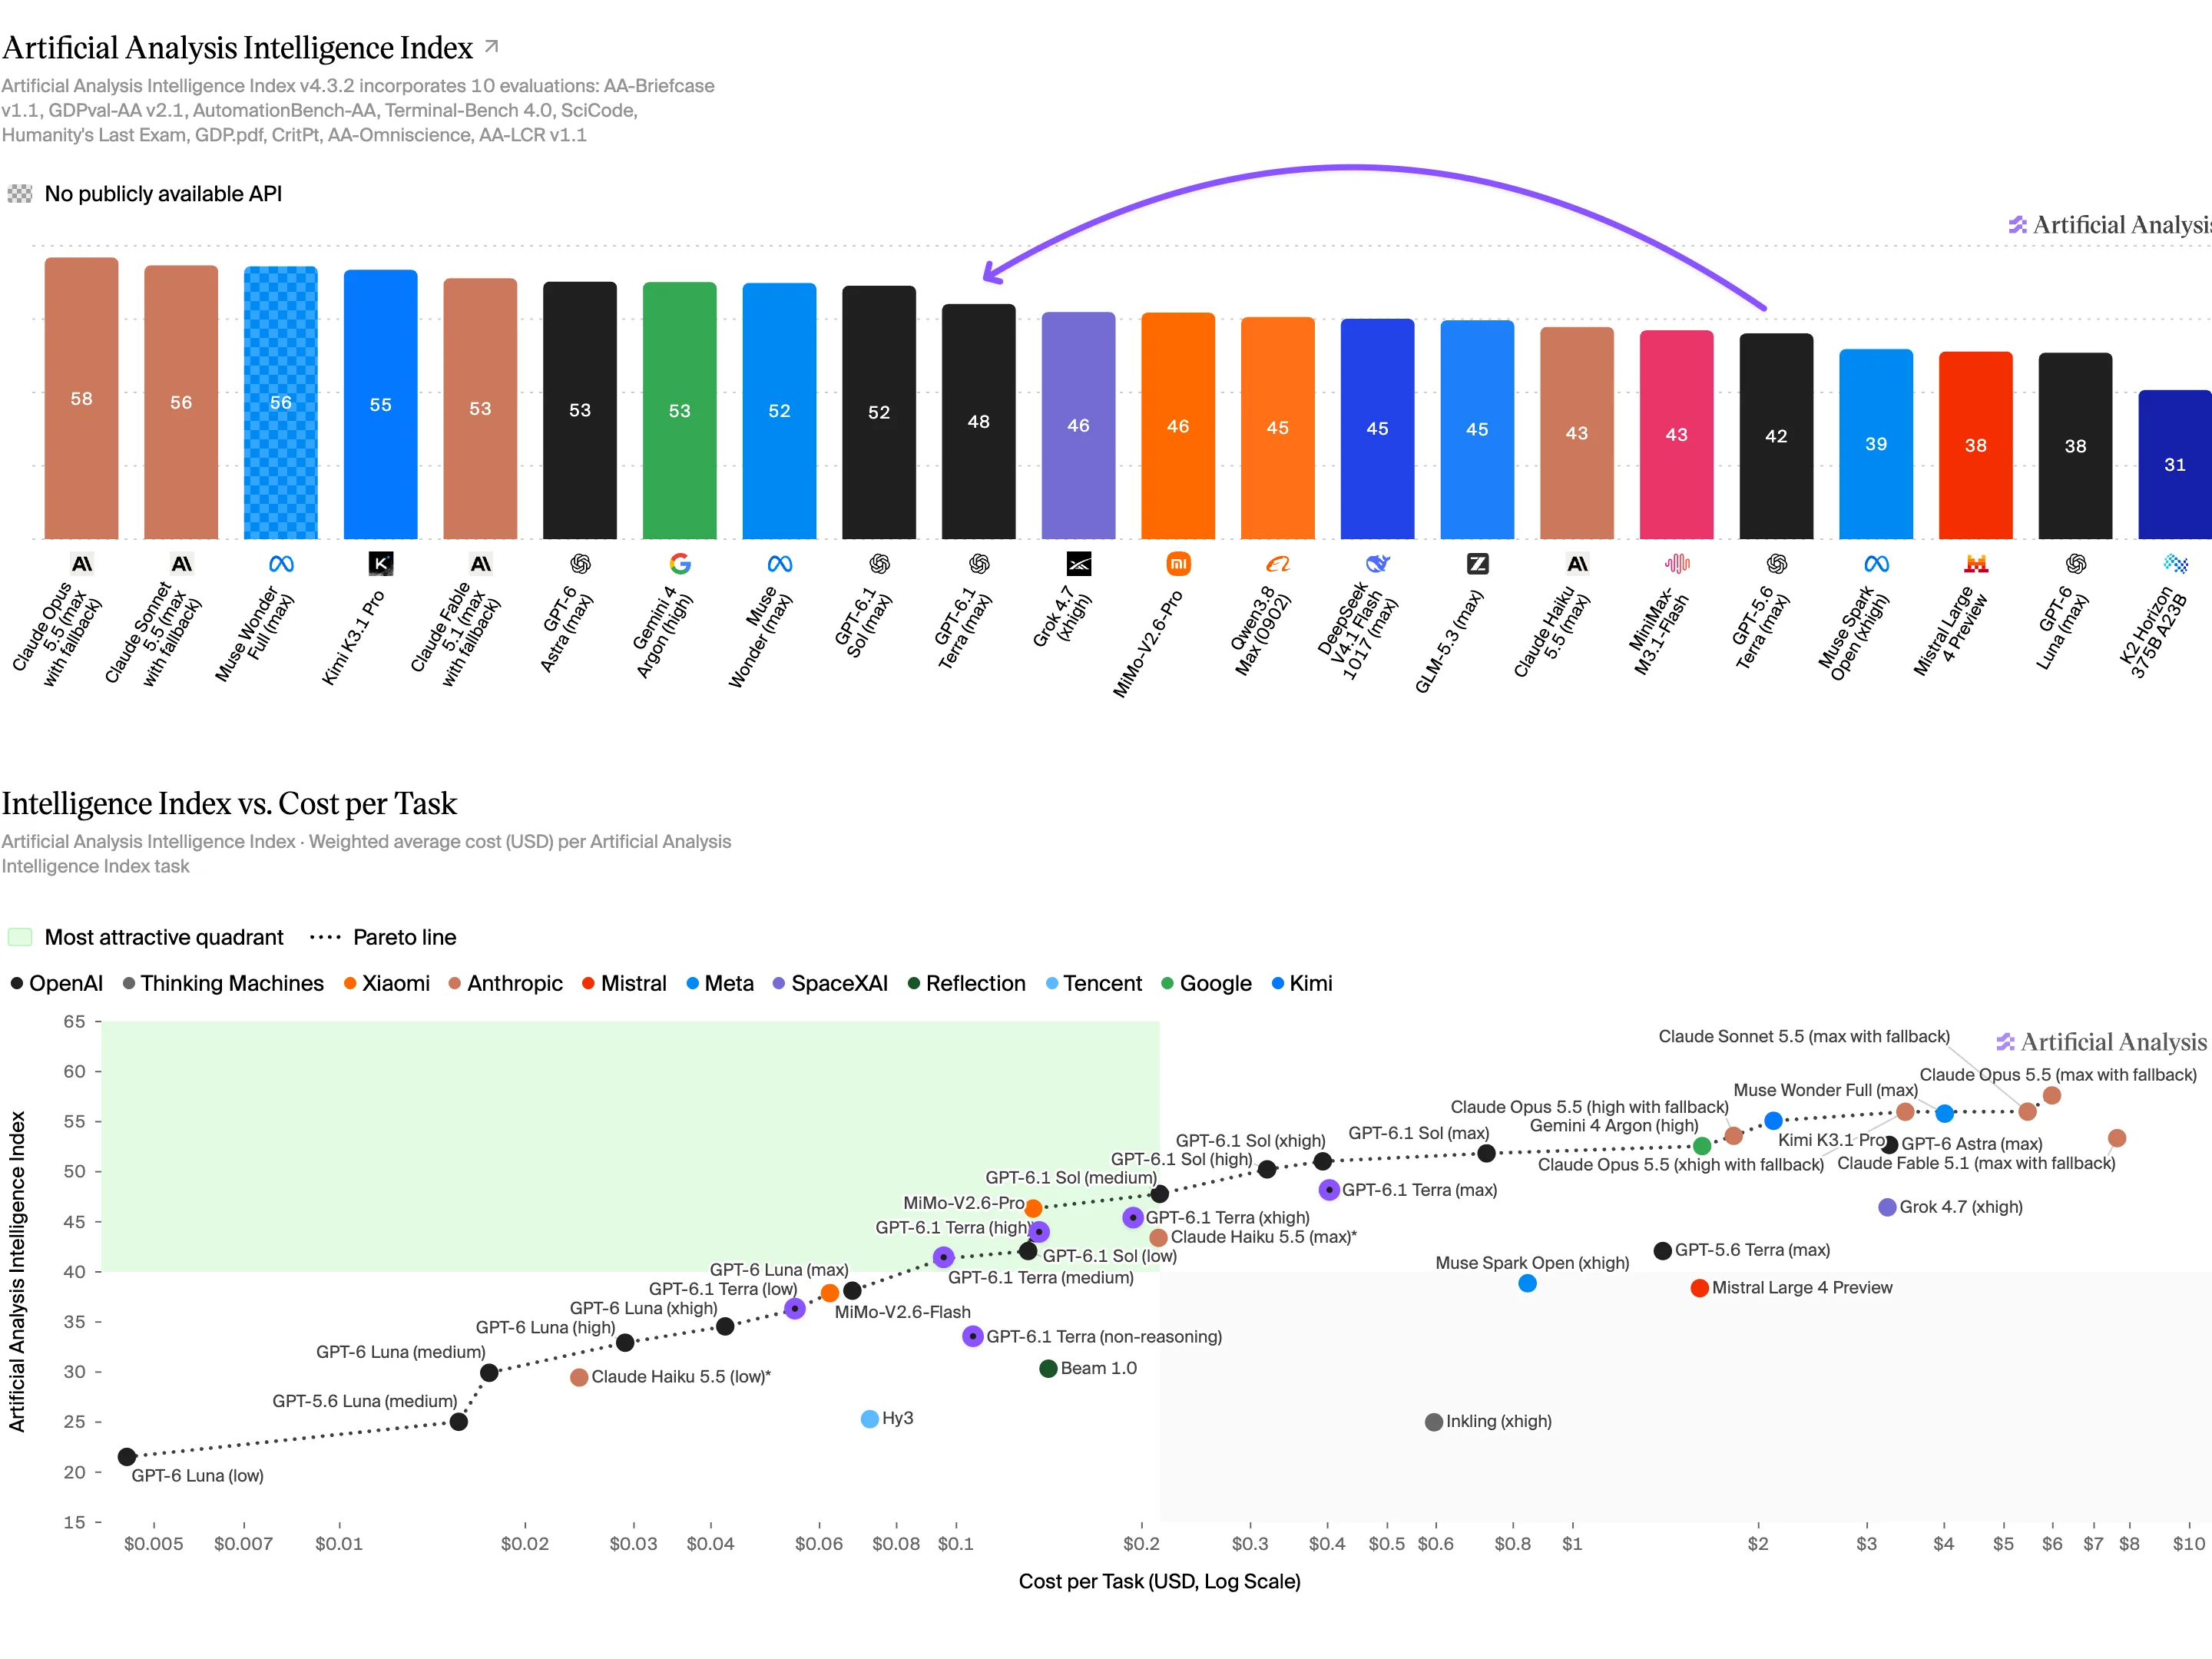
单价被写成 GPT-5.6 Terra 的一半或更低。输入和输出是每百万 token 1 美元和 5 美元,上一款是 2 美元和 12 美元。缓存写入同样被写成减半,现在是每百万 token 1.25 美元。缓存输入是原来的四分之一,每百万 token 0.05 美元对 0.20 美元。这些是文章列出的价格。指数分差是文章自己给出的测量结论。单价只是文章里的一列数字。页面没有附接口回执,也没有写这组价格是在页首那个日期重新核对过的。
[1]在 Artificial Analysis Intelligence Index 上,文章称最大 effort 比 GPT-5.6 Terra 高 6 分,单次任务成本是 0.40 美元对 1.40 美元,不到原来的三分之一。更低的 effort 涨幅更大,在 7 分到 13 分之间。同一段接着把范围收窄:低档和中档 effort 被写成成本效率上的帕累托最优,其余档位落在前沿后面。最大 effort 比 GPT-6.1 Sol 低 4 分,比 GPT-6 Luna 高 10 分。页首那句把前沿往前推,读到这一段,盖住的是低档和中档。最大 effort 在文章给出的单次任务成本里更便宜,文章仍把它放在前沿后面。后文把分项拆解标成 Intelligence Index v4.3.2。文章没有给出 Terra 的绝对指数,只给了这些分差。同一页后文把智力分差、编程分数和幻觉率又写了一遍,复述里仍然没有钟点,也没有绝对指数。
[1]Artificial Analysis Coding Agent Index v2.0 给出了绝对分数。文章写分数是 48,比 GPT-6.1 Sol 的 54 低 6 分,比 GPT-6 Luna 的 31 高 17 分。xhigh 和 low 两档被写成落在编程成本前沿上,其他 effort 在前沿后面。这里点名的档位,和智力指数不是同一组。智力指数写的是 low 和 medium。编程指数写的是 xhigh 和 low。两段都用了前沿这个词。站上去的档位并不相同。
[1]AA-Omniscience 上,文章称模型在不知道答案时仍猜测的比例是 38%,GPT-5.6 Terra 的幻觉率是 88%。文章自己把这个差距写成下降 50 个点,同时准确率高 2 分。这项测试被文章称为自己的非公开知识与幻觉基准。Terminal-Bench 4.0 大约提高 20 分,最大 effort 时接近 GPT-6.1 Sol。多数其他评测涨得更少,文中的例子是 GDP.pdf 高 5 分。大约 20 分没有配上两端的绝对分数。页面也没有写这些指数是不是在页首那个日期跑完的。
[1]