
要点
- ToyBlocks 是首个「FoundationWorld」:窄域机械臂 + 积木仿真,带自动演示、任务与指标;Ai2 计划后续做更复杂世界。
- 首批开放:85,336 条长程演示(每条约 6 to 12 个技能)、近 1,600 机器人小时、1.44 亿帧;数周内计划更大版本。
- 对 ManiFlow、π0.5、MolmoAct 2 的空间测试:在堆叠/拆堆/翻转/旋转的内外插上,主流动作模型初值泛化差,需加 LoRA 等微调手段才改善。
- 分层 Molmo 2 + ManiFlow:最易三字母拼写任务仿真成功率 55.5%(111/200),真机 Franka FR3 为 50.0%(15/30);ManiFlow 原子技能约仿真 80% / 真机 81.1%。
- Claude Opus 5.5 经 MCP:搜索并拼写(或正确判定不可行)成功率 63%;自写技能说明把成功率从默认 24% 提到 63%,高于人类专家说明的 36%。
2026 年 11 月 6 日,Allen Institute for AI 在 Hugging Face 发布《ToyBlocks: A controlled world for robot learning and evaluation》。机器人已经能在演示里叠衣服、分拣零件,但这些片段很少说明策略学到了什么、为何失败。ToyBlocks 主张机器人学需要培养皿:小而可重复的世界里,研究者改数据或模型设计、重跑同一测试,就能看见失败模式。第一刀是桌面机械臂和带字母的积木。耐看的是方法论,不是一台新的家用机器人。
[1]实际发布了什么
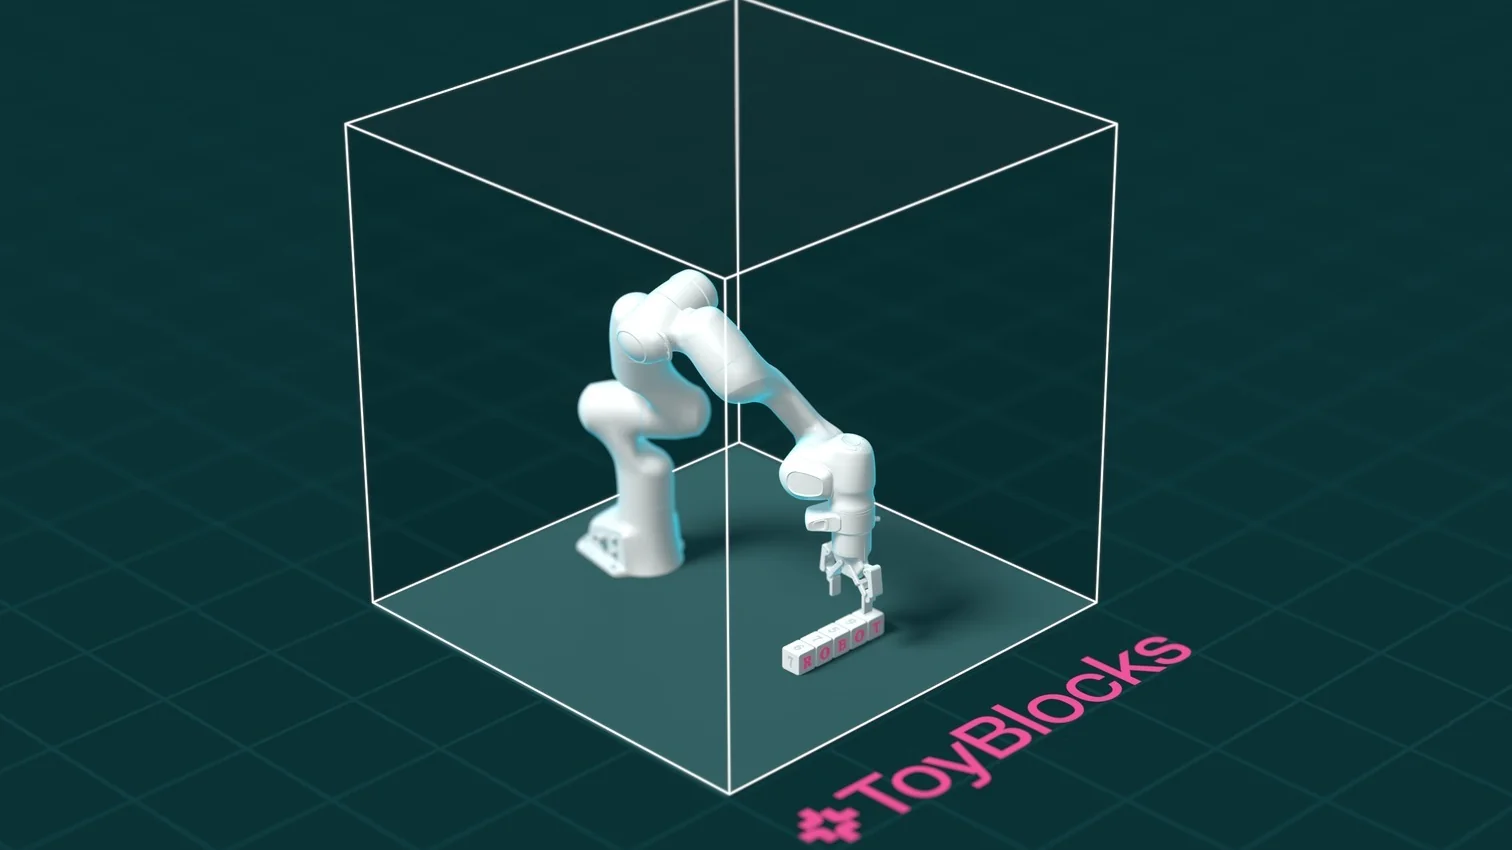
ToyBlocks 被写成首个 FoundationWorld:可控仿真,加上任务与演示生成器,以及随时间跟踪的指标。场景故意收窄,以便同时满足四项要求:物理与外观接近真实、可规模化自动生成任务与演示、任务同时考推理与灵巧、覆盖该域内合理任务。
积木面上有字母与图案,机器人要搜索、翻转、堆叠,而不只是抓取。域随机化会改积木尺寸、桌面高度等。短程技能在 NVIDIA Isaac Lab 里用强化学习与运动规划训练,包括不抓取的推动与翻转。任务与运动规划器编排技能,可在单块 GPU 上并行跑数百条计划,最高约 24 倍实时。高层规划(Molmo 2,或经 MCP 的前沿模型)选技能;ManiFlow 等低层模型执行。网页界面可接 Claude 或其他前沿模型做自然语言试任务。
开放内容包括仿真资产、生成器、演示、Molmo 2 与 ManiFlow 示例模型、训练与评测代码。首批数据含 85,336 条长程演示、近 1,600 小时机器人执行、1.44 亿帧。Ai2 称数周内会有更大第二批,含更多技能与基准,以及更完整的强化学习训练。
[1]台面上的证据
空间泛化研究是对主张最硬的证据。视觉-语言-动作模型常被说成大规模预训练后能快速泛化。ToyBlocks 在堆叠、拆堆、翻转、旋转上测试 ManiFlow、π0.5、MolmoAct 2,区分训练区内插与区外外推,包括左区训练/右区测试、以及堆高留出。Ai2 报告这些主流动作模型初值泛化差,加入 LoRA 等手段后才改善。文中读法:动作模型泛化远未解决,可控世界才是测量该主张的方式。
在 Molmo 2 高层 + ManiFlow 或运动规划低层的三字母拼写长程任务上,字母侧倒或初始不可见时难度上升。真机迁移用 Franka FR3 与 Robotiq 夹爪,三十个场景各 4 to 10 块训练积木。ManiFlow 原子技能仿真成功率 80.0%、真机 81.1%。分层系统在最易配置上仿真 55.5%(111/200)、真机 50.0%(15/30)。作者写明还需更多试验才能建立统计信心。
Claude Opus 5.5 经 MCP 工具的代理实验:经典文本与闭合回路堆叠达 30/30。搜索并拼写、最多八块积木且一半场景不可行时,代理成功解决或正确判定不可行的比例为 63%。主要错误是形近字母(13%)与字母朝向错误(15%)。代理用自跑实验写出技能说明后,成功率从默认说明的 24% 升到 63%,高于人类专家说明的 36%。世界模型测试里 Wan 2.2 对积木运动与任务成败预测最好;从最佳视频模型加入 100 条 rollout,把未见区域策略成功率从 19% 提到 78%。
[1]钢人与缺口
钢人。 一桌木块不是厨房。批评者可说 FoundationWorlds 用缩小世界换干净指标,失败显得很「科学」。真机分层样本只有 30 个回合。前沿模型数字绑在 Claude Opus 5.5 与特定 MCP 技能集上。Hugging Face 上的发布仍是在推销开源栈。
公允点在于:培养皿的价值是对照,不是场面。此前关于 VLA 脆弱与稳健的冲突研究,常用空间变化有限的真机数据;ToyBlocks 直接对准这一设计缺陷。本报告中原子技能的仿真到真机差距很小,这是其他实验室可攻击的可核对主张。近期可证伪检验:别的团队能否在放出的评测集上复现点名 VLA 的左右外推失败;分层 50% 真机率在预注册更大规模试验下是否站住。
[1]谁该在意,下一步看什么
仍靠更多遥操作小时买规模的机器人实验室与资助方,应问自己的评测能否像 ToyBlocks 的 oracle 那样拆开规划失败与控制失败。宣传 VLA 泛化的模型厂商应公布 ToyBlocks 式内外插切分,而不是只报熟悉演示上的成功率。关注「自写工具文档的 AI 科学家」的安全与产品团队应注意:此处学得的技能说明胜过专家文本,能力与审计问题一起上升。
未来六个月:承诺的更大数据与强化学习包;独立实验室是否确认 VLA 外推失败;FoundationWorlds 是否如草图走向双臂与力觉手;世界模型 rollout 是否仍是抬高未见区域成功率的便宜手段。
[1]收束
ToyBlocks 最强读法是测量赌注。六个月后,要么其他实验室用这类可控世界证明哪些数据配比真正修好空间外推,要么领域继续交出漂亮演示,失败模式依旧说不清。
[1]