
要点
- 小米开源 MiMo-V2.6 Pro/Flash,把 RSI 叙事锚定在可验证复杂任务上的规模化强化学习。
- 六天 Live RL:Flash 与 Pro 训练成本约 85 万与 262 万美元,累计约 75 万条轨迹,样本外 DeepSWE v1.1 明显提升。
- API 价格沿用上一代,同等智能水平下约为海外模型的 1/20 至 1/60,开源正在稀释前沿能力的定价权。
- 开源交付覆盖 7k+ RL 任务环境、端到端训练框架与可组合 Harness,训练配方进入公地。
当业界仍在争论规模化预训练是否见顶时,小米用一场持续六天的 Live 强化学习实验给出了另一种回答:智能的下一跳,可能不在更大的语料堆里,而在更长、更难、可被验证的交互轨迹中。
Xiaomi MiMo-V2.6 系列(Pro / Flash)发布并开源。它不只是又一个开源权重包——这是一次把 RL 算力扩展与**递归自我改进(RSI)**叙事写进公开训练日程的尝试。对 Anthropic、OpenAI 等前沿实验室而言,真正值得关注的不是榜单分数本身,而是开源阵营正在用可复现的工程路径,逼近过去只属于闭源阵营的训练范式。
[1]事件:六天 Live RL,训练成本写进公开日程
MiMo-V2.6 的发布节奏本身具有新闻性。团队将 RL 训练过程以 Live 形式公开:不到 6 天,Flash 与 Pro 的训练成本分别约为 85 万美元与 262 万美元,各完成 30 步,累计约 75 万条轨迹。
结果侧,训练任务平均通过率相对提升 25%(Flash)与 12%(Pro);样本外长程软件工程基准 DeepSWE v1.1 分别提升约 17 分(48.8 → 65.68)与 14 分(58.4 → 72.57)。这组数字同时展示了 RL 的样本效率、持续改进能力与样本外泛化——把可复现性从口号变成了交付物。
[1]RL 算力扩展的三条轴
批量与吞吐
- 关键做法
- 单次更新 1,568 样本;1M 上下文;单步 Token 2.7–3.7B
- 作用
- 把 RL 从小灶推向工业化流水线
任务与环境
- 关键做法
- Code / General / Visual / Cyber 多任务,混合多个 Harness
- 作用
- 迫使策略在未见框架上保持泛化
Grader 算力
- 关键做法
- Group 内相对比较,服务 Long-Horizon 奖励信号
- 作用
- 形成自我改进闭环并压缩完成路径
技术路径:RSI 不是玄学,而是可度量的扩展
小米将本次 RL 算力扩展拆成吞吐、任务复杂度与 Grader 算力三条轴。在稳定性侧,团队冻结 MoE Router 以抑制专家负载漂移,并建立覆盖奖励设计、对抗性评测、异常检测与验证器交叉校验的 Reward Hacking 防线。统一轨迹表示、控制面/数据面解耦、混合批次配比优化——这些工程细节往往决定大规模 Agentic RL 是“能训完”还是“训到崩”。
专栏判断: 小米对 RSI 的表述相对克制——不是宣称模型自我改写权重,而是强调“可验证复杂任务 → 规模化 RL → 持续拓展边界”的递归循环。这种定义更接近社区可检验的研究纲领。
[1]从 Vibe Coding 到 Vibe World
3D 开放世界游戏
- 代表能力
- 多智能体场景搭建、交互逻辑、视觉验证与迭代
- 产业含义
- 游戏/仿真内容生产成本可能下移
Blender 3D 建模
- 代表能力
- 文字/图片生成可用于动画、打印、游戏的资产
- 产业含义
- 设计工具链 agent 化
具身智能
- 代表能力
- 多视角视觉闭环控制 Franka Panda 机械臂
- 产业含义
- VLA 与软件 Agent 能力合流
Computer Use
- 代表能力
- 复杂 GUI 与办公生产力工具操作
- 产业含义
- 直接对标 CUA 赛道产品化能力
科研与创作:通用推理正在吞下专业化任务
科研侧两个案例值得前沿实验室注意:其一,材料 Co-Scientist 围绕 PFAS 吸附的 MOF 设计,完成文献/专利梳理、假设提出、新颖性评估,并调用开源计算工具做“干实验”筛选;其二,在研究员探索策略引导下,模型协助完成 Li–Yorke《周期三蕴含混沌》主定理的 Lean 4 完整形式化,约 6000 余行源码通过内核核验,且未接受 Lean 专项后训练。
创作侧(前端/PPT、端到端视频、管弦乐 Demo)则指向另一信号:审美与工程正被同一套优化目标拉齐。Design Arena 上与 Claude Opus 5、GPT-5.6 Sol 接近的表述若属实,说明“好不好看”正在从软性评价变成可优化指标。
[1]智能—成本曲线:开源模型最锋利的武器
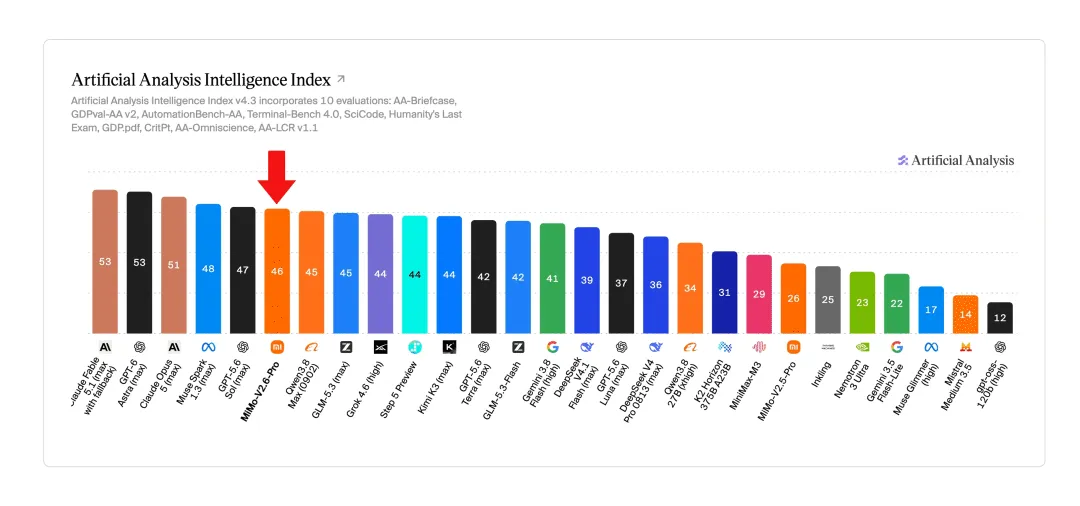
官方口径下,MiMo-V2.6-Pro 在 Artificial Analysis Intelligence Index 取得 46 分,超过 Kimi K3 与 Qwen3.8 Max,成为当前最强开源模型;与最强闭源仍有差距。但真正的产业冲击力来自定价结构:沿用 V2.5 API 价格,智能提升、价格不变。在同等智能水平下,价格约为海外模型的 1/20 至 1/60。
这意味着两件事:对企业买家,开源权重 + 极低推理成本 + 可本地化部署,正在把前沿能力从订阅制产品变成可嵌入基础设施;对前沿实验室,差距仍然存在,但差距的定价权正在被稀释——客户会开始用“单位任务成本”而不是“品牌安全感”做采购决策。
[1]开源交付:把训练配方也交出去
本次开源不止模型权重与技术报告,还包括 7k+ 高质量 RL 任务环境(软件工程、漏洞复现、知识型工作、网页设计开发)、基于 verl / uni-agent / mini-swe-agent 的端到端 RL 训练框架,以及支持 Multi-Harness Training 的轻量可组合 Harness。
以 MiMo-V2.6-Distill-Qwen-9B 为起点的复现数据同样公开:SWE-bench Verified 61.1→66.2,MiMo Cyber Bench 31.3→47.0,Terminal Bench 2.1 37.1→52.8,MiMo Visual Coding 64.0→72.4——11 项评测均较 SFT 基线提升。
这是对前沿实验室的间接提问:当任务环境、奖励管线与 Harness 组合方式都进入公地,闭源优势还能在多长时间内仅靠更大集群与更密闭的数据飞轮维持?
[1][2]对前沿实验室的三点启示
1. RL 算力扩展正成为新的差异化战场。 预训练规模竞赛并未消失,但叙事重心已转向更长交互、更可信奖励、更强样本外迁移。
2. 可验证性是 RSI 的入场券。 把 RSI 锚定在可验证复杂任务上,回避了权重自我重写等更激进主张,也让 Reward Hacking 防御与验证器交叉校验成为一等公民——与可扩展监督的研究对话空间反而变大。
3. 开源正在复制能力前沿的轮廓。 轮廓复制不等于峰值超越,但足以改变市场结构。竞争焦点将转向延迟与吞吐、垂直集成,以及企业级可控与合规。
[1]夫夷以近,则游者众;险以远,则至者少。容易复制的是权重与演示,难以复制的是把算力投进真实环境、让模型在反馈中试错的耐心与工程。