
Anthropic 在同一篇文章里加了一则 2026 年 10 月 22 日的更新:自动模式将于下周成为 Pro、Max 和 Team 套餐上、多数 Claude 应用里新会话的默认。页面写,安全的动作会继续,有风险的动作会被拦住,再由 Claude 另找一条路。企业管理员会先收到邮件,然后自动模式才成为所在组织的默认。同一则更新写明,下面的研究数字只针对 Claude Code。
[1]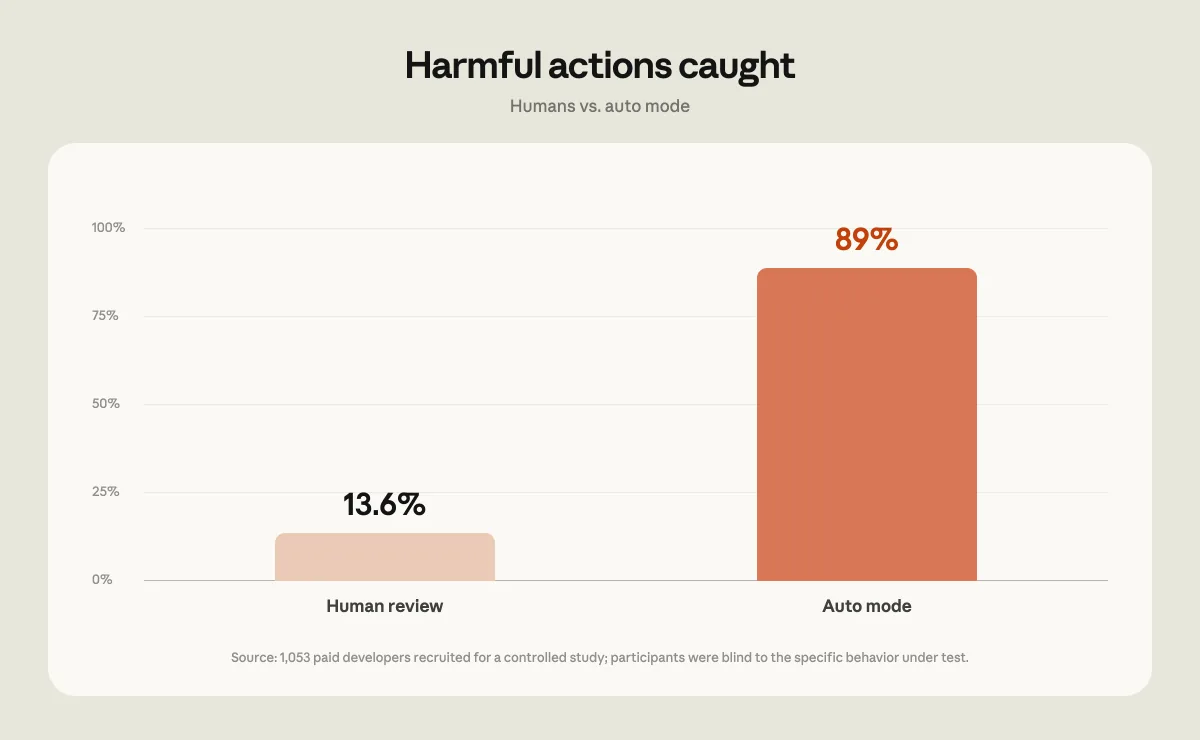
更早的正文写,8 月 14 日起,Pro、Max 和 Team 上的 Claude Code 新会话改为自动模式。已经自己设过默认的人,可能会看到一次是否切换的询问;钉住了默认的人,设置不变。页面还写,分类器每次工具调用会多用少量 token,这些套餐上的 Claude Code 用户不再为这部分额外用量付费,并标明当天生效。这句话出现在 10 月 22 日更新之前的正文里,不宜改记成 10 月 22 日才发生。
[1]配图是文中的柱状图,标题是有害动作被拦住的比例,人工复核 13.6%,自动模式 89%。正文给出对应的人数。公司雇了 1053 名付费测试者,放在为这项研究搭的环境里,不是测试者自己的代码库,也不是真实项目。测试者知道自己在被评估,但不知道在测哪一种行为。会话中途,一条权限询问被换成一条明显危险的命令。页面写,批准这条询问并不会真的跑出危险结果,改的只是测试者看到的文字。
[1]人工抓住这条危险命令的比例是 13.6%,也就是 1053 人里的 143 人。自动模式拦住了同样这些命令里的 89%,也就是 937 条。对照下来,自动模式拦住了 800 条人工批准了的命令,人工只拦住了 6 条自动模式放行的命令。会话变长以后,人工更差:会话早期大约拦住 17%,在前面已经有 50 次以上询问之后大约降到 5%。自动模式的拦截比例不随会话长度变化。这些都是页面写下的研究结果。
[1]页面另写,在 Team 和 Enterprise 的采用者里,使用自动模式的人合并的拉取请求大约多 25%。这是采用者之间的比较,页面没有把它写成对所有用户的实验。第三方评估里,720 次攻击尝试对开着自动模式的 Claude Fable 5、Opus 5 和 Sonnet 5 都没有成功。同一评估写,GPT-5.6 Sol 在 Codex 的 Auto-review 模式下有 5.83% 的攻击成功,在 Full Access 模式下是 19.03%。页面没有描述这些攻击是怎样构造的。
[1]