
月之暗面在 2026 年 10 月 24 日推出 K3.1 系列的第一个模型 Kimi K3.1 Pro。IT之家页顶时间是 2026/10/24 7:08:43,正文写发布发生在当天凌晨。这一页称它是迄今能力最强的 3 万亿级参数模型,支持 100 万上下文。官方博客日期是 2026-10-24,没有钟点,并称它是迄今最强的 3T 级开放权重模型,上下文为 100 万 token。高速版 Kimi K3.1 Pro Highspeed 同时推出。IT之家写高速版同等智能,输出速度约 2 到 3 倍。官方博客只写速度是 K3.1 Pro 的 2 到 3 倍,没有再写同等智能。IT之家列出的入口是 kimi.com、Kimi App、Kimi Work、Kimi Code 和 Kimi API。官方页列出的是 Kimi.ai、Kimi Work、Kimi Code 和 Kimi API。完整权重将于 11 月 4 日前发布,英文写的是 by Nov 4,文件还不能下载。官方页写,企业管理员可以打开它,发布时访问默认关闭。
[1][2]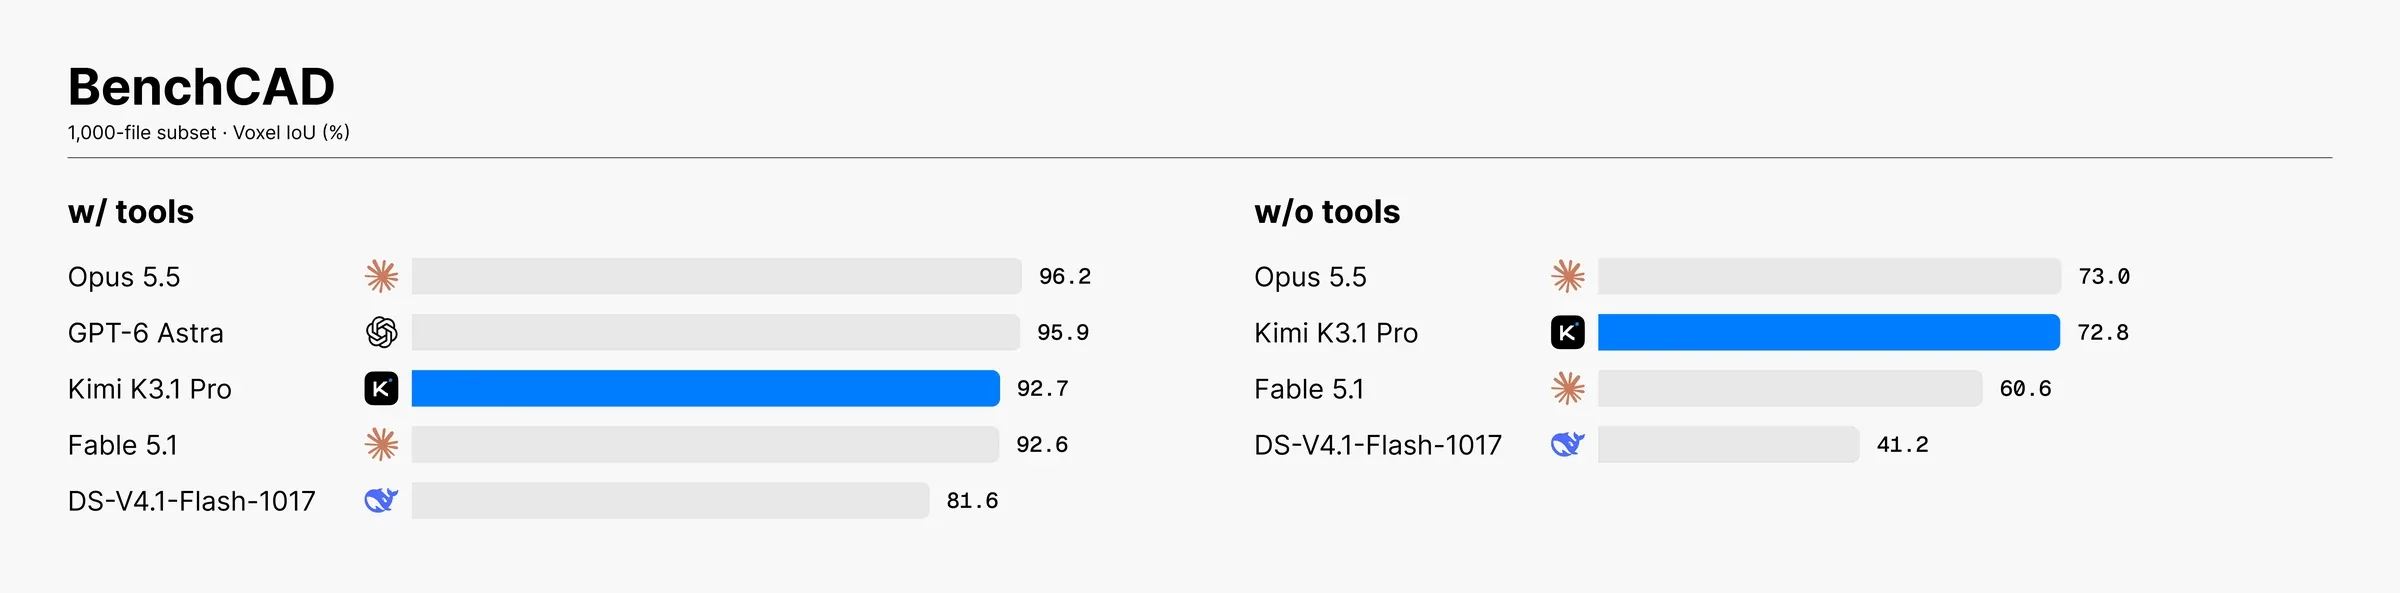
两页印出的几项分数可以对上。Terminal-Bench 4.0 用真实、资源受限的终端任务考察编程智能体。K3.1 Pro 得分 65.7%,高于 GPT-6 Astra 的 58.2%,略低于 Claude Opus 5.5 的 66.4%。官方脚注写,这一项使用 Claude-Code 评测具,其余分数取各自博客或官方排行榜里较高的一个。除非另有说明,推理强度为 max,温度为 1.0,top-p 为 0.95。内部基准 Kimi Code Bench 3.0 Long-horizon 考察多步执行和端到端解决问题。K3.1 Pro 得分 61.2%,K3 为 55.95%。
[1][2]BenchCAD 通过生成 CAD 代码,从多视角渲染图重建三维模型。带工具时 K3.1 Pro 得分 92.7%,官方写接近 Claude Opus 5.5 的 96.2% 和 GPT-6 Astra 的 95.9%。开放模型评的是从 17,900 例 Vision2Code 中随机抽出的 1,000 例子集。带工具用 Claude Code 评测具,不带工具是按官方提示的单次生成。配图是官方博客上的这张成绩图,两种设置放在一起。
[2]OfficeQA Pro v2 得分 64.4。这项基准用真实金融文档做复杂分析,包括检索、跨文档核对和多步数值推理,官方称这是当前最优成绩。Kimi Hallu Bench Hard 是事实准确性的内部压力测试。单条事实错误率从 K3 的 23.4% 降到 8.3%,至少含一处事实错误的回答约为前代的 42.4%。页面写明,样本集中在容易出错的情形,不代表日常整体错误率。
[1][2]财务三项不能收成同一个数字。官方博客写,财务建模比 K3 高 7.2 分,金融研究高 11.6 分,商业运营大约是 K3 的 4.2 倍。IT之家写的是建模提高 14%,研究提升 20%,运营约为 K3 的 4.2 倍。4.2 倍两页相同。14% 不是 7.2 分,20% 也不是 11.6 分。两页不是同一套单位,百分比也不是官方分数的译文。
[1][2]接口价格只取 IT之家印出的人民币。模型 kimi-k3.1-pro 每百万 token 输入为命中缓存 1.3 元、未命中缓存 13 元,输出 68 元。高速版输出速度约 2 到 3 倍,价格为 2 倍。官方页没有钟点,时间以页顶 7:08:43 为准。权重写了日期,文件还没有公开。页面没有附上原始记录。
[1]