
DEEP Robotics 通过 GlobeNewswire 发出通稿,Markets Insider 转载了全文。页面可见时钟是 Oct. 24, 2026, 08:20 AM,同一页的结构化发布时间是 2026-10-24T14:20:39Z。08:20 AM 旁边没有印时区。通稿公布五块研究,支撑它命名的具身架构 DEEPRobotics-Brain,对象是会变化的真实环境。五块分别是世界模型 DR-WM-1.0、具身基础模型 DR-VLA-2.0、策略优化框架 DR-APO、具身智能体 DR-Agent,以及数据与评测平台 DR-Benchmark。合作者写明来自麻省理工学院、加州大学圣迭戈分校、伊利诺伊大学厄巴纳-香槟分校、清华大学、浙江大学、香港科技大学和北京理工大学。这些是通稿列出的机构和名称,不是另一家实验室另行发表的复测。
[1]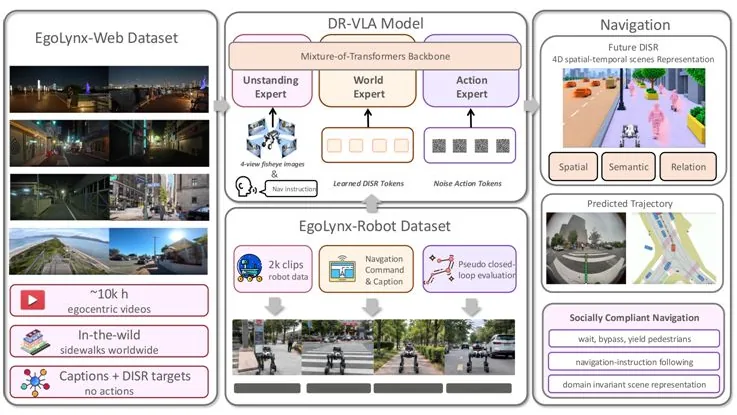
通稿里写得最清楚的真机结果在 DR-APO,由 DEEP Robotics 和浙江大学开发。在具身视觉导航的后训练里,它把预训练 NavDP 的仿真成功率从 70.33% 提高到 89.55%,增加 19.22 个百分点。在公司的 LYNX M20 轮足机器人上,真机导航成功率从 25% 升到 65%,增加 40 个百分点。同一节还写,五项 MuJoCo-v5 连续控制任务里,扩散策略的十组比较有九组 DR-APO 最好,流匹配策略的十组比较全部最好。这些名次是通稿所说的研究内部比较,而且写明不靠推理时用评判模型在多个候选动作里挑选。高斯策略则写成仍与 Soft Actor-Critic 接近。页面没有写真机这 65% 来自多少次试验,也没有写场地。
[1]DR-VLA 的对照同样是通稿自己的。在留出的 EgoLynx-Robot 测试划分上,DR-VLA 把四足导航分数 QNS 提高大约 5%,并把开环最终航向误差降低 14.6%。两处都是相对该指标上最好的对照结果。QNS 被写成综合安全、指令遵循、舒适和进度。数据上,通稿写 EgoLynx 包含 10,000 小时整理过的第一人称网页视频,以及 2,000 段遥操作的机器人导航片段。小时数和片段数是公司对这套数据的描述。配图是通稿的 Figure 2,图上标了约一万小时的第一人称视频和两千段机器人数据。
[1]其余测量也停在通稿自己的数字上。DR-WM-1.0 使用 258 万组图像与掩码配对,以及超过 10 万段真机片段。雨雪后巡检变电站只是示意,不是已经公布的巡检成绩。操作框架 AMC 的相反原子分离率,单原子提示是 92.5%,双原子提示是 83.1%。没见过的布局上,真实双臂任务的归一化进度到 87.8%。加上力反馈后,抽屉与插头任务是 78.5%,擦花瓶是 75.2%。通稿写这些相对被测基线有改进,基线包括微调过的 π0.5。LynxScenes 用 LYNX M20 采集,覆盖 833.6 小时和 3,294.7 公里。EvoWorld-Bench 有 54 个仿真场景、803,680 个任务实例,以及大约 239,000 次动态状态变化。通稿写导航成功和搜索效率相对基线有改进,但没有给出提高的点数。
[1]预印本放在 DEEP Robotics 开发者中心的研究栏目,网址写在页面上。通稿没有写这些预印本已经完成独立同行评审,也没有写另一家实验室复现了真机成功率从 25% 到 65%。转载页写明内容由 DEEP Robotics 提供,并声明不核实所载信息是否准确。五块研究被放在同一个架构名下。页面没有说它们已经作为一套可交付的产品,在客户现场持续运行。
[1]